


Easysearch
Easysearch 布尔查询子句重排序(四)|Block-Max、实战与验证
Easysearch • INFINI Labs 小助手 发表了文章 • 0 个评论 • 5600 次浏览 • 2026-09-29 19:06
Block-Max WAND 块级剪枝、混合查询端到端追踪、Profile API 亲手验证
INFINI Easysearch 是一款专注于企业级场景的分布式近实时搜索与分析引擎。它以 Apache Lucene 为内核进行了增强,在保持与行业主流搜索协议及开发生态完全兼容的同时,重点强化了安全性、稳定性、压缩率及信创兼容性。
引言:从标准 WAND 到块级剪枝
前三篇我们走完了 Easysearch 布尔查询优化的前半程:第一篇讲 rewrite 11 条规则,第二篇讲合取的 cost 排序,第三篇讲析取的 WAND 算法——用 maxScore 上界 + 三堆调度,把"上界够不到及格线的文档"在打分前就剪掉。
但标准 WAND 留了个明显短板:每个子句的上界是全局的——"这个词在全索引最多能打多少分"。游标走到低分文档区,上界仍按全局最高估,剪枝不够激进。本文就围绕这块补全,并把前面所有内容串起来做实战和验证:
- 一 Block-Max WAND——把全局上界换成"按块分段"的上界,整块低分文档一次跳过
- 二 实战——MUST + SHOULD 混合查询的端到端追踪,看前几篇内容怎么协作
- 三 Profile API——用对比实验亲手验证 WAND 生效,避开常见误读
- 四 开发者启示
- 五 全系列总结
一、Block-Max WAND 的增强
1.1 一个类比:为什么全局上界会"过乐观"
想象一场考试,每个学生最多能考 100 分。现在老师想知道"有没有人超过 90 分"。
- 标准 WAND 的做法:每个学生头顶都贴着"100"(全局上限)。老师得把所有人都叫过来核对,因为光看标签谁都"可能"过 90。
- 聪明的做法:把学生按班级分组,每个班只记一个"本班最高分"。如果某班最高才 60,整班直接跳过,不用一个个核对。
Block-Max WAND 就是这个"按班级分组"的做法。倒排链在物理存储上本来就是分块的——Lucene 把每 128 篇文档压缩成一个 block(ForUtil.BLOCK_SIZE = 128),写入时顺手记下"这个 block 内最高能打多少分"。这个分段级上界比全局 maxScore 紧得多——因为它只看本 block 的数据,不会被远处的高分文档带偏。
一句话区分:标准 WAND 的上界是"这个词在全索引最多能打多少分";Block-Max 的上界是"这个词在当前这个 block最多能打多少分"。后者永远 ≤ 前者,所以更容易触发剪枝。
1.2 分段上界 vs 全局上界:一张图看懂
                  标准 WAND                 Block-Max WAND

            ┌──────────────┐        ┌────────────────────────────────┐
   docID    │全局上界=9     │        │块0 doc 0-127   max=9  高分段    │
     ↑      │不管游标到哪    │        ├────────────────────────────────┤
            │上界都是=9     │        │块1 doc 128-255 max=5  中分段    │
            │              │        ├────────────────────────────────┤
            │              │        │块2 doc 256-383 max=2  低分段★   │
            └──────────────┘        └────────────────────────────────┘

   及格线 = 8,游标已进入 Block 2(低分段):

   标准 WAND:上界估 9(全局),9 ≥ 8 → 不剪,逐文档查
Block-Max:上界估 2(本块), 2 < 8 → 跳过整个 block两种策略的对比一目了然——同一个及格线 8、同一个 Block 2:标准 WAND 还用全局 max=9 估计,以为"可能过线"就逐文档查(保守);Block-Max 用本块 max=2 估计,一眼看出整块无望直接跳过(激进),一次比较换掉 128 次 advance。
1.3 源码层面:三个动作怎么串起来
Block-Max 在标准 WAND 之外多调了两个底层方法,理解它们的名字就抓住了主线。这两个方法由每个子句的 Scorer 实现(如 TermWeight 内部的 ImpactsScorer),WANDScorer 通过自己的私有协调方法 WANDScorer.updateMaxScores() 把它们串进三堆调度:
advanceShallow(target)—— "浅推进"。只跳到 target 所在的 block 边界,不逐文档解码。开销远低于真正的advance(target),相当于"瞄一眼那个班的最高分标签"。getMaxScore(upTo)—— 返回"当前 block 内"的最高分上界。这是上面图里max=2那个数的来源,比全局 maxScore 紧得多。updateMaxScores()—— 协调者:游标进入新 block 时,用上述两个方法重算每个子句的分段 maxScore,替换掉之前用的全局值,重新累加上界。发现 tail 上界已经够线,就把高分 essential 子句推进到 head 去实际查。
三者配合后,第三篇 §3.7 那张状态图右侧的 tailMax 数值会逐 block 变小——因为用的是分段上界而不是全局上界,更容易跌破及格线。
1.4 最底层:ImpactsDISI 的块级跳过
分段信息从哪来?写入索引时就备好了。Lucene 的 Impacts 数据结构在 flush 阶段为每个 block 预计算"本块内各 (freq, norm) 组合对应的最高分",查询时由 MaxScoreCache(MaxScoreCache.java:72-78)读出来。
真正执行跳过的是 ImpactsDISI。它内嵌一个 minCompetitiveScore,每次游标要 advance(target) 时先做一道判断(ImpactsDISI.java:68-100):
upTo      = maxScoreCache.advanceShallow(target);   // 找到 target 所在 block 的末尾 docID
maxScore  = maxScoreCache.getMaxScoreForLevelZero(); // 本块分段上界
while (maxScore < minCompetitiveScore) {             // 本块最高分都够不到及格线
    target = maxScoreCache.getSkipUpTo(...) + 1;     // 直接跳到下一个可能有戏的 block
    upTo     = maxScoreCache.advanceShallow(target);
    maxScore = maxScoreCache.getMaxScoreForLevelZero();
}
in.advance(target); // 只在"有戏"的 block 内才真正推进效果:跳过的单位从"单个文档"升级到"整个 block(128 篇)"。一次 advanceShallow 比较,省掉最多 128 次 advance。
名词对照:
advanceShallow/getMaxScore/Impacts/ImpactsDISI/MaxScoreCache是源码里的正式名字;"分段上界""块级跳过""block"是本文用的通俗说法,指的是同一回事。
1.5 剪枝的反馈闭环:从"猜"到"越来越准"
把第一章的几层串起来看,剪枝是一个自适应加速的闭环:
   Collector 收满 K 个结果
        │
        │  setMinCompetitiveScore(kthBestScore)
        ▼
   WANDScorer 收到及格线(抬高)
        │
        │  ① matches():用 lead+tail 的 maxScore 上界跳过低分候选
        │  ② updateMaxScores():用分段上界替换全局上界,上界变紧
        ▼
   ImpactsDISI 收到分段级 minCompetitiveScore
        │
        │  整个 block 最高分都 < 及格线 → 跳过 128 篇
        ▼
   迭代更快 → 更快碰到高分文档 → Collector 收到更高分
        │
        │  setMinCompetitiveScore(...) 再次抬高
        ▼
(循环)及格线越抬越高,剪枝越来越激进这个闭环的关键在于双向反馈:Collector 把及格线往下传给 WANDScorer(决定哪些文档跳过),WANDScorer 再往下传给 ImpactsDISI(决定哪些 block 跳过)。一开始及格线低、剪枝保守(还没见过高分文档,不敢贸然跳);随着高分结果不断收集,线越抬越高,剪枝越来越激进——这就是 §三里 set_min_competitive_score_count 持续增长的来源。
二、实战:MUST + SHOULD 混合查询的端到端追踪
结合前面几篇内容,用一个混合查询走完整路径:
GET /products/_search
{
  "query": {
    "bool": {
      "must": [
        { "term": { "status": "published" } },
        { "term": { "category": "ai" } }
      ],
      "should": [
        { "term": { "author": "sam" } },
        { "term": { "tag": "featured" } }
      ],
      "minimum_should_match": 1
    }
  }
}
2.1 一张图看清 Scorer 嵌套结构
这个查询最终会被组装成一棵 Scorer 树。先看树的样子,再逐层解释:
                      BooleanScorer(顶层,协调 MUST 与 SHOULD 的关系)
                              │
              ┌───────────────┴────────────────┐
              │                                │
     MUST 侧(合取)                      SHOULD 侧(析取,size=10 → TOP_SCORES)
              │                                │
    ConjunctionScorer                     WANDScorer
   (按 cost 排序,最稀疏领头)          (按 maxScore 调度,剪枝省打分)
              │                                │
      ┌───────┴────────┐               ┌───────┴────────┐
      │                │               │                │
  category:ai    status:published   author:sam     tag:featured
  (cost≈1万)     (cost≈100万)        (maxScore 高)   (maxScore 低)
   ↑ lead1       ↑ lead2             └── tail 堆按 maxScore 排
   (最稀疏,领头跳)                  (高分优先推进查实)
这张树图把前面几篇内容串到了一起——每个 Scorer 的选型都有明确理由:
- MUST 侧(合取):两个条件都要满足,用
ConjunctionScorer(第二篇)。按 cost 升序排列,让category:ai(只命中 1 万篇,最稀疏)当 lead1 领头跳,status:published(命中 100 万篇)当 lead2 跟进。lead1 跳得快,整个 MUST 侧就快。 - SHOULD 侧(析取):两个条件满足一个就行,且查询是 Top-10(
size=10),走WANDScorer(第三篇)。两个 SHOULD 子句按 maxScore 进 tail 堆,高分优先推进。 - 顶层 BooleanScorer:把 MUST 的命中文档交给 SHOULD 侧打分。MUST 过滤掉绝大部分文档后,WAND 只需对剩下的少数文档做上界判断,二者职责互补。
2.2 执行追踪:一篇文档怎么走过这棵树
假设 MUST 侧的 lead1(category:ai)跳到 doc=X,整个追踪如下:
① MUST 侧 ConjunctionScorer:
   lead1 (category:ai) advance 到 doc=X
   → lead2 (status:published) 确认 doc=X 也在 → MUST 命中 ✓

② 顶层 BooleanScorer 把 doc=X 交给 SHOULD 侧打分

③ SHOULD 侧 WANDScorer:
   把 author:sam、tag:featured 的游标推进到 doc=X
   → 上界判断(leadMax + tailMax vs 及格线)
   → 通过 → score() 算实际分

④ Collector 收集 doc=X 的分数,必要时抬高 minCompetitiveScore
   → 反馈回 WANDScorer 和 ImpactsDISI(第一章所说的反馈闭环)
2.3 几篇内容怎么协作
回看整个过程,几篇内容各管一段,缺一不可:
- [第一篇] rewrite 保证了查询结构简洁(去重、提升、展平)——这一步决定 Scorer 树的形态。
- [第二篇] cost 排序 让 MUST 侧高效迭代(最稀疏的
category:ai领头)——决定合取侧的跳过效率。 - [第三篇] WAND 调度 让 SHOULD 侧高效剪枝(高分优先 + 动态上界)——决定析取侧的打分开销。
- 本文 Block-Max 让 SHOULD 侧的上界更紧、剪枝更激进——决定析取侧的块级跳过力度。
- 顶层合取 把两者组合:MUST 先把文档数砍到很小,WAND 再在这个小集合里挑 Top-K,各自发挥所长。
三、动手验证:Profile API 观察 WAND 生效
用对比实验验证 WAND 的反馈闭环:track_total_hits: false 切入 TOP_SCORES 模式(WAND 生效),track_total_hits: true 强制 COMPLETE 模式(WAND 剪枝关闭),对比 profile 的 breakdown。
breakdown 字段含义
profile 中每个查询节点的 breakdown 是一个 Map。每个操作有两条记录:不带 _count 后缀的是纳秒耗时,带 _count 后缀的是调用次数。与 WAND/Block-Max 最相关的几个:
| 字段 | 含义 | 与 WAND/Block-Max 的关系 |
|---|---|---|
match / match_count |
TwoPhaseIterator matches() 验证 |
WAND 的上界判断在此发生 |
score / score_count |
score() 实际打分 |
仅对通过 matches() 的命中调用 |
shallow_advance / shallow_advance_count |
advanceShallow() 块级定位 |
Block-Max 独有:块级跳过 |
compute_max_score / compute_max_score_count |
getMaxScore() 计算分段上界 |
Block-Max 独有 |
set_min_competitive_score / set_min_competitive_score_count |
Collector 回传最低分阈值 | WAND 反馈闭环的直接证据 |
构造一个能体现剪枝的数据集
WAND 的文档级剪枝要体现为 score_count 下降,需要"少量高分文档 + 海量低分文档"的分布:高分文档先把 Top-K 的及格线抬到高位,低分文档的上界够不到线,于是被整批跳过。为此建一个专门的索引 wand_msm:
- 100 篇
body = "rare common"—— 同时命中rare(高 idf)和common,分数 ≈ 5.30 - 20000 篇
body = "common extra"—— 命中common+extra,两个都是高频低 idf 词,分数 ≈ 0.01
为什么加
minimum_should_match: 2?这是触发WANDScorer的关键。Lucene 的Boolean2ScorerSupplier.opt()在minShouldMatch > 1时返回WANDScorer;而纯析取(无minimum_should_match或 ≤1)走的是另一条MaxScoreBulkScorer路径(BooleanWeight.java:224)。两者同属 Block-Max 动态剪枝家族,但要直接观察WANDScorer+ Block-Max 的剪枝,用minimum_should_match: 2最干净。
GET /wand_msm/_search
{
  "profile": true,
  "track_total_hits": false,
  "size": 10,
  "query": {
    "bool": {
      "should": [
        { "term": { "body": "rare" }},
        { "term": { "body": "common" }},
        { "term": { "body": "extra" }}
      ],
      "minimum_should_match": 2
    }
  }
}
真实 profile 输出(Easysearch 2.2.0 / Lucene 9.12.2 实测)
############ track_total_hits = false(WAND 生效)############
BooleanQuery (body:rare body:common body:extra)~2  breakdown:
  next_doc_count                       101
  match_count                          100
  score_count                          100        ← 只给 100 篇高分候选打了分
  set_min_competitive_score_count        1        ← 反馈闭环生效!

  body:common (TermQuery)
  advance_count                        100        ← common 链只推进到高分文档区
  shallow_advance_count                  3        ← Block-Max 块级定位
  compute_max_score_count                3        ← Block-Max 分段上界计算
  body:extra (TermQuery)
  advance_count                          1        ← extra 子句几乎整链跳过!

############ track_total_hits = true(WAND 剪枝关闭)############
BooleanQuery breakdown:
  next_doc_count                     20101
  match_count                        20100
  score_count                        20100       ← 给全部 20100 篇命中文档都打了分
  set_min_competitive_score_count        0       ← COMPLETE 模式,从不回传阈值

  body:common  advance_count         20100
  body:extra   advance_count         20001
  (shallow_advance_count / compute_max_score_count 均为 0)
两组的 score_count 相差悬殊——false 模式 100、true 模式 20100,差了 200 倍。WAND 把 20000 篇低分的 common extra 文档在打分前就跳过了,只对真正可能进 Top-10 的 100 篇高分候选调用了 score()。两组返回的 Top-10 完全相同(全是 h0–h9,score=5.2984)——剪枝只省功,不改结果。
怎么读这份输出
把两组数据并排看:
| 字段 | track_total_hits: false(WAND 生效) |
track_total_hits: true(WAND 关闭) |
解读 |
|---|---|---|---|
score_count |
100 | 20100 | 文档级剪枝的直接证据:WAND 跳过 99.5% 的低分文档,只对高分候选打分 |
set_min_competitive_score_count |
1 | 0 | 反馈闭环:只有 false 模式下 Collector 才回传阈值 |
shallow_advance_count(common 子句) |
3 | 0 | Block-Max 铁证:只在 false 模式做块级 advanceShallow |
compute_max_score_count(common 子句) |
3 | 0 | Block-Max 铁证:只在 false 模式算分段上界 |
advance_count(extra 子句) |
1 | 20001 | 低分上界子句被 WAND 几乎整链跳过 |
next_doc_count |
101 | 20101 | false 模式连外层迭代都提前结束了 |
hits.total |
省略 | {"value":20100,"relation":"eq"} |
false 模式不精确计数、允许早退 |
三条证据互相印证:
set_min_competitive_score_count从 0 变 1:Collector 在收集到第 K 个高分结果后,把当前最低分回传给 WANDScorer(Scorer.setMinCompetitiveScore),这是 §一"剪枝反馈闭环"在 profile 里的落地。track_total_hits: true时TopScoreDocCollector的hitsThresholdChecker是 no-op(isThresholdReached()恒为 false),永不回传,所以为 0。score_count从 20100 暴跌到 100:20000 篇common extra文档的上界(≈0.01)够不到及格线(≈5.30),在score()之前就被跳过——这正是 WAND"用廉价的上界比较换掉昂贵的打分"的直接体现。shallow_advance_count/compute_max_score_count只在 false 模式非零:这正是 §一所讲 Block-Max 的advanceShallow()/getMaxScore()在底层被调用的痕迹。注意它们挂在 TermQuery 叶子节点上、而不是 BooleanQuery 顶层节点——后者这两个字段恒为 0。
⚠️ 另需注意:
score_count反映的是进入collect()的打分次数,只有在"高分文档先出现、低分文档上界够不到及格线"的分布下才会明显下降——若所有命中文档分数接近(例如每篇内容雷同),及格线抬不上去,score_count就不会降。
对比实验:观察耗时差异
将 track_total_hits 改为 true,同样查询再次执行,对比 score 耗时(纳秒,单次运行波动较大,下为多次中位数):
track_total_hits=false:   score ≈   37,000 ns   score_count =   100
track_total_hits=true:    score ≈ 2,640,000 ns   score_count = 20100     (约 70 倍)
本例剪枝比例高达 99.5%,false 模式的 score 耗时约只有 true 模式的 1/70——因为它只对 1% 的文档真正打分。数据集越大、剪枝比例越高,WAND 的收益越显著。(profile 本身有额外开销、绝对数字仅供参考,关键看两种模式的相对差距。)
小结
判断 Block-Max WAND 是否生效,看 set_min_competitive_score_count 是否从 0 变非零(机制是否触发);评估收益大小,看 score_count 的下降幅度与 score 耗时的相对差距。
四、开发者启示:写查询时该注意什么?
既然子句顺序在 Easysearch 2.x 上无需操心,那开发者应该关注什么?
✅ 用 filter 代替 must 当不需要评分时
filter 不参与评分,走 ConstantScoreQuery 路径更高效。同时,filter 子句不会增加 WANDScorer 的调度开销——它们被提升到 MUST 后走合取路径,与评分子句的 WAND 调度互不干扰。
✅ 让 Lucene 做 minShouldMatch 优化
当 should 数量恰好等于 minimumShouldMatch 时,所有 SHOULD 子句自动提升为 MUST(第一篇规则 10),走 ConjunctionScorer 而非 WANDScorer。这意味着:你不需要手动把 should 改成 must 来"帮助"优化器——只要语义上等价,Lucene 会自动做正确的选择。
✅ 避免嵌套过深的布尔查询
展平 SHOULD 嵌套能让 WAND 看到更多子句(第一篇规则 9)。嵌套结构下,内层 BooleanQuery 的子句对外层 WANDScorer 不可见,maxScore 上界估计不够紧,剪枝效果打折。手动展平或让 rewrite 自动展平,都能提升 WAND 效率。
✅ 理解 cost 的含义
cost ≈ 匹配文档数的估算,不是执行时间。一个高 cost 的 TermQuery 可能有极佳的缓存局部性(因为倒排列表是连续存储的),而一个低 cost 的 PointRangeQuery 可能需要更昂贵的验证逻辑。Profile API 的 advance 次数分布才是实际性能的真实反映。
❌ 不必刻意调整子句顺序(Easysearch 2.x)
底层会自动按 cost(合取)或 maxScore(析取)排序。无论是先写高频词还是低频词,执行时的迭代顺序完全相同。唯一例外见第二篇 §八的边界说明:Easysearch 1.x(Lucene 8.11)上 must/filter 混有多词查询时,仍应把稀疏 term 写在前面;Easysearch 2.x(Lucene 9.12)已随 Lucene 9.5 的修复免疫此问题。
🔧 Easysearch 的额外能力
在 Lucene 标准优化栈之外,EasySearch 还提供一个面向特定场景的增强能力:
fast_terms 插件:在高基数字段(如 user_id、tag_id 数万量级)上,用 RoaringBitmap 位图集合替代 N 个独立 TermQuery,将 N 次倒排索引查找压缩为 1 次 bitmap 交集。查询 DSL 名为 fast_terms,但其在 Profile 中对应的 type 是底层 Query 类的简单名 FilterQuery(type 取自 query.getClass().getSimpleName(),而插件实现类是 org.infinilabs.query.FilterQuery)。底层 FilterQuery 走 ConstantScoreWeight + 位图迭代器,advance 调用次数从 O(N·命中数) 降到 O(命中数)。
它走自己的 Scorer 体系、不参与 BooleanQuery 的 rewrite / cost 排序 / WAND 剪枝路径,可按需叠加。
五、全系列总结
四篇文章,从构建层到执行层,从合取到析取,我们完整走过了 EasySearch 布尔查询的优化全景:
- 构建层(第一篇):11 条 rewrite 规则
Easysearch + Lucene 的构建层不做代价排序,但通过 11 条代数规则自动简化查询结构。其中对执行性能影响最大的两条——规则 7(SHOULD+FILTER→MUST 提升)和规则 9(SHOULD 嵌套展平)——改变了子句的执行路径,为后续优化铺路。Profile API 可以直接观察 rewrite 后的查询形态(+ 前缀 = MUST 提升成功)。
- 执行层·合取(第二篇):cost 排序 + leadCost 传播
ConjunctionDISI 按 cost 排序,让最稀疏的迭代器领头——它是跳过无效文档速度最快的那个。两阶段验证按 matchCost 排序,leadCost 实现从外向内的策略传播(如 IndexOrDocValuesQuery 的自适应切换)。Profile 的 advance 次数分布是最直接的佐证:lead1 的 advance 次数远大于 followers。
- 执行层·析取 I(第三篇):WAND 动态调度
WANDScorer 按 maxScore 动态调度子句,高分优先推进——这是 Top-K 查询能早退的根本保障。三堆(head/lead/tail)分工合作,用大量廉价的上界比较换掉少量昂贵的精确打分。
- 执行层·析取 II(本文):Block-Max 块级剪枝
Block-Max WAND 在块级别进一步剪枝:用分段级 maxScore 替换全局 maxScore,整块低分文档一次跳过。shallow_advance 字段可验证其效果。剪枝的反馈闭环——Collector → WANDScorer → ImpactsDISI——实现自适应加速:越到后面,剪枝越激进。
给开发者的核心建议
- 无需关心子句书写顺序——底层自动优化。Easysearch 2.x(Lucene 9.12)确实如此;1.x 基于 Lucene 8.11,must/filter 混有 prefix/wildcard 等多词查询时,仍建议把稀疏的 term 子句写在前面(见第二篇 §八的边界说明)
- 关注查询结构设计——用 filter 替代不需要评分的 must,展平嵌套 SHOULD
- 善用 Profile API——
set_min_competitive_score_count(反馈闭环是否生效)、advance/shallow_advance次数(跳过力度)、score耗时(打分成本)是核心观测指标;注意不带_count后缀的是纳秒耗时,带_count的才是次数 - 理解 WAND 的触发条件——
track_total_hits: false切入TOP_SCORES开启剪枝(纯析取走MaxScoreBulkScorer,minimum_should_match > 1才走WANDScorer),track_total_hits: true走COMPLETE关闭剪枝;对比set_min_competitive_score_count是否从 0 变非零是判断剪枝是否生效最直接的方式,score_count的下降幅度则量化了实际收益
作者:冯田立,极限科技(INFINI Labs)Easysearch 搜索引擎研发专家,曾在亚马逊 AWS 有多年的 Elasticsearch 开源插件和 OpenSearch 的开发经验和客户集群的运维经验,并有幸参与 OpenSearch 的创立。
Easysearch 布尔查询子句重排序(三)|WAND 动态剪枝
Easysearch • INFINI Labs 小助手 发表了文章 • 0 个评论 • 5594 次浏览 • 2026-09-29 19:05
Lucene 如何用 WAND 算法实现 Top-K 的动态剪枝
INFINI Easysearch 是一款专注于企业级场景的分布式近实时搜索与分析引擎。它以 Apache Lucene 为内核进行了增强,在保持与行业主流搜索协议及开发生态完全兼容的同时,重点强化了安全性、稳定性、压缩率及信创兼容性。
一、回顾与引入
在第二篇中,我们深入解析了合取查询的核心优化:ConjunctionDISI 按 cost 排序,让最稀疏的迭代器领跑。这套机制的前提是 AND 语义——所有子句都必须匹配,所以"谁最少"就决定了跳转的速度。
本文聚焦析取(SHOULD)场景。关键转变在于:不需要全部匹配,而是找 Top-K 高分文档。 优化目标从"最少匹配"变为"最高分数贡献"——cost 最低的子句不一定分数最高,而分数最高的子句才最可能帮你快速找到 Top-K。
这就是 WAND 算法的用武之地。
二、为什么析取不能简单按 cost 排序?
合取和析取的本质差异决定了它们的优化策略必须不同:
| 维度 | 合取(MUST) | 析取(SHOULD) |
|---|---|---|
| 语义 | 所有子句都匹配 | 至少部分子句匹配 |
| 优化目标 | 快速排除不匹配文档 | 快速找到 Top-K 高分文档 |
| 排序依据 | cost(谁最少谁领头) | maxScore(谁分最高谁优先推进) |
| 关键操作 | 跳过不匹配的文档 | 跳过不可能进 Top-K 的文档 |
为什么 cost 排序在析取中不适用?看一个析取查询 should: [quantum, the, machine_learning],找 Top-10:
| 子句 | 匹配文档数(cost) | 单次命中得分 |
|---|---|---|
quantum |
100 | 8.0 |
the |
1000 万 | 0.1 |
machine_learning |
5 万 | 15.0 |
设想文档 D:不含 "quantum",但同时命中 "the" 和 "machine_learning",总分 = 0.1 + 15.0 = 15.1,远超只命中 "quantum" 的文档(8.0),理应排进 Top-10。
若按 cost 让 quantum 领头驱动,候选集就由 quantum 的倒排表决定——D 不在其中,根本不会被推进打分,Top-K 就漏掉了 15.1 分。根源在于:cost 衡量的是"匹配多少",分数衡量的是"匹配多高",两者是不同的维度。
析取需要的是感知分数的调度策略:优先推进高分子句,快速积累 Top-K,再用已有最低分剪枝。这就是 WAND(Weak AND)算法的核心思想。
WANDScorer 的触发条件
WANDScorer 不是总生效。Lucene 在 Boolean2ScorerSupplier.opt() 中按以下条件决定是否为 SHOULD 子句构造 WANDScorer(否则走 DisjunctionSumScorer):
if ((scoreMode == ScoreMode.TOP_SCORES && topLevelScoringClause) || minShouldMatch > 1) {
    return new WANDScorer(weight, optionalScorers, minShouldMatch, scoreMode);
} else {
    return new DisjunctionSumScorer(weight, optionalScorers, scoreMode);
}
即满足其一即可:
ScoreMode.TOP_SCORES且该析取是顶层评分子句:正常的_search请求默认track_total_hits=10000,对应TOP_SCORES(由TopScoreDocCollector设置)minShouldMatch > 1:此时即便非 TOP_SCORES 也用 WANDScorer 做合取推进
注意第 1 个条件里的 TOP_SCORES 是 Lucene 的内部评分模式,由请求参数 track_total_hits 间接决定用哪个 Collector,Collector 再把自己的 ScoreMode 报给 Scorer:
track_total_hits: false(默认10000亦同)→TOP_SCORES:收集满 Top-K 后允许提前结束,并把当前最低分回传给 WANDScorer,剪枝开启track_total_hits: true→COMPLETE:必须遍历全部匹配文档以给出精确总数,从不回传阈值,剪枝关闭
所以同一条 SHOULD 查询(默认 minShouldMatch=1),只改 track_total_hits 就能让 WANDScorer 在"真正剪枝"与"改走 DisjunctionSumScorer 不剪枝"之间切换——这正是下一篇 §三对比实验的切入点。
三、WAND 的核心逻辑:用上界剪枝
3.1 WAND 要解决什么:Top-K 与一条不断抬高的及格线
析取查询的本质:SHOULD 子句"至少匹配一个",但用户要的不是全部匹配文档,而是分数最高的 K 个(Top-K)。
既然只要 Top-K,就有一条隐形的及格线——当前已收集结果中第 K 名的分数,记作 minCompetitiveScore(最小竞争分)。超过它才可能挤进 Top-K,超不过一定落选。随着高分文档不断被收进来,这条线只会越抬越高。
于是每个候选文档只须回答一个问题:分数能不能超过及格线? 能才值得精确打分,不能就该跳过,不进行精确打分。WAND 的全部巧思都围绕上述这点,而办法就是下节介绍的"分数上界"。
3.2 从查询语句到游标:每个 SHOULD 子句是一条独立的倒排链
先看一条布尔查询长什么样:
{
  "bool": {
    "should": [
      { "term": { "body": "rare" } },
      { "term": { "body": "common" } },
      { "term": { "tag": "hot" } }
    ]
  }
}里的每个 SHOULD 子句,底层都是一次独立的倒排索引查找,对应一条倒排链(posting list)——按 docID 升序排列的、所有命中该词的文档号序列。每条倒排链配一个游标 docID,指向"这条链上下一个待处理的匹配文档"。
3 个 SHOULD 子句 = 3 条倒排链 = 3 个游标。WANDScorer 就是同时管着这几个游标、协调它们推进的调度器。
下面给这三条倒排链画个框图(沿用下一篇 §三对比实验里 body:rare / body:common / tag:hot 的语义:一个稀有词、一个常见词、一个中等标签),方便后续讲游标怎么移动。竖线是已经按 docID 升序排好的匹配文档号,▼ 就是游标当前指向的那个文档:
        SHOULD 子句         倒排链(命中的 docID,升序排列)        游标 ▼

   ┌──────────────┐
   │  rare (稀有) │  ··· 42 ──── 87 ──── 156 ──── 203 ──── 318 ──── ···
   └──────────────┘        ▲
                           │  当前指向 doc=42

   ┌──────────────┐
   │ common (常见)│  ··· 5 ── 42 ── 87 ── 88 ── 156 ── 203 ── 318 ── 410 ── ···  (很长,省略)
   └──────────────┘       ▲
                          │  当前指向 doc=5

   ┌──────────────┐
   │  hot (标签)  │  ··· 17 ──── 87 ──── 203 ──── 318 ──── ···
   └──────────────┘        ▲
                           │  当前指向 doc=17

   ───────────────────────────────────────────────────────────────────→ docID 轴
5 17 42 87 88 156 203 318 410看这张图,三条游标彼此独立、各自往前走。WANDScorer 的全部工作,就是在它们之间做调度:选一个"候选文档号"(比如最小的 5),把三条游标推进到那个号去查命中,命中就打分、不命中就跳过。三堆(§3.4)就是为这个调度做的分工。
关键认知:一个文档的最终得分 = 它实际命中的那些子句的实际得分之和。子句"命中没命中",看那条倒排链里有没有这个文档号——这正是游标要查的事。
3.3 核心招式:用分数上界代替实际分数
最直白的判断法:把命中的子句逐个 score() 加起来跟及格线比。但 score() 很贵(要算 BM25 的 tf/idf),WAND 不想这么干。
WAND 的招式:别算实际分数,估一个上界就够了。 每个子句在构建时就算好 maxScore——"命中任何文档最多贡献多少分"(由 idf 和该词可能的最高 tf 决定,计算成本低)。于是:
文档分数上界 = 所有"可能命中"的子句的 maxScore 之和
这个上界必然 ≥ 实际分数:maxScore ≥ 实际得分(往大了估),"可能命中" ⊇ 真正命中(多算不漏算)。
判断就简单了:上界 < 及格线 → 直接跳过,一次 score() 都不调用。 只有上界 ≥ 及格线的文档才值得精确打分。WAND 的全部收益就来自这里——用大量廉价的上界比较换掉少量昂贵的精确打分("Weak"也在这里:不强求每个子句都查实,上界够用就敢下结论)。
那么"可能命中"怎么界定?答案在游标位置里。
3.4 游标的三种位置 → 三堆
§3.3 留了一个问题:哪些子句算"可能命中"?答案全在游标上。
WANDScorer 手里攥着好几条倒排链的游标,各自独立推进。每一轮它选定一个候选文档号(从哪来的 §3.5 会说,眼下先当成参照点),然后看每条链的游标相对这个文档号,只可能有三种位置:
- 游标 == 候选号:确认命中 → 上界按
maxScore计 - 游标 > 候选号:游标走过头了,确认不命中 → 贡献 0
- 游标 < 候选号:还没走到,未知 → 上界按
maxScore计(往乐观了估)
WANDScorer 把这三类子句分别放进三个结构,叫三堆:确认命中的进 lead,确认不命中的进 head,未知的进 tail。
         ┌────────────────────────────────────────────────────────────────┐
         │                      WANDScorer 内部结构                        │
         │                                                                │
         │   tail (maxScore 最大堆) lead        head (按 docID 升序)        │
         │   ┌──────────────┐       ┌─────┐     ┌──────────────┐          │
         │   │ S4 maxScore=9│       │ S1  │     │ S3 doc=156   │          │
         │   │ S2 maxScore=5│       │ S5  │     │ S6 doc=203   │          │
         │   │ S7 maxScore=2│       │     │     │              │          │
         │   └──────────────┘       └─────┘     └──────────────┘          │
         │                                                                │
         │   游标还没到当前文档     游标已停在      游标已越过当前文档           │
         │   按 maxScore 排,       当前文档      按 docID 排,              │
         │   按需推进                            决定下个候选                │
         └────────────────────────────────────────────────────────────────┘
三个结构各有分工:
- tail 按
maxScore排最大堆,堆顶是分数最高的子句。上界不够时优先借它——最可能一把把上限抬过线。 - lead 是简单链表,串起确认命中的子句。精筛过关后逐个
score()算实际分。 - head 按
docID排最小堆,堆顶是文档号最小的——它就是下一个候选文档。
子句在三堆间流转:tail → lead → head。未知的推进去查,命中进 lead,不命中进 head。下一轮候选变了,部分子句又可能从 head 回到 tail。
3.5 搜索流程:粗筛、精筛与阈值回传
把三堆放回完整流程。WANDScorer 对外是个 Scorer,被 Collector 驱动,主循环四步:
Collector 主循环:
  while ((doc = scorer.nextDoc()) != NO_MORE_DOCS) {   // ① 粗筛
    if (twoPhase.matches()) {                          // ② 精筛
      float s = scorer.score();                        // ③ 精确打分
      collector.collect(doc, s);                       // ④ 收入结果 + 抬及格线
    }
}- ① 粗筛:候选从 head 堆顶来(docID 最小者)。
nextDoc()调用doNextCompetitiveCandidate(WANDScorer.java:492-504)做一道文档级跳过:若leadMaxScore + tailMaxScore < 及格线,说明当前 doc 凑不够分,直接推进到下一个候选文档(可能跨 block)。这里只用每子句一个的 maxScore 求和判断,不逐子句查实命中、不算精确分。 - ② 精筛:留在候选 doc 上,逐个借 tail 堆顶推进查实命中,看实际能否过线。这是 WAND 的核心动作,§3.6 专门展开。
- ③ 精确打分:通过精筛的,把 lead 里确认命中的子句逐个
score()加总。 - ④ 阈值回传:收满 K 个后,Collector 把第 K 名分数回传给 WANDScorer 抬高及格线——下一篇 §一展开。
3.6 核心剪枝:上界估计与"借 tail"
对当前候选文档,WAND 只回答一个问题:它的分数上界够不够得着及格线?
上界 = lead 各子句 maxScore 之和(确认命中,贡献确定)+ tail 各子句 maxScore 之和(未知,按 maxScore 乐观估算)。这个上界必然 ≥ 实际分数。判断逻辑(WANDScorer.java:309-332):
while (leadMaxScore < minCompetitiveScore) {        // lead 自己不够线
    if (leadMaxScore + tailMaxScore < minCompetitiveScore)
        return false;        // 加上 tail 的乐观估计仍不够 → 必败,跳过
    advanceTail();            // 还有希望:从 tail 堆顶借一个子句去"查实"
}
return true;                  // lead 已够线 → 留下精确打分
关键在 advanceTail()——把 tail 堆顶(maxScore 最高的未知子句)推进到当前文档查实,结果只有两种:
- 命中 → 进 lead,
leadMaxScore实打实涨上去; - 不命中 → 进 head,从 tail 挪走,
tailMaxScore掉下来。
每借一次,要么抬高下限(leadMaxScore),要么压低上限(tailMaxScore)。文档能不能活下来,取决于借出的子句里有多少真的命中;借遍 tail 仍够不到线就判负,全程没调用过 score()。
为什么永远先借堆顶? tail 按 maxScore 排最大堆,堆顶最可能一下把 leadMaxScore 抬过线;如果连 leadMaxScore + tailMaxScore 都够不到线,低分子句就无需查实,候选文档可以直接跳过。这就是 WAND 的 "Weak":不强求每个子句都查实,只查可能扭转局面的那几个。
3.7 数字示例:一次完整的剪枝流程
先给出示例的场景。3 个 SHOULD 子句,各自的 maxScore 和倒排链(命中的 docID,已升序排列)如下,及格线 minCompetitiveScore = 10:
| 子句 | maxScore | 倒排链(命中的 docID) |
|---|---|---|
| S1 | 8 | 42, 55 |
| S2 | 5 | 20, 55 |
| S3 | 3 | 30, 60 |
每个子句配一个游标,指向"这条链下一个待处理的 docID"。假设已经收集满 Top-K、及格线抬到了 10,本轮候选文档 = 42(S1 的游标停在 42,刚从 head 堆顶取出作为领头);S2、S3 因 maxScore 较低此前没被推进,游标还分别停在 20、30。把三个子句按"游标 vs 候选 42"的位置归堆:
- S1 游标 42 == 42:确认命中 doc=42 → lead
- S2 游标 20 < 42:还没走到,未知 → tail
- S3 游标 30 < 42:还没走到,未知 → tail
- 没有游标 > 42 的子句 → head 此刻是空的(S1 已进 lead,S2、S3 还在 tail)
于是初始状态:lead 装着 S1(确认能拿 8 分),tail 装着 S2、S3(最多还能补 5+3=8 分),head 空。
下面这张状态图把 doc=42 接下来怎么被剪掉完整画了出来。关键看右侧三个数:leadMax = lead 里已确认能拿的分数,tailMax = tail 里最多还能补多少(乐观估计),二者之和就是分数上界。每借一次 tail 堆顶,三堆成员就流动一次,这三个数也跟着变:
        候选 doc=42,  及格线 = 10                          分数上界 = leadMax + tailMax

              head          lead         tail            leadMax  tailMax  上界     动作
        ┌────────────┐  ┌─────────┐  ┌──────────┐
  初始   │   (空)     │  │  S1: 8  │  │  S2: 5   │          8        8     16   ≥10
        │            │  │         │  │  S3: 3   │                              ─→ 借堆顶 S2
        ├────────────┤  ├─────────┤  ├──────────┤
  借 S2 │  S2→55     │  │  S1: 8  │  │  S3: 3   │           8        3     11   ≥10
        │            │  │         │  │          │                              ─→ 借堆顶 S3
        ├────────────┤  ├─────────┤  ├──────────┤
  借 S3 │  S2→55     │  │  S1: 8  │  │  (空)    │           8        0      8   <10
        │  S3→60     │  │         │  │          │                              ─→ ✂️ 必败
        └────────────┘  └─────────┘  └──────────┘

        表头解读:head/lead/tail 三栏列出各自的子句成员(含 maxScore);
                  右侧三个数描述【整堆】在这一轮的整体状态,不与某一格对应。
每一行发生了什么(看左栏 → 右栏):
- 初始:lead 只有 S1 →
leadMax=8不够线(8 < 10),但加 tail 的乐观估计tailMax=8后上界 16 ≥ 10,还有希望 → 借 tail 堆顶 S2 查实。 - 借 S2:把 S2 游标从 20 推进到 ≥42,结果落在 55(> 42,没命中)→ S2 进 head,tailMax 从 8 掉到 3。
leadMax还是 8(没涨,因为 S2 没命中),上界 11 ≥ 10 仍有希望 → 再借 S3。 - 借 S3:把 S3 游标从 30 推进到 ≥42,落在 60(也没命中)→ S3 进 head,tailMax 从 3 掉到 0。上界 8 < 10 → 必败,剪掉 ✂️
读懂这张图就懂了 WAND:借出的子句都没真命中 42,所以 leadMax 三轮卡在 8 不动;而每借走一个,tailMax 就往下掉一截(8→3→0)。上界随之从 16 一路缩到 8,最后跌穿及格线——doc=42 全程没调一次 score() 就被剪掉。
再看下一个候选 doc=55——lead 自身就够线,根本不用借。doc=42 被剪掉后,S1 推进到它的下一个文档 55;S2、S3 在前面借出时已推进到 55、60。按游标位置归堆:S1、S2 游标 == 55 → lead;S3 游标 60 > 55 → head(贡献 0)。状态图只有一行:
        候选 doc=55,  及格线 = 10

              head          lead         tail            leadMax  tailMax  上界     动作
        ┌────────────┐  ┌─────────┐  ┌──────────┐
  初始   │  S3→60     │  │  S1: 8  │  │  (空)    │         13        0     13   ≥10   ─→ score()
        │            │  │  S2: 5  │  │          │                              实际 7+4=11 ✅
        └────────────┘  └─────────┘  └──────────┘
leadMax=13 一上来就够线,直接调 score() 算实际分 7+4=11 > 10 → ✅ 收入 Top-K。两图对比,分水岭就在第一行:doc=42 的 lead 只值 8,被迫借 tail 撞运气;doc=55 的 lead 自值 13,一步过关。同一个及格线下,命运全由"借出来的子句有没有真命中"决定——这正是 §3.6 那句"借堆顶"的实战含义。
3.8 cost 作为平局打破者(tiebreaker)
当两个子句 maxScore 相同时,推进 cost 更低(更稀疏)的子句更高效——它每次 advance 跳过的文档更多。
代码解读:tail 堆的比较器 greaterMaxScore()(WANDScorer.java:643-651)以 scaledMaxScore 为主键排序,maxScore 相同时用 cost 做次键:
private static boolean greaterMaxScore(DisiWrapper w1, DisiWrapper w2) {
  if (w1.scaledMaxScore > w2.scaledMaxScore) return true;
  else if (w1.scaledMaxScore < w2.scaledMaxScore) return false;
  else return w1.cost < w2.cost;   // 分数并列时,cost 更低(更稀疏)的排前面
}
小结
本文把 WAND 讲透了:一条不断抬高的及格线 + 用 maxScore 估上界 + 三堆分工调度游标 + 完整数字例子。核心就一句——用大量廉价的上界比较,换掉少量昂贵的精确打分。
但标准 WAND 还有一个明显短板:每个子句的上界是全局的,游标走到低分区域仍按全局最高分估,剪枝不够激进。Block-Max WAND 怎么补上这块、混合查询怎么端到端跑起来、Profile API 怎么亲手验证剪枝生效——都在下一篇(四)。
作者:冯田立,极限科技(INFINI Labs)Easysearch 搜索引擎研发专家,曾在亚马逊 AWS 有多年的 Elasticsearch 开源插件和 OpenSearch 的开发经验和客户集群的运维经验,并有幸参与 OpenSearch 的创立。
Easysearch 布尔查询子句重排序(二)|ConjunctionDISI 按 cost 排序源码解析
Easysearch • INFINI Labs 小助手 发表了文章 • 0 个评论 • 5605 次浏览 • 2026-09-29 19:01
Lucene 如何让最稀疏的迭代器领跑,最大化跳过无效文档
INFINI Easysearch 是一款专注于企业级场景的分布式近实时搜索与分析引擎。它以 Apache Lucene 为内核进行了增强,在保持与行业主流搜索协议及开发生态完全兼容的同时,重点强化了安全性、稳定性、压缩率及信创兼容性。
一、回顾与引入
在第一篇中,我们走完了布尔查询从用户 JSON 到 Lucene 执行的构建层旅程:Easysearch 的 BoolQueryBuilder 会保留同类子句的书写顺序,Lucene 的 BooleanQuery.rewrite() 则通过等价改写简化查询结构。
其中,和本文关系最直接的是 SHOULD + FILTER → MUST:一个原本只是“可选加分”的 SHOULD 子句,如果同时出现在 FILTER 中,就会被改写成 MUST。它的执行路径也随之改变——从可选评分路径,进入更直接的合取路径。
所谓合取路径,就是按 AND 语义执行查询:所有必选条件都要同时满足,任意一个不满足就可以跳过该文档。对于 MUST / FILTER 这类合取子句,真正影响性能的不是用户在 JSON 里先写谁、后写谁,而是 Lucene 在执行层如何安排它们的检查顺序。
这就是本文要讲的“布尔查询子句重排序”:进入 Scorer 构造阶段后,每个 MUST / FILTER 子句会变成对应的文档迭代器,Lucene 再按 cost() 对这些迭代器重新排序,让匹配文档最少的迭代器先领跑。
一个直觉可以帮助我们理解:在 AND 查询中,谁的结果最少,谁最有"话语权"。因为 AND 语义要求所有条件都满足,所以结果最少的那个条件能最快地排除不满足的文档,剩下的条件只需要确认即可。
本文就专注于这条合取路径的核心机制:ConjunctionDISI 如何按 cost 排序,让最稀疏的迭代器领跑整场迭代。
二、前置:什么情况下走 ConjunctionScorer?
上面已经说明,rewrite 可能会把子句带入合取路径;但并不是所有 bool 查询都会走这条路径。本节先界定范围:哪些查询会进入合取路径,哪些不会。Lucene 在 Boolean2ScorerSupplier.getInternal() 中会根据子句组合做这个判断。
| 查询形态 | 是否进入合取路径 | 简单理解 |
|---|---|---|
| 多个 MUST / FILTER | 是:ConjunctionScorer → ConjunctionDISI |
标准 AND 查询:所有条件都必须满足 |
| 只有一个 MUST / FILTER | 不需要 | 只有一个迭代器,没必要做求交和排序 |
MUST / FILTER + SHOULD,且 minShouldMatch = 0 |
必选部分进入 | 先用 MUST / FILTER 圈定候选集,SHOULD 只负责加分 |
MUST / FILTER + SHOULD,且 minShouldMatch > 0 |
整体进入 | 除了必选条件,还要求 SHOULD 至少命中 N 个 |
| 只有 SHOULD | 否 | 这是 OR 查询,走 WANDScorer 或 DisjunctionSumScorer,不是本文的合取路径 |
对本文来说,记住一个判断就够了:只要查询里出现多个“必须同时满足”的条件,Lucene 就需要做交集计算,ConjunctionDISI 的 cost 排序就有发挥空间。
那么 ConjunctionDISI 内部到底做了什么?让我们深入源码。
三、核心揭秘:ConjunctionDISI 按 cost 排序
这是合取查询最核心的优化。
3.1 生活类比
可以把合取查询理解成多条件筛选:先用结果最少的条件缩小候选集,再让其他条件确认,通常最省事。
比如在快递系统里找“已签收、发往北京、备注里有易碎品”的包裹。“已签收”和“发往北京”的包裹可能很多,但“备注里有易碎品”的包裹很少。先从“易碎品”开始查,再确认它是否发往北京、是否已签收,比先遍历所有已签收包裹更快。
3.2 源码解析
先解释一下“迭代器”,比如下文的 DocIdSetIterator。迭代器可以理解为某个查询条件对应的匹配文档列表游标。它负责在自己的列表里向前移动,告诉 Lucene:下一个匹配这个条件的 docID 是谁。
比如 author:sam 的迭代器里可能是 [42, 78, 203],category:ai 的迭代器里可能是 [12, 42, 100, 203]。执行 AND 查询时,Lucene 要做的就是不断推进这些游标,找到它们共同出现的 docID,比如这里的 42 和 203。
所以,本文说的“重排序”不是改写用户 JSON 里的子句顺序,而是在执行阶段对这些子句对应的迭代器排序:谁的 cost() 更小,谁就更靠前执行。
核心逻辑在 Lucene 的 ConjunctionDISI.java(ConjunctionDISI.java:154-163):
private ConjunctionDISI(List<? extends DocIdSetIterator> iterators) {
    assert iterators.size() >= 2;

    // Sort the array the first time to allow the least frequent DocsEnum to
    // lead the matching.
    CollectionUtil.timSort(iterators,
        (o1, o2) -> Long.compare(o1.cost(), o2.cost()));
    lead1 = iterators.get(0);  // 代价最小 → 领头
    lead2 = iterators.get(1);
    others = iterators.subList(2, iterators.size()).toArray(new DocIdSetIterator[0]);
}
三行代码,逻辑清晰:
- 按
cost()升序排序:cost()返回迭代器预估的匹配文档数,越少越"便宜"(注:cost 是预估值,实际匹配数可能有偏差,但排序逻辑依然成立) lead1:代价最小的迭代器,负责领头跳转——它最稀疏,每次跳转跳过的文档最多lead2:代价第二小的迭代器,负责二次确认others:其余迭代器,仅在 lead1 和 lead2 都停下时才被调用
3.3 执行过程
核心迭代方法 doNext()(ConjunctionDISI.java:165-199):
private int doNext(int doc) throws IOException {
    advanceHead:
    for (; ; ) {
        // doc 是当前 lead1 停住的位置;lead1 是最稀疏的迭代器,负责给出候选 docID
        assert doc == lead1.docID();

        // 先让 lead2 追上 lead1:advance(doc) 会跳到 >= doc 的第一个文档
        final int next2 = lead2.advance(doc);
        if (next2 != doc) {
            // lead2 跳过了当前 doc,说明当前候选不匹配;lead1 跳到 lead2 的位置作为新起点
            doc = lead1.advance(next2);
            if (next2 != doc) {
                // 仍没对齐,说明 lead1 又跳到了更后面,重新开始对齐
                continue;
            }
        }

        // lead1 和 lead2 对齐后,再检查其他迭代器
        for (DocIdSetIterator other : others) {
            // other 可能在上一轮已经被推进过;只有落后时才需要追赶
            if (other.docID() < doc) {
                final int next = other.advance(doc);
                if (next > doc) {
                    // other 跳过了当前 doc,当前候选失败;lead1 追到新的最大 docID
                    doc = lead1.advance(next);
                    continue advanceHead;
                }
            }
        }

        // 所有迭代器都停在同一个 doc 上 → 这个文档满足所有条件
        return doc;
    }
}
这段代码的核心就是“不断对齐”:谁跳到了更大的 docID,其他迭代器就追上去;直到所有迭代器停在同一个 docID,才算匹配成功。
例如 lead1 停在 78,而 lead2.advance(78) 返回 100,就说明 78 不可能匹配。Lucene 会直接把 lead1 推进到 100 附近,而不是继续检查 79、80、81……这些中间文档。
3.4 直观示例
为突出 cost 的量级差异,下面用夸张的数量级示意(§六会给出真实测试索引的实测数据,数量级更小,但结论一致):
查询:must: [status:published(100万), category:ai(1万), author:sam(500)]

迭代器按 cost 排序后:
  lead1: author:sam     cost=500     ← 最稀疏,领头跳转
  lead2: category:ai    cost=10,000
  other: status:published cost=1,000,000

执行过程:
  lead1 → doc=42 → lead2确认✓ → other确认✓ → 匹配!
  lead1 → doc=78 → lead2确认✗ → 跳过(不用查 other)
  lead1 → doc=203 → lead2确认✓ → other确认✓ → 匹配!

  如果没有 cost 排序,让高频词先给出候选,后续条件就要确认大量无效文档。
cost排序的效果:Lucene 实际执行时,lead1 一定是 cost 最小的迭代器(即最低频)。低频迭代器先领头,可以显著减少候选文档数量。
3.5 子合取展平
还有一个值得注意的细节:当嵌套的 ConjunctionDISI 作为子句出现时,会被"拆包"展平(ConjunctionDISI.java:54-77):
} else if (disi.getClass() == ConjunctionDISI.class) {
    // 发现子句本身也是一个 ConjunctionDISI,也就是嵌套的 AND 查询
    ConjunctionDISI conjunction = (ConjunctionDISI) disi;

    // 不把整个子 ConjunctionDISI 当成一个黑盒,
    // 而是把它内部已经拆好的 lead1、lead2、others 全部取出来
    allIterators.add(conjunction.lead1);
    allIterators.add(conjunction.lead2);
    Collections.addAll(allIterators, conjunction.others);
}
这些迭代器取出来后,会和外层迭代器一起进入统一排序流程。也就是说,Lucene 不会把内层 AND 当成一个整体参与外层排序,而是先展平,再让所有迭代器按 cost 统一排序。
这确保了基于 cost 估算的全局最优迭代顺序——如果内层有一个极稀疏的迭代器,它也有机会“越级”成为全局 lead1,而不是被锁在内层。
注意这里使用了精确类检查 disi.getClass() == ConjunctionDISI.class,而不是 instanceof。这是为了确保只拆包原始的 ConjunctionDISI,不误拆子类(如 BitSetConjunctionDISI,它有自己的优化路径)。
四、延伸:候选文档确定后,验证也要按成本排序
前面讲的是 cost() 排序:在多个迭代器之间,先让匹配文档最少的迭代器领头,尽量少产生候选文档。它背后的思想是:把执行成本低、过滤能力强的步骤放在前面,尽早排除不匹配的文档。
matchCost() 排序是这个思想在“验证阶段”的延伸:cost() 决定“谁先领头找候选”,matchCost() 决定“先做哪个精确验证”。
为什么候选文档还要验证?因为有些迭代器是"近似的"——先用低成本方式定位可能匹配的文档,再用精确方式二次确认。典型场景是短语查询:先对短语中的每个词做倒排合取,得到“包含全部词”的候选文档,再检查这些词是否出现在符合要求的相对位置上。前者用 posting list 快速缩小范围,后者才是真正的精确匹配。
Lucene 用 TwoPhaseIterator 表示这种两阶段验证,而 ConjunctionTwoPhaseIterator 会按 matchCost() 从低到高排序,让便宜的验证先执行;一旦失败,就不用再执行后面更贵的验证(ConjunctionDISI.java:317-357):
CollectionUtil.timSort(twoPhaseIterators,
    (o1, o2) -> Float.compare(o1.matchCost(), o2.matchCost()));
类比:先查身份证(快,matchCost 低),再查指纹(慢,matchCost 高),而不是反过来。如果身份证就不对,指纹根本不用查。
与 cost() 不同,matchCost() 没有统一公式:它是每个 TwoPhaseIterator 子类按自身验证逻辑估算的“简单操作数”(如 DocValues 查 bitset 约记为 3 次操作)。这个值比较粗略,实际排序时用到的只是相对大小——让便宜的验证先跑。
在实际代码中,ConjunctionDISI.createConjunction() 会把执行过程拆成两个阶段来看:
- 找候选 docID:用
allIterators完成。普通迭代器会直接放进来;如果某个查询是两阶段查询,就把它的“近似迭代器”放进来,先参与cost()排序和合取对齐。 - 验证候选是否真的匹配:用
twoPhaseIterators完成。这里保存的不是另一批文档列表,而是候选 docID 命中后要执行的matches()验证逻辑,并按matchCost()排序。
所以可以理解为:allIterators 负责“先找可能匹配的文档”,twoPhaseIterators 负责“再确认这些文档是否真的匹配”。前者按 cost() 排序,目标是少产生候选;后者按 matchCost() 排序,目标是少做昂贵验证。
五、进阶补充:cost 排序还会影响子查询策略
前面讲的是 cost 排序对“当前这一层”的影响:选出最稀疏的迭代器作为 lead1,减少候选文档。但 cost 排序选出的 lead1 还会带来一个连锁效应:它把代价信息继续传给子查询,让子查询也能根据外层的调用频率选择更合适的执行方式。
这个连锁效应的起点是:在合取查询里,外层最终会由最稀疏的迭代器领头,所以其他子查询被推进的次数通常不会超过这个领头迭代器的规模。这个规模就是向外传播给子查询的代价上限。Lucene 在 Boolean2ScorerSupplier.getInternal() 中用 Math.min(leadCost, cost()) 给这个估计加了一个上限(Boolean2ScorerSupplier.java:126):如果上层传来的 leadCost 过大,就用当前查询自己的 cost() 压住,避免子查询误判使用模式。对于纯合取查询来说,这个值通常接近 lead1.cost()。
这个向外传播的代价上限,就是 leadCost。它可以理解为上层给子查询的一个提示:“接下来你大概要被推进这么多次”。它不是 ConjunctionDISI 内部的概念,而是 ScorerSupplier.get(long leadCost) 的参数。
这里的“推进”指的是:上层会不断要求子查询的迭代器向后移动,要么调用 nextDoc() 走到下一个匹配文档,要么调用 advance(target) 直接跳到 >= target 的文档。
为什么这个提示有用?因为不同实现适合不同使用方式:如果会被频繁推进,就适合用支持高效跳转的结构;如果只会被少量推进,就可以选择初始化成本更低的结构。一个典型例子是 IndexOrDocValuesQuery。它内部同时持有索引结构(点数据 / term 查询)和 DocValues 两种策略,会根据 leadCost 动态选择(IndexOrDocValuesQuery.java:176-186):
public Scorer get(long leadCost) throws IOException {
    final long threshold = cost() >>> 3;  // cost / 8
    if (threshold <= leadCost) {
        return indexScorerSupplier.get(leadCost);   // 推进频繁:用索引结构
    } else {
        return dvScorerSupplier.get(leadCost);      // 推进较少:用 DocValues
    }
}
简单说:外层通过 cost 排序估算推进频率,再把这个信息传给子查询;子查询只需要判断“我会被频繁推进,还是只会偶尔确认”,就能做出局部最优选择。
六、一个 MUST 查询是如何被重新排序的
用一个简单的 MUST 查询,把第一篇的 rewrite 和本文的 cost 排序串起来。下面这个例子中,status:published 写在前面,category:ai 写在后面:
GET /bool_cost_profile_test/_search
{
  "profile": true,
  "query": {
    "bool": {
      "must": [
        { "term": { "status": "published" }},
        { "term": { "category": "ai" }}
      ]
    }
  }
}
完整过程可以拆成四步:
① Easysearch 层:按用户写法构建 BooleanQuery
   profile description 仍显示:+status:published +category:ai

② Lucene rewrite:2 个 MUST,无重复、无矛盾
   查询形态保持为两个 MUST 子句

③ Scorer 构造:
   Boolean2ScorerSupplier.req() → new ConjunctionScorer(...)
   ConjunctionScorer 内部创建 ConjunctionDISI
   ConjunctionDISI 再按 cost 对迭代器排序

④ 执行:
   低 cost 的 category:ai 负责产生候选 docID
   status:published 通过 advance(candidate) 追赶确认
在本地 Easysearch 2.2.0 / Lucene 9.12.2 的测试索引中,status:published 约 900 条,category:ai 约 100 条。实际 profile 结果是:
子句                 next_doc_count   advance_count   说明
──────────────────────────────────────────────────────────────
category:ai          91               1               低 cost,产生候选
status:published     0                91              跟随候选,用 advance 确认
把 JSON 里的两个 MUST 顺序反过来再查,profile 仍然显示 category:ai 通过 nextDoc() 产生候选,status:published 通过 advance() 确认。也就是说,description 会保留查询展示顺序,但真正执行时的迭代器顺序由 cost 排序决定。
这就是本文的关键点:用户在 JSON 中先写谁,不等于执行时谁先跑。对于合取查询,Lucene 会在 Scorer 构造阶段按 cost 重新安排迭代器顺序,让更稀疏的条件领头。唯一的例外是多词查询混入 must/filter 且版本较老的场景,见 §八末尾的边界说明。
双条件场景验证了"重排序确实发生",接下来看三条件场景如何用 Profile 观察。
七、如何用 Profile API 观察 cost 排序效果
现在扩展到三条件,重点看一个更极端的对比:author:sam 只有 5 条,status:published 有 900 条。Profile 不会直接告诉你 lead1 是谁,但可以通过 next_doc_count 和 advance_count 的分布间接推断。
在同一个测试索引上,查三个 MUST:
"must": [
  { "term": { "status": "published" }},
  { "term": { "category": "ai" }},
  { "term": { "author": "sam" }}
]
BooleanQuery 的子节点大致如下:
子句                 next_doc_count   advance_count   说明
──────────────────────────────────────────────────────────────
author:sam           5                1               最稀疏,负责产生候选 docID
category:ai          0                6               跟随候选,用 advance 对齐
status:published     0                5               跟随候选,用 advance 对齐
注意跟随迭代器的
advance_count未必完全相等,这和实际匹配过程中发生的追赶次数有关,不影响"谁是领头"的判断。
如何看这份 Profile
Profile 不会直接打印 lead1,但指标和源码是对应的:ConjunctionDISI.nextDoc() 会调用 lead1.nextDoc() 产生下一个候选;进入 doNext() 后,再通过 lead2.advance(doc) 和 other.advance(doc) 让其他迭代器追赶。next_doc_count 和 advance_count 统计的正是这些底层调用。
可以总结成一条简单观察规律:
- 领头迭代器:
next_doc_count通常更高,它要不断产生候选 - 跟随迭代器:
advance_count通常更高,它只在候选 docID 上确认
需要注意:Profile 只提供观察线索,不同 Lucene 版本、查询类型(DocValues、PointRange 等)和数据分布,都可能让 next_doc / advance 的表现有所不同。特别是当查询走了 BitSet 优化路径或 BlockMaxConjunctionScorer 时,指标分布会不一样。解读时要结合 description、type 和各子节点的 breakdown 一起判断。
八、小结与预告
回到本系列的主题:布尔查询子句重排序。本文讲的是其中最典型的一种——MUST / FILTER 这类合取子句进入执行层后,会从“用户书写顺序”转换为“按 cost 排序的迭代器执行顺序”。
本文着重介绍的核心机制包括:
- ConjunctionDISI 按 cost 排序:最稀疏的迭代器领头,其他迭代器仅做确认,最大化跳过无效文档
- 两阶段验证按 matchCost 排序:最便宜的验证先执行,失败即可短路
- leadCost 传播:代价信息从外向内传播,子查询据此做局部最优策略选择(如 IndexOrDocValuesQuery 的自适应切换)
- 子合取展平:嵌套的 ConjunctionDISI 被拆包到同一层级,确保全局最优的迭代顺序
这些机制的共同特点是:代价感知 + 动态决策——排序在 Scorer 构造时完成,与用户书写顺序无关。
一条边界:老版本里混入多词查询,顺序仍然敏感
"与书写顺序无关"有个前提:每个子句在调度阶段都能被轻量地试探。TermQuery 满足——预建的 TermStates 让它能 O(1) 判断某段有无匹配,没有就返回 null,短路掉还没轮到的子句。但 prefix / wildcard / regexp / range-on-keyword / fuzzy 这类多词查询在 Lucene 9.5 之前不满足:它们一旦被调度就同步干重活——枚举全部 term、读倒排、建 bitset——而调度又是按书写顺序进行的。
在一个 2900 万文档、23 个主分段的索引上实测,must 里放一个极稀疏的 term(命中 12 篇,只落在 6 个段)和一个极稠密的 prefix(展开约 11.7 万个 term):
| must 写法 | prefix.build_scorer_count | 稳态耗时 |
|---|---|---|
[prefix, term] |
36 | ≈ 92 ms |
[term, prefix] |
6 | ≈ 35 ms |
两条查询逻辑等价却差了近 3 倍:prefix 写前面时,其余 17 个段的 term 返回 null 触发整段短路,但 prefix 的 bitset 已经白白建好又扔掉;term 写前面时,这些段根本轮不到 prefix 出场。
💡 结论:稀疏廉价的子句写在前面,让它先行短路,昂贵的多词查询就不会被无效触发。
分界线是 Lucene 9.5(PR #12055):多词查询的 wrapper 自此实现了轻量的 ScorerSupplier,调度阶段只估成本不干活,重活推迟到真正取迭代器时才做,顺序自此真正无关。对应到版本:Easysearch 1.x 基于 Lucene 8.11,存在此问题;Easysearch 2.x 基于 Lucene 9.12,已包含修复——本文的全部结论在其上均成立。
但合取查询的优化目标很明确:所有子句都要匹配,找"最少"的那个领头即可。析取(SHOULD)场景完全不同:不需要全部匹配,而是找 Top-K 高分文档。优化目标从"最少匹配"变为"最高分数贡献",WAND 算法登场——第三篇详解。
作者:冯田立,极限科技(INFINI Labs)Easysearch 搜索引擎研发专家,曾在亚马逊 AWS 有多年的 Elasticsearch 开源插件和 OpenSearch 的开发经验和客户集群的运维经验,并有幸参与 OpenSearch 的创立。
Easysearch 布尔查询子句重排序(一)|你的 BoolQuery 写法,真的影响性能吗?
Easysearch • INFINI Labs 小助手 发表了文章 • 0 个评论 • 5648 次浏览 • 2026-09-29 18:58
从 Easysearch 到 Lucene,查询构建层的 11 条优化规则
INFINI Easysearch 是一款专注于企业级场景的分布式近实时搜索与分析引擎。它以 Apache Lucene 为内核进行了增强,在保持与行业主流搜索协议及开发生态完全兼容的同时,重点强化了安全性、稳定性、压缩率及信创兼容性。
一、开篇:一个常见的误解
"must 里面,是不是应该把匹配文档少的条件写在前面?这样能提前过滤掉大量文档,性能更好?"
这个直觉来得很自然,但它是错的。
┌─────────────────────────────────────┐
│  用户的直觉:                         │
│  must: [高频词, 低频词] → 慢          │
│  must: [低频词, 高频词] → 快          │
│                                     │
│  实际情况:                          │
│  两种写法性能完全相同!                │
│  Lucene 执行时自动按 cost 排序        │
└─────────────────────────────────────┘
Easysearch 执行时会按 cost 自动重排子句顺序,与你写查询时的顺序无关。不过"子句顺序不重要"并非处处成立,它有一条跟版本挂钩的边界——must/filter 里混入 prefix/wildcard 这类多词查询时,老版本引擎会重新对顺序敏感(详见第二篇 §八的边界说明)。而且"子句顺序不重要"也不代表"怎么写都一样"——理解引擎自动优化的边界在哪里,才能设计出更合理的查询结构。
本文是系列第一篇,聚焦构建层:从你发出 JSON 到查询进入执行引擎,中间经历了哪些变换?哪些优化在这个阶段完成?哪些要留到执行层?后续三篇将分别深入合取查询的 cost 排序、析取查询的 WAND 剪枝,以及 Block-Max 块级剪枝与实战验证。
二、全景:一次布尔查询的完整旅程
先建立一张全局地图,再深入每一层。
举个例子:一条布尔查询就像一个包裹进入工厂流水线,经过三道工序:
- 第一道(Easysearch 层):质检员检查包裹格式是否合规,缺不缺东西,但不重新排列里面的物品顺序
- 第二道(Lucene rewrite):工艺师合并重复部件、去掉矛盾组合、把"可选"升级为"必选"——改变的是包裹的内容结构,不是物品顺序
- 第三道(Scorer 层):调度员拿到最终包裹,按每个部件的"处理成本"自动安排加工顺序——这才是代价排序发生的地方
用技术语言描述,这三道工序对应的是(注意①和②③分属不同阶段):
用户 JSON
   │
   ▼
┌──────────────────────────────────────────┐
│  Easysearch 层(构建层)                   │
│  ① doRewrite() — 递归重写 + 早期终止       │
│  ② applyMinimumShouldMatch              │
│  ③ fixNegativeQueryIfNeeded             │
│  (①在 rewrite 阶段,②③在 doToQuery()内)│
│  职责:结构合法化,不改子句顺序              │
└────────────────┬─────────────────────────┘
                 │ toQuery() → BooleanQuery
                 ▼
┌────────────────────────────────────────────┐
│  Lucene rewrite 层(逻辑重写层)             │
│  ④ BooleanQuery.rewrite()                 │
│  (IndexSearcher 中 rewrite→createWeight) │
│  职责:11条逻辑等价改写,不改结果只改形态       │
└────────────────┬───────────────────────────┘
                 │ createWeight()
                 ▼
┌──────────────────────────────────────────┐
│  Scorer 构造层(执行层)                   │
│  ⑤ ConjunctionDISI:按 cost() 排序 ✅    │
│  ⑥ WANDScorer:按 maxScore 动态重排 ✅    │
│  职责:代价感知,真正的性能优化在这里         │
└────────────────┬─────────────────────────┘
                 │
                 ▼
执行查询,返回结果一个关键认知:代价排序发生在第⑤步(Scorer 层)。前两道工序只做逻辑等价改写——合并重复、升级类型、展平嵌套,但不改变查询结果。
本文讲前两层(①~④),后三篇讲第⑤⑥步。
三、Easysearch 层:结构合法化,不碰顺序
你发出的 JSON,首先被 Easysearch 的 BoolQueryBuilder 解析成内部的查询对象。这一层做的事情很克制:保证查询结构合法,但不改变子句顺序。
3.1 子句是如何被添加的
BoolQueryBuilder.doToQuery() 按照固定顺序把子句添加到 Lucene 的 BooleanQuery.Builder 中:
must → mustNot → should → filter不同类型之间的添加顺序是固定的(无论你的 JSON 里先写 should 还是先写 must),但同一类型内的子句顺序与 JSON 书写顺序一致——这通常不影响性能,因为代价排序发生在更下游的 Scorer 层;唯一的例外见第二篇 §八:老版本上混入多词查询时,书写顺序仍会起作用。
3.2 三种特殊处理
Easysearch 层会做三类结构合法化处理:
doRewrite() 的早期终止:
- 如果整个 BoolQuery 为空(没有任何子句),退化为
MatchAllQueryBuilder(等价于 Lucene 的MatchAllDocsQuery) - 如果任何
must或filter子句重写后变为MatchNoneQueryBuilder,整个 BoolQuery 直接返回该MatchNoneQueryBuilder——不需要继续执行 - 如果没有
must/filter子句,但所有should子句都重写为MatchNoneQueryBuilder,整个 BoolQuery 也退化为MatchNoneQueryBuilder——没有必须匹配的子句,所有可选子句又都匹配零文档,结果必然为空
fixNegativeQueryIfNeeded():
当查询只有 must_not 子句、没有任何正向匹配条件时,Lucene 的 BooleanQuery 不知道"从哪些文档里排除"。Easysearch 自动插入一个 MatchAllDocsQuery 作为基础集合。该修复受 adjust_pure_negative 开关控制(默认为 true,可设为 false 关闭):
输入:must_not: [term:spam]
处理:加入 MatchAllDocsQuery (作为 FILTER)
输出:filter: [MatchAll] + must_not: [term:spam]
= "所有文档 除了 spam"applyMinimumShouldMatch():
把用户设置的 minimum_should_match 规格字符串(支持整数 "2"、百分比 "75%"、条件式 "3<75%" 等)解析为 int,写入 Lucene 的 BooleanQuery.setMinimumNumberShouldMatch()。
总结:Easysearch 层不改变子句顺序,只做合法化修补。真正的优化交给下游。
四、Lucene rewrite 层:11 条逻辑等价改写规则
查询经过 toQuery() 变成 Lucene 的 BooleanQuery 对象后,会调用 BooleanQuery.rewrite()。这是本文的核心章节。
这一层不做代价排序,而是通过 11 条规则改写查询的形态——去重、提升、展平——但保证改写前后查询结果完全一致,为后续执行层的高效优化铺路。
📌 本文按理解难度递进排列规则编号。源码中
BooleanQuery.rewrite()实际包含 12 个步骤,本文将其中 SHOULD 去重和 MUST 去重合并为规则 8,并按逻辑将 MatchAll→ConstantScore 编为规则 11,因此源码实际执行顺序按本文编号为:1→2→3→4→5→6→7→8→11→9→10(ConstantScore 转换在展平和 minShouldMatch 对齐之前执行)。
规则 1-3:消除不可能、去重、矛盾检测
这三条是防御性规则,含义很容易理解,快速过一遍:
| # | 规则 | 触发条件 | 行为 |
|---|---|---|---|
| 1 | 空查询消除 | 没有任何子句 | → MatchNoDocsQuery |
| 2 | 单子句拆包 | 只有 1 个子句 | 拆掉 BooleanQuery 外壳,直接用内部查询。SHOULD/MUST 直接返回内部查询;FILTER 包裹为 BoostQuery(ConstantScoreQuery(query), 0)(确保得分为零);MUST_NOT → MatchNoDocsQuery |
| 3 | 递归重写 + MatchNoDocs 短路 | 子句重写后变化,或含 MatchNoDocs | 递归简化每个子句(FILTER/MUST_NOT 先包裹 ConstantScoreQuery 再重写再剥壳,SHOULD/MUST 直接重写);SHOULD/MUST_NOT 中的 MatchNoDocs 直接移除,MUST/FILTER 中的 MatchNoDocs 导致整体短路 |
规则 2 示例:
BooleanQuery { MUST: [TermQuery(status:published)] }
       ↓  rewrite
TermQuery(status:published)

BooleanQuery { FILTER: [TermQuery(status:published)] }
       ↓  rewrite
BoostQuery(ConstantScoreQuery(TermQuery(status:published)), 0)

规则 3 示例:
must: [MatchNoDocsQuery], should: [TermQuery(A)]
       ↓  rewrite(MUST 中含 MatchNoDocs → 整体短路)
MatchNoDocsQuery
规则 4-6:去重、矛盾检测、冗余移除
继续快速过:
| # | 规则 | 触发条件 | 行为 |
|---|---|---|---|
| 4 | FILTER/MUST_NOT 去重 | 相同子句重复出现 | HashSet 自动去重(基于 Query.equals())。SHOULD/MUST 用 Multiset 保留重复(以便后续规则 8 做 boost 求和) |
| 5 | 矛盾检测 | MUST 或 FILTER 与 MUST_NOT 含同一子句,或 MUST_NOT 含 MatchAll | → MatchNoDocsQuery |
| 6 | 冗余 FILTER 移除 | FILTER 与 MUST 重叠,或 FILTER 含 MatchAll | FILTER/MUST 重叠:无条件移除冗余 FILTER;FILTER 含 MatchAll:仅当移除后仍有正向子句时移除(filters.size() > 1 \|\| !mustClauses.isEmpty()) |
规则 4 示例:
filter: [term:active, term:active, range:age>18] → filter: [term:active, range:age>18]

规则 6 示例:
must: [term:active], filter: [term:active, range:age>18] → must: [term:active], filter: [range:age>18]
规则 7:SHOULD + FILTER → MUST 提升 ⭐
触发条件:同一个子查询同时出现在 SHOULD 和 FILTER 子句中。
行为:将该子查询的 SHOULD 子句改为 MUST(原 FILTER 子句直接丢弃,因为 MUST 已隐含了 FILTER 的过滤语义)。源码里会同时下调 minimumNumberShouldMatch(每提升一个子句 minShouldMatch--,循环结束后统一 Math.max(0, minShouldMatch) 确保不低于 0):
- 若提升后
minShouldMatch == 0,mix 路径走 req+opt(ReqOptSumScorer) - 若提升后
minShouldMatch > 0,仍走 conjunction-disjunction mix(ConjunctionScorer(req,opt))
也就是说,规则 7 一定会改变查询形态,但是否切到 ReqOptSumScorer 取决于 minShouldMatch 是否归零。
优化前:
┌───────────────────────┐
│ SHOULD: [term:A]      │
│ FILTER: [term:A]      │
│ SHOULD: [term:B]      │
└───────────────────────┘
         ↓  rewrite
优化后:
┌───────────────────────┐
│ MUST:   [term:A]      │  ← 提升为 MUST!
│ SHOULD: [term:B]      │
└───────────────────────┘
💡 类比:一个人同时是"候选人"(SHOULD)又是"已入职"(FILTER)。既然已经入职,直接列入正式编制(MUST)。
⚠️
minShouldMatch联动:每将一个 SHOULD 提升为 MUST,minimumNumberShouldMatch相应减 1(循环结束后Math.max(0, minShouldMatch)兜底),确保语义等价。例如原有minimum_should_match: 2且两个 SHOULD 中有一个被提升,重写后minShouldMatch变为 1。
规则 8:SHOULD / MUST 去重(boost 求和)
触发条件:SHOULD 或 MUST 中出现了相同的子句(解包 BoostQuery 后底层查询相同)。注意:SHOULD 去重仅在 minimumNumberShouldMatch ≤ 1 时触发;若 minShouldMatch > 1,Lucene 不会合并重复的 SHOULD 子句(多个重复出现在高 minShouldMatch 场景下语义不可简单合并)。MUST 去重则没有此限制,无论 minShouldMatch 为何值都会合并重复的 MUST 子句。
行为:合并重复子句,将它们的 boost 相加。FILTER 和 MUST_NOT 的去重由规则 4 处理(直接删除),而 SHOULD 和 MUST 的重复是有意义的——不同的 boost 意味着不同的评分权重,所以求和保留。不合并的话,同一个 term 会创建两套独立的迭代器,都遍历相同的文档列表,浪费翻倍。
should: [term:hello^1.5, term:hello^2.0, term:world]
       ↓  rewrite
should: [term:hello^3.5, term:world]
(两个 hello 的权重合并:1.5 + 2.0 = 3.5)
💡 类比:一个学生选了同一门课两次,一次记 1.5 学分,一次记 2 学分。不需要上两次课,合并为 3.5 学分即可。
规则 9:SHOULD 嵌套展平 ⭐
触发条件:一个 bool 查询的 SHOULD 子句里,嵌套了另一个纯 SHOULD 的 bool 查询(即内层没有 MUST、FILTER、MUST_NOT,只有 SHOULD,且 minimum_should_match ≤ 1)。
行为:把内层 SHOULD 子句全部"提升"到外层,展平为同一级别的 SHOULD 子句。展平后 WAND 能看到每个子句的独立 maxScore,估算更紧,剪枝更激进;如果不展平,WAND 只能看到内层查询的总体上界(黑盒),剪枝不够狠。
优化前:
       BoolQuery (外层)
      /                \
   SHOULD            SHOULD
  (term:A)        (内层 BoolQuery)
                     /      \
                 SHOULD    SHOULD
                (term:B)  (term:C)

         ↓  rewrite

优化后:
       BoolQuery
      /    |    \
  SHOULD SHOULD SHOULD
(term:A)(term:B)(term:C)实践建议:如果你在 should 里嵌套了多层 bool,且内层全是 SHOULD 子句,EasySearch 会自动展平。但如果内层有 minimum_should_match >= 2,则不会展平(语义不等价),这类情况应尽量手动展平或重构查询结构。
💡 为什么展平能更激进地剪枝?假设内层 bool 有两个子句,maxScore 分别是 8 和 3。展平前,WAND 只看到"这个内层查询最多得 8+3=11 分",不管当前文档匹配了哪些子句,上界永远是 11;展平后,WAND 逐子句检查——某个文档如果不匹配 maxScore=8 的子句,只剩 maxScore=3 的子句可能匹配,上界从 11 降到 3。如果录取线是 5,3 < 5,这个文档不可能入选——直接跳过,不用再算分了。
规则 10:SHOULD 数量与 minimumShouldMatch 的对齐
触发条件:SHOULD 子句数量与 minimum_should_match 的大小关系。
行为:分两种情况:
- SHOULD 数量 < minimumShouldMatch:不可能满足 → 直接返回
MatchNoDocsQuery,省去无用计算 - SHOULD 数量 == minimumShouldMatch:所有 SHOULD 提升为 MUST,从 WANDScorer(调度开销大)转入 ConjunctionDISI(cost 排序,更高效)
should: [A, B],minimum_should_match: 3
       ↓  rewrite(2 < 3,不可能满足)
MatchNoDocsQuery

should: [A, B, C],minimum_should_match: 3
       ↓  rewrite(3 == 3,等价于全部 MUST)
must: [A, B, C]
💡 类比:开会时,如果"3 个可选发言人必须全部到场"——那"可选"就没意义了,等价于"3 个必须到场"。如果要求"3 人到场但只有 2 人可选"——不可能,直接取消会议。
一个容易忽略的场景:在动态拼接查询时(例如从用户的多个筛选条件生成 should,然后设置 minimum_should_match 等于条件数量),这条规则会自动把它转化为更高效的 MUST 查询,无需手动改写。
规则 11:MatchAll + FILTER → ConstantScoreQuery
触发条件:BooleanQuery 恰好只有一个 MUST 子句且为 MatchAllDocsQuery,且至少有一个 FILTER 子句。
行为:将所有 FILTER + MUST_NOT 组成内部 BooleanQuery,整体包裹为 ConstantScoreQuery(绕过评分,返回固定分数),作为外层 MUST 加入;SHOULD 子句加回外层(不丢弃);原始 MatchAllDocsQuery 被消耗。MatchAllDocsQuery 在 BooleanQuery 框架里有额外调度开销,ConstantScoreQuery 执行路径更直接。
⚠️ 注意:纯
filter查询没有 MUST 子句,不满足musts.size() == 1的前提,不触发本规则。FILTER 子句直接进入合取路径,由ConjunctionDISI按 cost 排序处理。
在 11 条规则中,标 ⭐ 的规则 7(SHOULD+FILTER→MUST)和规则 9(SHOULD 嵌套展平)对执行性能影响最大——前者决定子句能否进入 ConjunctionDISI 的 cost 排序路径,后者决定 WANDScorer 能否做全局剪枝。
五、实战:一条 rewrite 规则如何改变执行路径
前面列了 11 条规则,这一节用具体例子展示:构建层的一条 rewrite 规则,如何直接影响执行层的路径选择。
假设你有一个查询:
{
  "bool": {
    "should": [
      { "term": { "status": "published" } },
      { "term": { "category": "ai" } }
    ],
    "filter": [{ "term": { "status": "published" } }]
  }
}
status:published 同时出现在 should 和 filter——规则 7 会把它提升为 MUST,并下调 minShouldMatch。下图假设提升后 minShouldMatch=0,执行路径因此发生根本变化:
┌─────────────────────────────────────────────────────────────────┐
│  没有 rewrite 优化(假设)                                        │
│  minShouldMatch=1,走 conjunction-disjunction mix 路径           │
│                                                                 │
│  ┌────────────────────────────┐                                 │
│  │ ConjunctionScorer          │                                 │
│  │ ├─ FilterScorer            │  published 出现两次:            │
│  │ │  published (score=0)     │  • FILTER 里遍历一遍(只过滤)     │
│  │ └─ DisjunctionSumScorer    │  • SHOULD 里再遍历一遍(评分)     │
│  │    ├─ published            │  = 同一个 term 被两个迭代器        │
│  │    └─ ai                   │    各跑一遍,浪费!               │
│  └────────────────────────────┘                                 │
└─────────────────────────────────────────────────────────────────┘

┌─────────────────────────────────────────────────────────────────┐
│  rewrite 优化后(实际)                                           │
│  minShouldMatch=0,走 req+opt 路径                               │
│                                                                 │
│  ┌────────────────────────────┐                                 │
│  │ ReqOptSumScorer            │  published 只出现一次:           │
│  │ ├─ req: published (有评分)  │  • 作为 MUST,一次迭代同时        │
│  │ └─ opt: ai (可选加分)       │    完成过滤和评分                 │
│  └────────────────────────────┘                                 │
└─────────────────────────────────────────────────────────────────┘优化前,status:published 被两个迭代器各遍历一遍;优化后,一次迭代同时完成过滤和评分——一条 rewrite 规则,改变了执行路径的选择。它不做代价排序,但决定了哪些子句有资格进入更高效的路径。
六、动手验证:用 Profile API 观察 rewrite 效果
理论再多,不如自己跑一遍。Easysearch 的 Profile API 可以直接暴露 rewrite 后的查询形态,不需要读源码,几秒钟就能验证。
6.1 验证规则 7:SHOULD + FILTER → MUST 提升
准备好一个含有 status 和 category 字段的索引,执行:
GET /products/_search
{
  "profile": true,
  "query": {
    "bool": {
      "should": [
        { "term": { "status": "published" }},
        { "term": { "category": "ai" }}
      ],
      "filter": [
        { "term": { "status": "published" }}
      ]
    }
  }
}
找到响应中 profile.shards[0].searches[0].query[0].description 字段(具体格式可能因版本略有不同):
- 你写的:SHOULD + FILTER 并存(两个地方都有
status:published) - 实际执行:
+status:published category:ai
注意 + 前缀——在 Lucene 的查询 description 语法中,+ 表示 MUST,没有符号表示 SHOULD。status:published 前面有 +,说明 rewrite 已经把它提升为 MUST,查询形态已经发生了变化。
6.2 验证规则 10:SHOULD 数量 == minimumShouldMatch → 全部提升为 MUST
GET /products/_search
{
  "profile": true,
  "query": {
    "bool": {
      "should": [
        { "term": { "status": "published" }},
        { "term": { "category": "ai" }}
      ],
      "minimum_should_match": 2
    }
  }
}
profile 的 description 应该显示 +status:published +category:ai——两个 term 都带 + 前缀,说明全部提升为 MUST,这个查询实际上会走第二篇要讲的 ConjunctionDISI 路径,而非 WANDScorer。
6.3 理解 Profile 响应的结构
一个完整的 Profile 响应包含大量信息,但读懂核心字段只需关注三个位置:
{
  "profile": {
    "shards": [{
      "searches": [{
        "query": [{
          "type": "BooleanQuery",
          "description": "+status:published +category:ai",
          "breakdown": {
            "next_doc": 12750,      "next_doc_count": 1,
            "advance":  0,          "advance_count":  0,
            "create_weight": 375375, "create_weight_count": 1,
            "build_scorer":  248958, "build_scorer_count":  2
          },
          "children": [
            { "type": "TermQuery", "description": "status:published", ... },
            { "type": "TermQuery", "description": "category:ai", ... }
          ]
        }],
        "rewrite_time": 146958
      }]
    }]
  }
}
快速解读三个关键位置:
| 字段 | 含义 | 怎么看 |
|---|---|---|
description |
rewrite 后的查询形态 | + 表示 MUST,无前缀表示 SHOULD,- 表示 MUST_NOT |
advance / advance_count |
迭代器跳转的耗时 / 次数 | 第二篇核心指标。count 越小 = 跳转越少 = cost 排序效果越好 |
rewrite_time |
rewrite 阶段的总耗时 | 本文 11 条规则的总执行时间,通常很小(微秒级) |
💡 小技巧:
breakdown里每个指标都有两个 key——xxx是耗时(纳秒),xxx_count是调用次数。想看"做了多少次"看_count,想看"花了多少时间"看不带_count的。
七、小结与预告
我们走完了布尔查询在执行前的两个构建层:
Easysearch 层做的是合法化处理——保持子句顺序,修补极端情况(纯否定、空查询、MatchNone 短路),设置 minShouldMatch。它不会改变你查询的"形状"。
Lucene rewrite 层通过 11 条逻辑等价改写规则改变查询的"形态":
- 规则 1-6 是防御性规则,消除空查询、冗余和矛盾
- 规则 7 和规则 10 是提升性规则,把更多子句导入 ConjunctionDISI 的合取路径,为 cost 排序创造更大的发挥空间
- 规则 9 是为析取优化准备的,展平 SHOULD 嵌套让 WANDScorer 能做全局剪枝
- 规则 8 是评分优化(合并重复 boost),规则 11 绕过不必要的评分计算
这两层都不做代价排序,但它们决定了哪些子句有资格进入更高效的执行路径。
下一篇预告
当 MUST 子句进入 Scorer 构造层,Lucene 会创建 ConjunctionDISI,对所有迭代器按 cost() 升序排序——最稀疏的放在第一位,承担"领头"角色,最大限度地用跳转(advance())跳过不满足条件的文档。
匹配文档最少的迭代器,为什么反而被选来驱动整个遍历?——它产生的候选集最小,所有迭代器的验证次数因此被压到最低。这个看似"以弱领强"的设计,正是合取查询性能优化的核心。我们在第二篇,通过源码、图解和 Profile API 实测,把这个机制讲透。
作者:冯田立,极限科技(INFINI Labs)Easysearch 搜索引擎研发专家,曾在亚马逊 AWS 有多年的 Elasticsearch 开源插件和 OpenSearch 的开发经验和客户集群的运维经验,并有幸参与 OpenSearch 的创立。

〖搜索客社区日报〗第2302期 (2026-09-21)
社区日报 • Muses 发表了文章 • 0 个评论 • 8820 次浏览 • 2026-09-22 21:05
Easysearch 原生集成国密算法:打造全链路自主可控搜索底座(二)
Easysearch • INFINI Labs 小助手 发表了文章 • 0 个评论 • 9798 次浏览 • 2026-09-20 18:32
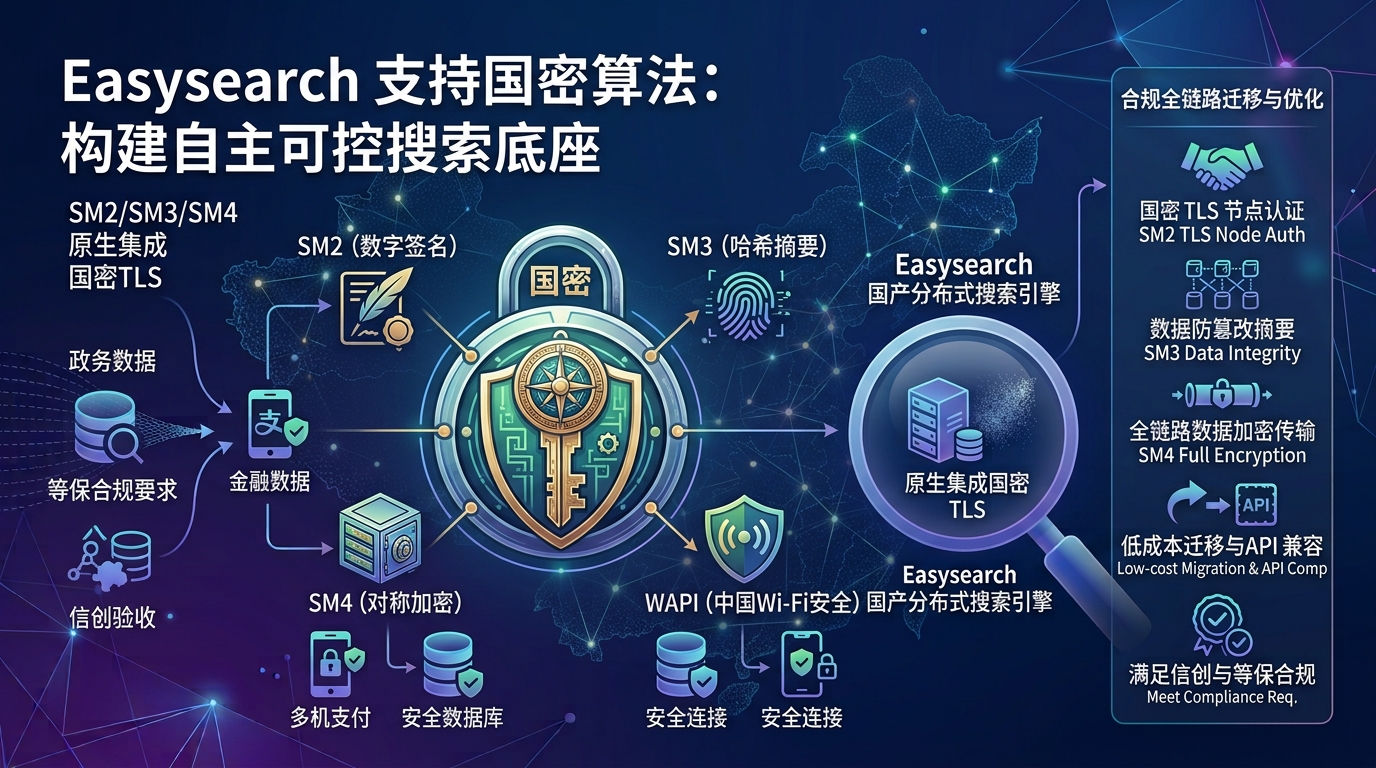
从 2.1.0 版本开始,INFINI Easysearch 内置了对国密(SM2/3/4)算法的支持,实现了全链路国密合规,满足等保及商用密码应用安全性评估要求。本篇以 Kylin-Server V11 操作系统和 Easysearch 2.3.0 进行演示。
Linux 主机安装 Tongsuo
Easysearch 基于 铜锁(Tongsuo)提供国密 TLCP 双证书能力,支持 SM2/SM3/SM4 加密套件。下载完 Easysearch 软件包后解压进目录,执行脚本安装铜锁。
bin/install-tongsuo-local.sh --version 8.4.0
安装完后会有提示切换到铜锁。

能正常查看版本信息,说明安装、切换都正常。

一键初始化(单节点 TLCP)
如需在单节点场景快速完成证书生成、TLCP 配置写入和初始密码设置,可直接使用:
EASYSEARCH_INITIAL_ADMIN_PASSWORD='EasysearchP@ssw0rd!' bin/initialize.sh --tlcp -s执行上面的脚本会自动生成证书,修改 easysearch.yml 证书设置。


启动 Easysearch
从 Easysearch 的启动日志中可看到国密(Chinese SM algorithms)正常加载,并用来创建 SSLContext 。

客户端:用国密栈访问
curl 默认链接的 OpenSSL 密码库不支持国密协议(TLCP),因此 curl 访问 Easysearch 服务时加密协议最终回落到标准 TLS 1.3,套件为国际通用的 TLS_AES_128_GCM_SHA256。

用 Easysearch 发行包自带的 bin/tlcp-curl.sh 访问 Easysearch,可以看到加密套件是国密 TLS_SM4_GCM_SM3。

Java 应用默认使用的 OpenJDK 没有内置国密算法支持,所以不能直接走国密加密;要么换成支持国密的 JDK,要么在现有 JDK 中额外引入并注册国密算法实现。
相关阅读
Easysearch 2.4.0 发布:原生 HNSW 与混合检索,管理体验全面升级
资讯动态 • INFINI Labs 小助手 发表了文章 • 0 个评论 • 9776 次浏览 • 2026-09-20 18:23

INFINI Easysearch 2.4.0 正式发布。本版本将向量搜索纳入内核:基于 Lucene 的原生 HNSW,关键词与语义向量可混合检索。控制台新增可视化 Mapping 编辑器,集群设置可同时查看临时、持久、默认三层配置。生命周期策略、可搜索快照、密钥库与插件管理同步更新,高并发下的字段使用统计和磁盘用量分析也更稳定。
主要更新如下:
功能特性 (Features)
原生 HNSW 向量搜索与混合检索
- 内置基于 Lucene 的 HNSW 向量索引。新建索引可直接使用
dense_vector、query-levelknn和顶层knn,无需安装 k-NN 插件。 - 支持 1~4096 维
float向量,以及cosine、dot_product、l2_norm、max_inner_product四种相似度算法。 - 支持通过
m、ef_construction和num_candidates调整索引构建与查询效果;省略index_options时默认使用hnsw(m=16, ef_construction=100)。 - 支持一个顶层关键词
query与一个顶层knn并列执行,通过结果并集与加权评分实现关键词、语义向量的混合召回。 - 兼容 Elasticsearch 8.19.17 的 float HNSW mapping、Bulk、kNN 查询和 wire 行为,以及 Elasticsearch Java 8.19.17、Python 8.19.3 官方客户端,现有应用可直接对接。
更多用法及兼容边界请参阅原生 HNSW 搜索文档。
可视化 Mapping 编辑器
新增索引页提供可视化 Mapping 编辑器。字段按层级排列成树,可直接编辑类型和参数,无需手写 Mapping JSON。

- 可以从索引模板或已有索引导入配置。创建索引时,也可以关联集群里已有的别名。
- 覆盖全部字段类型。支持多字段,也可为
object/nested添加子字段,同类型字段可批量添加。 - 可视化编辑与 JSON 编辑可随时切换,内容保持同步。
dynamic_templates、_source、_meta等高级内容在切换后仍会保留。
操作步骤见新增索引。
集群设置页
在「设置」中打开集群设置页,查看和修改 _cluster/settings 中的动态配置。页面按节点、索引、分片、断路器、生命周期分组,支持按名称或 key 搜索,也可按临时、持久、默认来源过滤。

- 每个设置有三层值:临时、持久、默认。优先级是临时 > 持久 > 默认。徽标标出当前生效的那一层。
- 布尔和枚举使用下拉框,数字使用数字输入,时间、大小等带单位的值直接填写,例如
60s、40mb。临时层与持久层可一次保存。支持清除单层,也可一键清空全部临时设置。 - 日志级别、分片分配属性、断路器等名称不固定的设置,可先添加实例,再填写取值。

操作步骤见集群设置。
数据管理与分析体验
- 数据探索改用 PIT(Point in Time)分页导出,导出数量不再受
max_result_window限制。 - 生命周期策略编辑器可配置的 action 更多,未填写的字段保持原有语义。
- 快照恢复支持直接恢复为可搜索快照,索引列表增加可搜索快照标识。
- 节点页面新增密钥库管理,插件列表支持从文件夹或 ZIP 包手动上传插件。这两项需先在右上角连接 Agent 后使用。
- 创建 API Token 或角色时,索引权限支持下拉选择和搜索。
rate聚合新增sum、value_count计算模式,并支持在包含单一日期源的composite聚合中计算速率。- DevTools 现支持 SQL 关键词高亮、补全和多行语句解析,查询结果默认返回 CSV。
- 生命周期(ILM)策略管理: 对生命周期策略编辑 UI 进行了全面增强,新建与编辑策略现已支持完整的 action 配置,覆盖 Hot、Warm、Cold、Delete 四个阶段
改进优化 (Improvements)
- 重构
_disk_usage同步分析链路,引入有界请求调度和独立线程池,降低并发磁盘用量分析对普通分析请求的影响。 - 重构
_field_usage_stats的 shard 级字段访问采集链路,按每次查询会话对相同字段和访问类型去重,完善 stored fields、term vectors、can-match、refresh/reopen 及主副分片场景的统计覆盖。 - 优化字段使用统计在高并发查询和大字段 registry 场景下的会话提交与快照生成,减少处理开销和临时对象分配。
问题修复 (Bug Fixes)
- 统一重构 Model Provider、Rules 与 Audit Log 的受保护内部索引权限过滤机制,修复直连、通配符、混合索引及数据流后备索引等场景下过滤语义不一致的问题;无权限用户直接访问受保护资源时会被拒绝,在混合或通配符请求中则隐藏相关资源,同时保留远程索引表达式和 Audit Log 的角色授权语义。
- 修复 Remote Reindex 对远端 Elasticsearch REST 协议版本判断不准确的问题,恢复 Elasticsearch 6.8.x、7.x 和 8.x 场景下 scroll 与 clear-scroll 请求的正确格式。
- 修复删除关联多个索引的别名失败的问题。
- 修复授权弹窗打开后「授权提示」页签可能自动消失的问题。
- 修复未授权状态显示为不规范英文的问题,现按界面语言显示「未授权 / Unlicensed」。
- 修复创建用户、角色、管道、模板、远程集群、快照仓库、自动跟随模式、规则库时重名可能覆盖已有配置的问题,现在会提示名称已存在。
- 修复编辑管道时可修改名称导致旧管道残留的问题,编辑时名称改为不可修改。
- 修复删除管道确认弹窗文案误写为「模板」的问题。
- 修复列表页左侧聚合过滤侧边栏输入关键字后无法筛选的问题。
- 修复分片列表点击刷新不重新加载数据的问题。
- 修复热点线程页面选择不支持的 gpu/mem 类型后列表为空且无提示的问题,下拉现仅提供受支持的类型。
- 修复创建角色无法选择粗粒度 action group,以及集群权限与索引权限被强制必填的问题。
- 修复数据探索导出超过 10000 条文档失败的问题。
- 移除生命周期策略编辑器中错误的节点标签缺失实时提醒。
- 修复节点详情插件页显示集群级安装状态的问题:插件只装在部分节点时,未安装的节点也会显示「已安装」;现在按当前节点过滤。
- 修复删除生命周期策略时确认弹窗不显示策略名的问题。
- 修复删除快照确认弹窗误用「策略」且不显示快照名的问题。
- 修复创建生命周期策略时前端重名校验不生效的问题。
升级提示
- 原生 HNSW 的已索引
dense_vector字段只能添加到由 2.4.0 或更高版本创建的索引,且所有数据节点均需升级到 2.4.0 或更高版本;旧索引需新建目标索引后通过 Reindex 迁移。 - 旧 k-NN 插件的
knn_dense_float_vector、knn_sparse_bool_vector和knn_nearest_neighbors接口继续保留,但新旧字段与查询语法不能混用。 - Easysearch 2.4.0 使用未量化的 float HNSW,当前不支持
int8_hnsw等量化向量类型。通过 Elasticsearch 8.19 官方客户端访问时,需在所有节点设置elasticsearch.api_compatibility: true和elasticsearch.api_compatibility_version: "8.19.17",并重启节点。
以上为本版本重点更新摘要,完整变更与技术细节请查看 Easysearch 产品 Release Notes 或联系我们的技术支持团队
获取新版本
INFINI Easysearch v2.4.0 已正式发布,欢迎升级体验:
- 下载地址:https://infinilabs.cn/download/
- 快速开始:https://docs.infinilabs.com/easysearch/main/docs/quick-start/
关于 Easysearch

INFINI Easysearch 是一款分布式搜索引擎,支持结构化和非结构化的数据检索、全文检索、向量检索、空间地理位置信息检索、组合查询、多语种支持、语义分析和聚合分析等多种功能。
Easysearch 基于 Lucene 构建,紧跟 Lucene 最新版本持续迭代更新,采用商用友好协议,企业可自由部署、二次开发和商业化,无协议合规风险。
Easysearch 致力于为企业提供轻量、安全、自主可控的搜索平台,不断完善产品能力,满足更多企业级需求。

【搜索客社区日报】第2274期 (2026-07-27)
社区日报 • Muses 发表了文章 • 0 个评论 • 10178 次浏览 • 2026-09-17 18:59
【搜索客社区日报】第2298期 (2026-09-14)
社区日报 • Muses 发表了文章 • 0 个评论 • 7704 次浏览 • 2026-09-14 07:37
【搜索客社区日报】第2296期 (2026-09-07)
社区日报 • Muses 发表了文章 • 0 个评论 • 10751 次浏览 • 2026-09-07 14:40
Easysearch 原生集成国密算法:打造全链路自主可控搜索底座(一)
Easysearch • INFINI Labs 小助手 发表了文章 • 0 个评论 • 11832 次浏览 • 2026-08-28 19:51
国密算法:藏在手机里的"中国锁"
你有没有想过,每次扫码付款、刷身份证进站、在政务 App 上查社保时,是谁在背后保护你的信息安全?
答案可能比你想象得更"国产"——它叫国密算法。你可以把它理解成一套完全国产自研的"数字锁"。
什么是国密?
"国密"是国家商用密码的简称,由国家密码管理局制定管理。
打个比方:以前咱家装锁,大多是国外品牌,钥匙齿形设计也是人家的专利。万一厂家留了后门,你家大门就等于敞开了。国密算法干的活儿,就是给整个数字社会换上一把完全国产、自主可控的"中国锁"。
这个"锁具家族"成员不少:
SM2:负责数字签名,相当于给数据盖防伪章;
SM3:负责生成"数字指纹",谁改了一个字都能被发现;
SM4:负责把数据搅成乱码,只有对的人才能还原;
SM9:更神奇,直接用手机号或邮箱就能加密。
注:SM = "商密"拼音首字母,不是什么神秘代号 😄
国密到底保护了什么?
手机支付时,SM4 把金额、账号搅成乱码传输,黑客截到也只能干瞪眼。
刷身份证时,SM2 给身份信息盖了个电子防伪章,系统一验便知真假,冒牌货秒露馅。
电子病历流转时,SM3 算出唯一指纹,谁偷偷改了一个诊断结论,系统立刻报警。
连Wi-Fi时,新国标 WAPI 协议用 SM4 建了一条加密隧道,邻居蹭到信号也看不懂你在干嘛。
为什么非要自己的密码体系?
2013 年斯诺登曝光的"棱镜计划"给了全世界一记警钟:美国 NSA 曾在多个国际加密标准中埋后门。这就像你家装了进口智能锁,厂家手里却攥着一把万能钥匙。 一个 14 亿人的国家,金融、电力、通信、政务如果全靠别人的加密技术,风险可想而知。
国密的意义,就是把信息安全的主导权,实实在在地握在自己手里。
国密到底牛在哪?
更安全:SM2 基于椭圆曲线密码学,256 位的安全性相当于 3072 位的RSA,而密钥更短意味着手机运算更快、更省电。
更高效:SM3 的哈希速度比国际主流的 SHA-256 快约 30% ,处理海量数据时优势明显。
自主可控:从数学原理到代码实现全是自己人搞的,每一行逻辑都经得起审查,没有后门。
走向世界:2018 年,SM2/SM3/SM9 正式成为 ISO 国际标准,中国密码技术获得了全球认可。
Easysearch:给搜索引擎也装上"中国锁"
说到这儿你可能要问:国密算法除了在支付、身份证里用,企业后台系统能用吗?
当然能。现在很多国产基础软件已经把国密原生集成进去了,比如国产分布式搜索引擎 Easysearch。
Easysearch 是国产自研的搜索型数据库,主要干数据分析、全文检索、数据洞察的活儿,在不少政企系统里担任"数据管家"。它最大的亮点之一,就是天生带着国密基因。
Easysearch 基于铜锁(Tongsuo)实现了完整的国密 TLS 能力:SM2 为集群节点签发"国密身份证",防止冒名顶替;SM3 负责哈希摘要与签名校验,防篡改、防抵赖;SM4 将节点间通信与 HTTPS 传输全部加密,链路全程国密护航。
更重要的是,Easysearch 兼容 Elasticsearch 的 API,企业原来跑在国外搜索引擎上的业务,可以较低成本切过来,换个国产发动机,锁换成中国锁,车还能照开。这对政务、金融、能源等强监管行业来说,意味着能同时满足信创验收和等保合规的双重要求。
国密离你有多近?
比你以为的要近得多:新发的银行卡芯片、二代/三代身份证、各地的"一网通办"、"粤省事、""浙里办"、国产手机的支付模块、智能网联汽车的通信模块……甚至你查社保时后台跑着的搜索引擎,很可能都已经用上了国密算法。
下次刷身份证、扫码付款、登录政务 App 的时候,不妨想一想:在你看不见的地方,一串中国自主研发的算法正在默默守护着你的隐私。
写在最后
密码技术听起来硬核,但它守护的东西其实很柔软——是你的钱、你的隐私、你的身份,是一个国家数字社会的安全底座。从手机支付里的 SM4,到政务系统里的 SM2 签名,再到 Easysearch 这类国产基础软件的国密原生集成,国密算法的普及不是一句口号,而是像空气一样,无声地渗透进我们生活的每个角落。
下次有人问你"国密是什么",你可以这样回答:
"就是咱们中国自己造的'锁',专门给数字时代的宝贝上锁。现在,连搜索引擎都用上了这把'中国锁'。"
相关阅读
信创生态再扩容|极限科技 Easysearch、Coco AI 等产品与超聚变 FusionOS 26 完成双架构兼容性认证
资讯动态 • INFINI Labs 小助手 发表了文章 • 0 个评论 • 11456 次浏览 • 2026-08-26 19:17
近日,极限数据(北京)科技有限公司(简称:极限科技)与超聚变数字技术股份有限公司(简称:超聚变)完成产品兼容性互认证。极限科技旗下 INFINI Easysearch 搜索引擎软件、INFINI Gateway 极限网关软件、INFINI Console 极限控制台管理系统、Coco AI 智能搜索软件,与超聚变服务器操作系统 FusionOS 26,基于 X86、ARM 双架构完成严格的兼容性测试验证,并形成双方盖章确认的技术认证。

本次认证经过双方联合严格测试,验证结果显示,极限科技四款产品在 FusionOS 26 操作系统环境下功能运行正常、性能表现稳定,可完美适配 X86、ARM 主流国产化硬件架构,能够满足政企、金融、能源、政务等多行业场景下,海量数据检索、数据网关调度、集群运维管理、AI 智能检索等业务落地需求。
作为国产分布式搜索与智能检索领域核心厂商,极限科技打造的 INFINI 系列产品与 Coco AI,是面向海量数据场景的国产化基础软件,可作为 Elasticsearch 的国产化替代方案,广泛应用于日志检索、业务搜索、数据中台、智能问答等场景。超聚变 FusionOS 26 是面向服务器场景的国产企业级操作系统,支持多架构算力,具备高可靠、高性能、安全可信的特性,是信创基础设施中的核心底座之一。
此次全系列产品与超聚变 FusionOS 26 完成双架构适配认证,标志着极限科技产品在国产算力底座上的适配能力进一步完善,丰富了信创软硬件生态组合方案。后续双方将持续深化技术协同与生态合作,联合打造稳定成熟的国产化数据检索与智能应用解决方案,助力各行业数字化、信创化转型落地。
从国产替代到自主创新:极限科技亮相 DTCC 2026,分享 Easysearch 信创实践
Easysearch • INFINI Labs 小助手 发表了文章 • 0 个评论 • 11338 次浏览 • 2026-08-26 16:27
8月20–22日,第17届中国数据库技术大会(DTCC 2026)在北京朗丽兹西山花园酒店举行。本届大会由 IT168 联合 ITPUB 主办,以“融数聚智 创领未来”为主题,汇聚众多数据库领域专家、技术从业者与企业代表,围绕数据库内核、云原生、AI、向量数据库、实时数仓、分布式数据库及行业实践等热点展开深入交流。
在8月21日下午的【向量数据库技术实践】专场,极限科技 CEO 曾勇带来主题分享《从国产替代到自主创新:Easysearch 在搜索引擎领域的信创实践》,从 AI 时代搜索引擎的新定位出发,系统分享搜索引擎国产化面临的关键挑战,以及 Easysearch 在兼容迁移、企业级能力、信创适配、安全容灾和 AI 搜索等方面的实践探索。

一、AI 时代,搜索引擎正在从“工具”走向“基础设施”
过去,搜索引擎主要承担“找到信息”的任务,以关键词匹配、倒排索引、全文检索和 BM25 等技术为核心,服务于企业文档搜索、网站搜索、日志检索和数据查询等场景。
而随着大模型、RAG 和 Agent 快速发展,搜索正在发生新的变化。
从“匹配字面”走向“理解语义”,从“返回结果”走向“辅助决策”,搜索引擎正在成为连接企业数据与 AI 能力的重要基础设施。

在曾勇的分享中,他将这一变化概括为:
从“找信息”走向“用知识”。
如今,企业知识库、智能客服、运维诊断助手、合规审查,以及多模态搜索、Agent 自主搜索等应用,都离不开高质量的检索能力。搜索引擎也因此成为 RAG 和 Agent 获取知识、理解上下文的重要底座。
这也意味着,搜索引擎一旦从普通工具升级为企业 AI 基础设施,其稳定性、安全性以及自主可控能力的重要性将进一步提升。
二、国产替代,不能只是“换一个引擎”
随着信创建设持续深入,国产化正在从基础设施和外围系统逐步进入核心业务与数据基础设施领域。
在曾勇看来,搜索引擎国产化并不是简单完成一次产品替换,而是一项涉及业务连续性、数据迁移、技术自主、安全合规和长期演进能力的系统工程。

因此,在进行搜索引擎国产化选型时,至少需要重点关注五个方面:
- 自主可控:核心引擎和关键技术是否真正掌握在自己手中;
- 企业级稳定性:能否支撑 TB/PB 级数据、高并发和 7×24 小时稳定运行;
- 信创真实适配:能否真正适配国产 CPU、操作系统等基础环境;
- 安全治理能力:权限、审计、加密、脱敏等能力是否能够内建;
- 长期演进能力:能否持续支撑向量检索、AI 搜索、多模态搜索等未来需求。
归根结底,企业选择的并不仅仅是一套搜索软件,而是未来数年持续承载企业数据和 AI 应用的技术底座。
三、从“敢替”到“好用”,Easysearch 持续构建企业级搜索底座
围绕企业国产化过程中最关心的“怎么替、怎么迁、怎么回退、谁来服务、如何运维”等问题,极限科技持续围绕 Easysearch 完善从搜索引擎内核到企业级平台的完整能力体系。
作为企业级分布式搜索型数据库,Easysearch 支持非结构化数据检索、全文检索、向量检索、地理位置查询、组合索引查询、多语种搜索和聚合分析,并提供企业级安全与管理能力。

1. 兼容生态,让迁移更平滑
对于已经大规模使用 Elasticsearch 的企业而言,迁移成本往往是国产替代过程中最现实的问题之一。
针对这一挑战,Easysearch 持续强化兼容能力,覆盖 REST API、Java/Python/Go/Node.js SDK、Query DSL,以及 ES 6.x/7.x/8.x 数据读写,并兼容 Kibana、Logstash、Beats、Filebeat 等常见生态工具。同时针对龙芯、鲲鹏、飞腾以及麒麟、统信 UOS 等国产软硬件环境开展适配。
这意味着企业在推进国产化时,可以尽可能复用现有应用、技术栈和运维经验,降低迁移改造成本。
2. 企业级能力,让国产搜索真正“好用”
国产化的终点并不是“能够运行”,而是能够真正支撑企业核心生产业务。
Easysearch 从内核层面持续补齐企业级能力,包括 TLS 加密、RBAC/ABAC 权限控制、字段级脱敏、LDAP/AD 认证、IP 黑白名单、防暴力破解、磁盘及快照加密、限流限速、审计日志、文档级权限以及国密算法等能力。
在安全与容灾方面,Easysearch 支持 SM2、SM3、SM4 国密算法,并提供全量/增量 Snapshot 备份、备份文件加密、跨集群复制以及跨机房部署等能力,为金融、政务等高安全、高可靠场景提供基础支撑。
四、从全文检索到向量检索,为 AI 应用打好搜索底座
AI 时代,搜索引擎需要解决的不再只是“关键词能不能搜到”,还需要理解数据背后的语义。
Easysearch 已将全文检索、向量检索与混合搜索能力统一在同一引擎中,支持 kNN 向量检索、HNSW/LSH 等向量索引方式,并支持 BM25 全文检索与向量相似度的双路召回和融合排序。

通过统一搜索引擎承载全文、向量和混合检索,可以减少企业额外部署独立向量数据库带来的架构复杂度与运维成本,并进一步支撑语义搜索、RAG、Agent 长期记忆、企业知识库和多模态检索等场景。
这也是 Easysearch 从传统搜索基础设施向 AI Search Infra 演进的重要一步。
五、立足自主研发,持续深耕搜索基础设施创新
本次 DTCC 2026 的技术分享,是极限科技对国产搜索信创实践的一次集中输出。未来,极限科技将继续坚持自主创新路线,以 Easysearch 为基础,进一步完善企业级搜索、向量检索、AI 搜索和自主可控能力,推动搜索基础设施从“国产替代”走向“自主创新”,为企业数智化与 AI 应用发展构建更加安全、稳定、开放、可持续的搜索技术底座。
CDC、查询卸载与 AI 检索:达梦 × Easysearch 技术交流干货回顾
Easysearch • INFINI Labs 小助手 发表了文章 • 0 个评论 • 10014 次浏览 • 2026-08-14 11:14
在金融行业数字化转型与信创建设持续推进的背景下,如何让国产数据库更好地支撑海量数据检索、实时分析与智能应用,成为越来越多企业关注的话题。
8 月 7 日,围绕 “达梦数据库 × Easysearch 金融行业搜索与分析加速方案”,我们开展了一场技术主题分享与交流活动。 由 极限科技技术专家杨帆 从金融行业实际业务需求出发,深入介绍了达梦数据库与 Easysearch 的协同架构,并围绕数据同步、查询卸载、性能优化以及国产化生态合作等问题,与参会伙伴展开了深入交流。
本次分享的核心方案,是通过 “达梦数据库 + CDC 实时同步 + Easysearch” 构建事务与检索分析分离的架构:达梦继续承担核心事务处理和主数据管理,Easysearch 则承接全文搜索、海量数据检索、多维分析以及 AI 检索等场景,让两套系统各司其职,共同提升数据服务能力。
一、为什么需要“数据库 + 搜索引擎”?
传统关系型数据库在 OLTP 场景下具有强一致性、事务处理和数据管理等优势,但当业务逐渐面临海量数据全文检索、多维聚合分析以及复杂搜索体验等需求时,单纯依赖数据库往往会面临新的挑战。
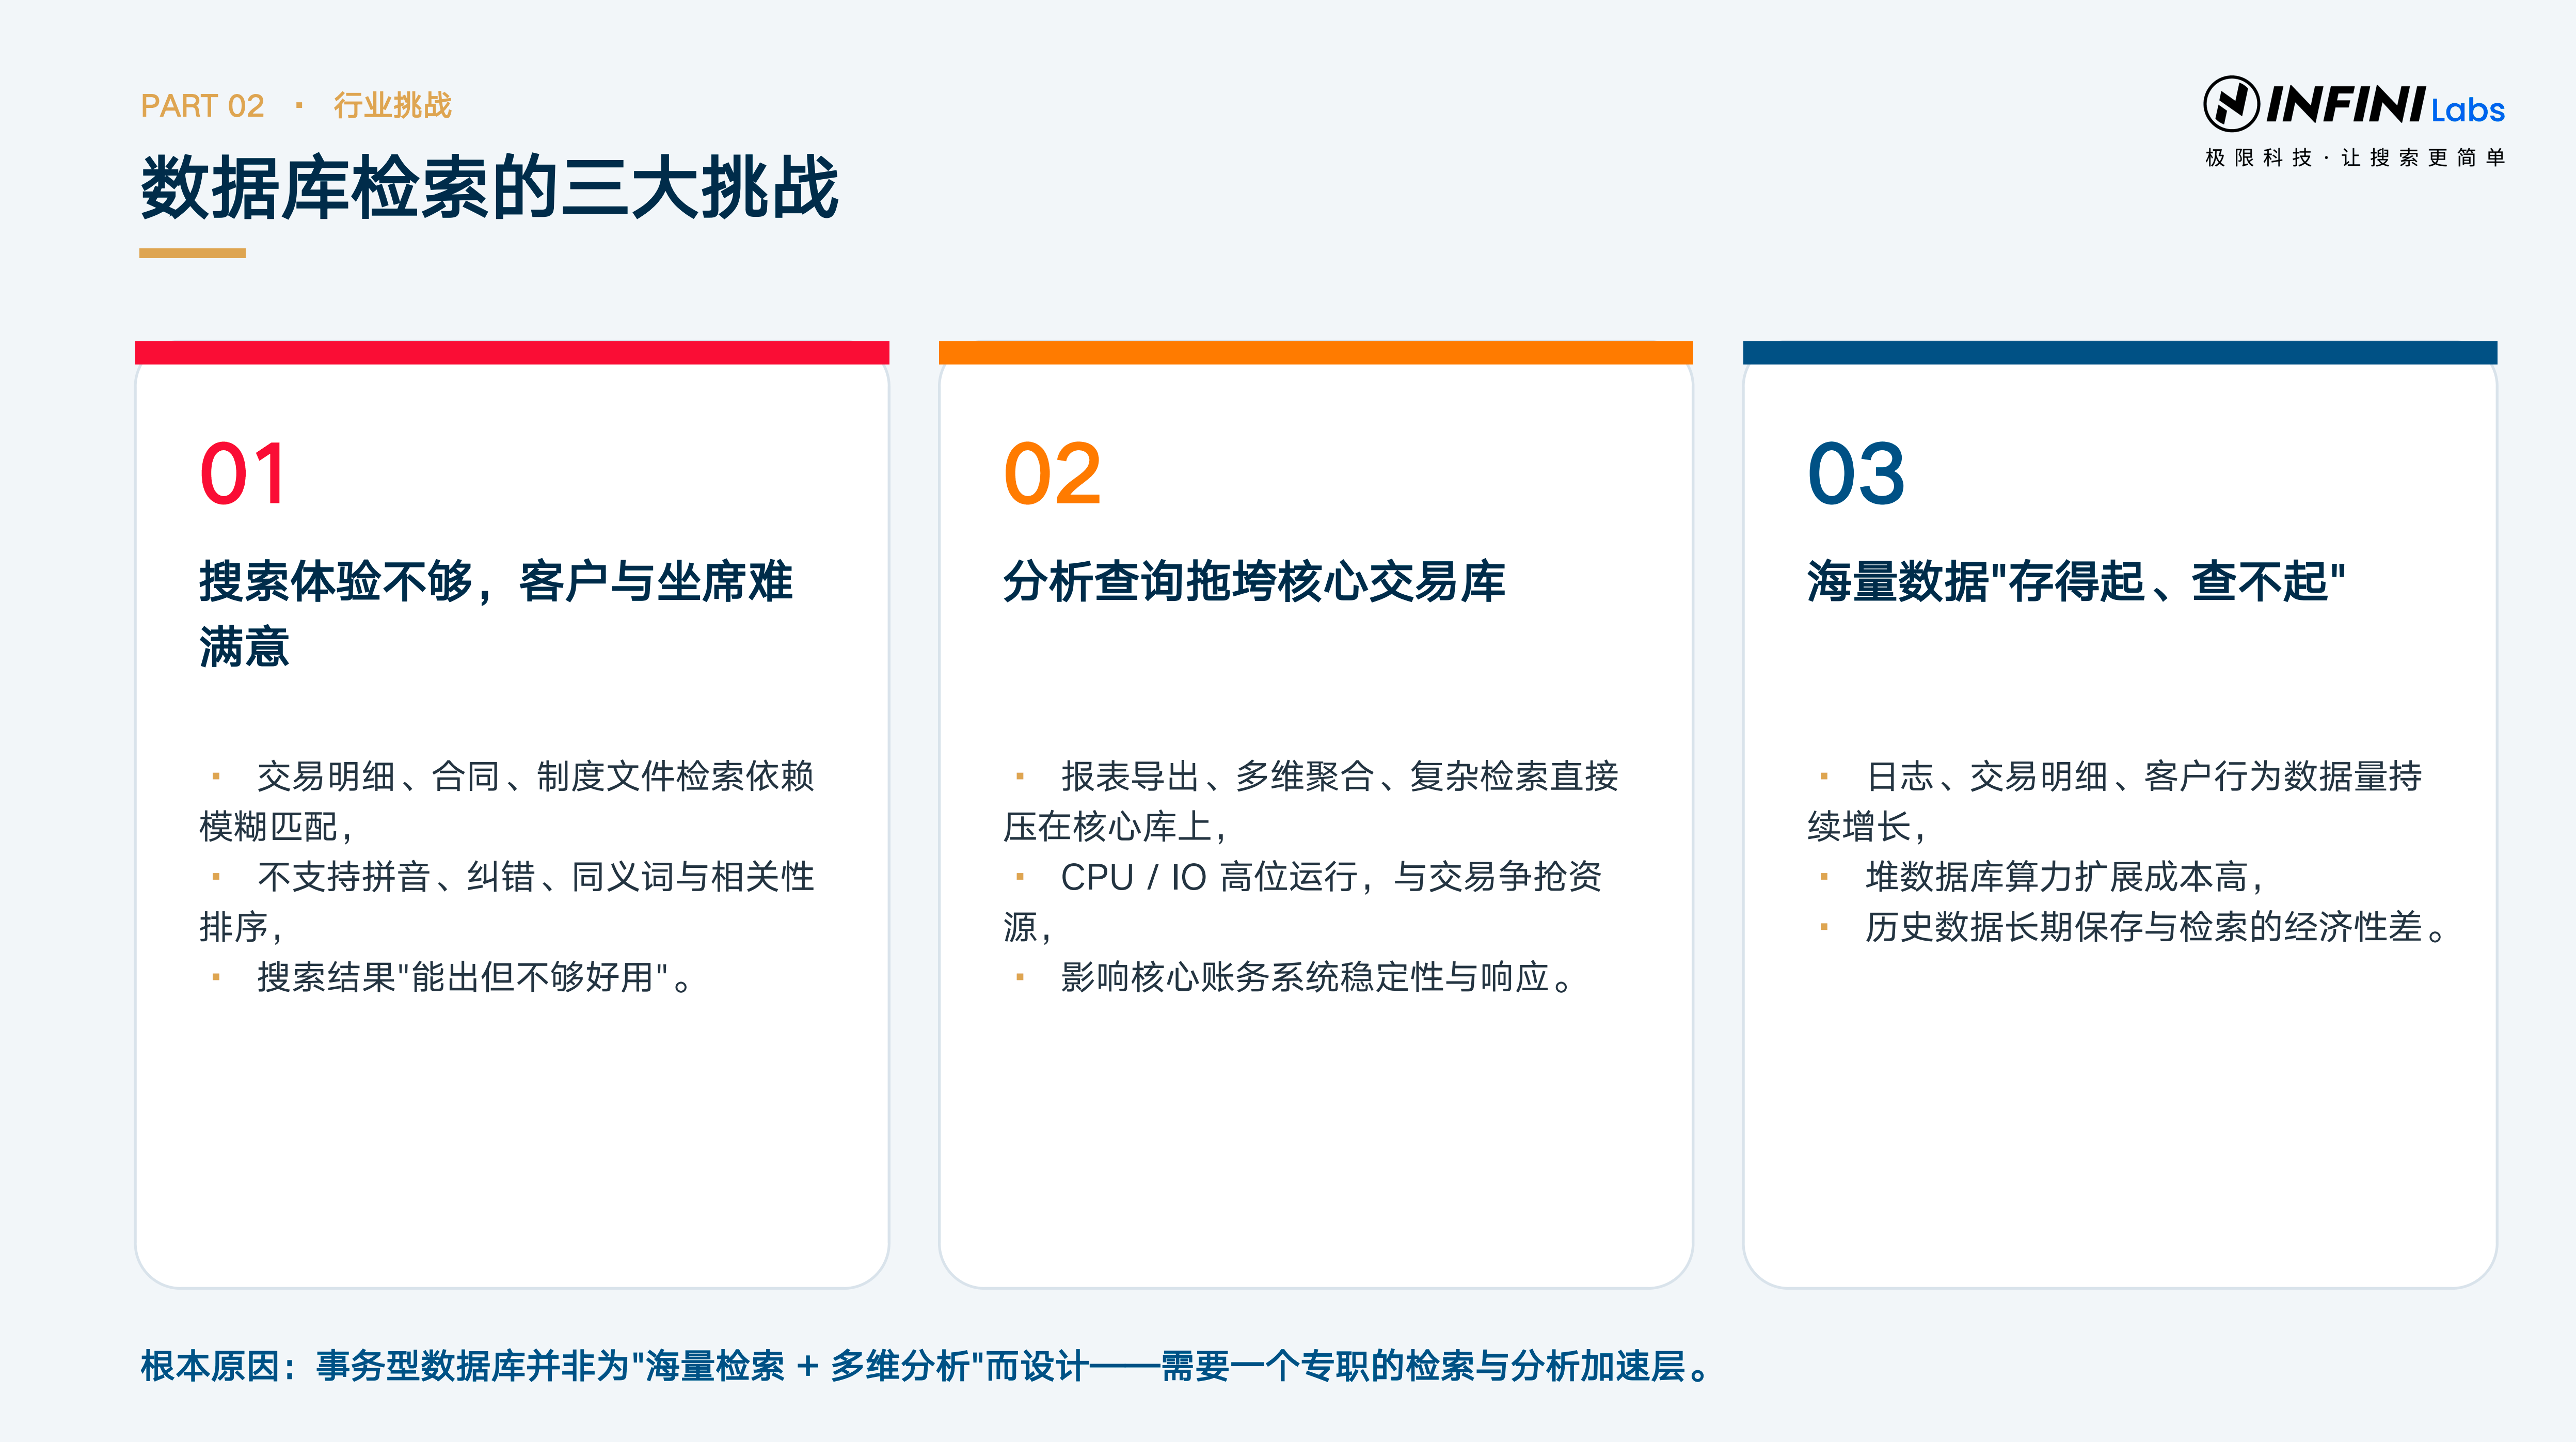
例如在金融场景中,交易明细、合同与制度文件、客户信息、日志数据等都需要被快速检索;与此同时,大量报表、聚合分析和历史数据查询又可能与核心交易业务争抢 CPU、IO 等资源。
分享中提到,达梦擅长 OLTP 事务处理、强一致性、数据安全与审计等能力,而在全文检索、相关性排序以及海量检索分析等方面,则可以通过 Easysearch 进行能力补充。
因此,方案的核心思路并不是简单地“用 Easysearch 替换数据库”,而是:
让数据库专注事务,让搜索引擎专注搜索与分析。
达梦负责写入、更新、事务一致性以及主数据管理;Easysearch 则负责从海量数据中快速“找出来、关联起来”,承接搜索、聚合、向量检索及 AI 等查询型负载。
二、CDC:连接事务库与检索分析库的关键纽带
在这样的架构中,如何让达梦中的数据及时同步到 Easysearch,是大家非常关注的问题。
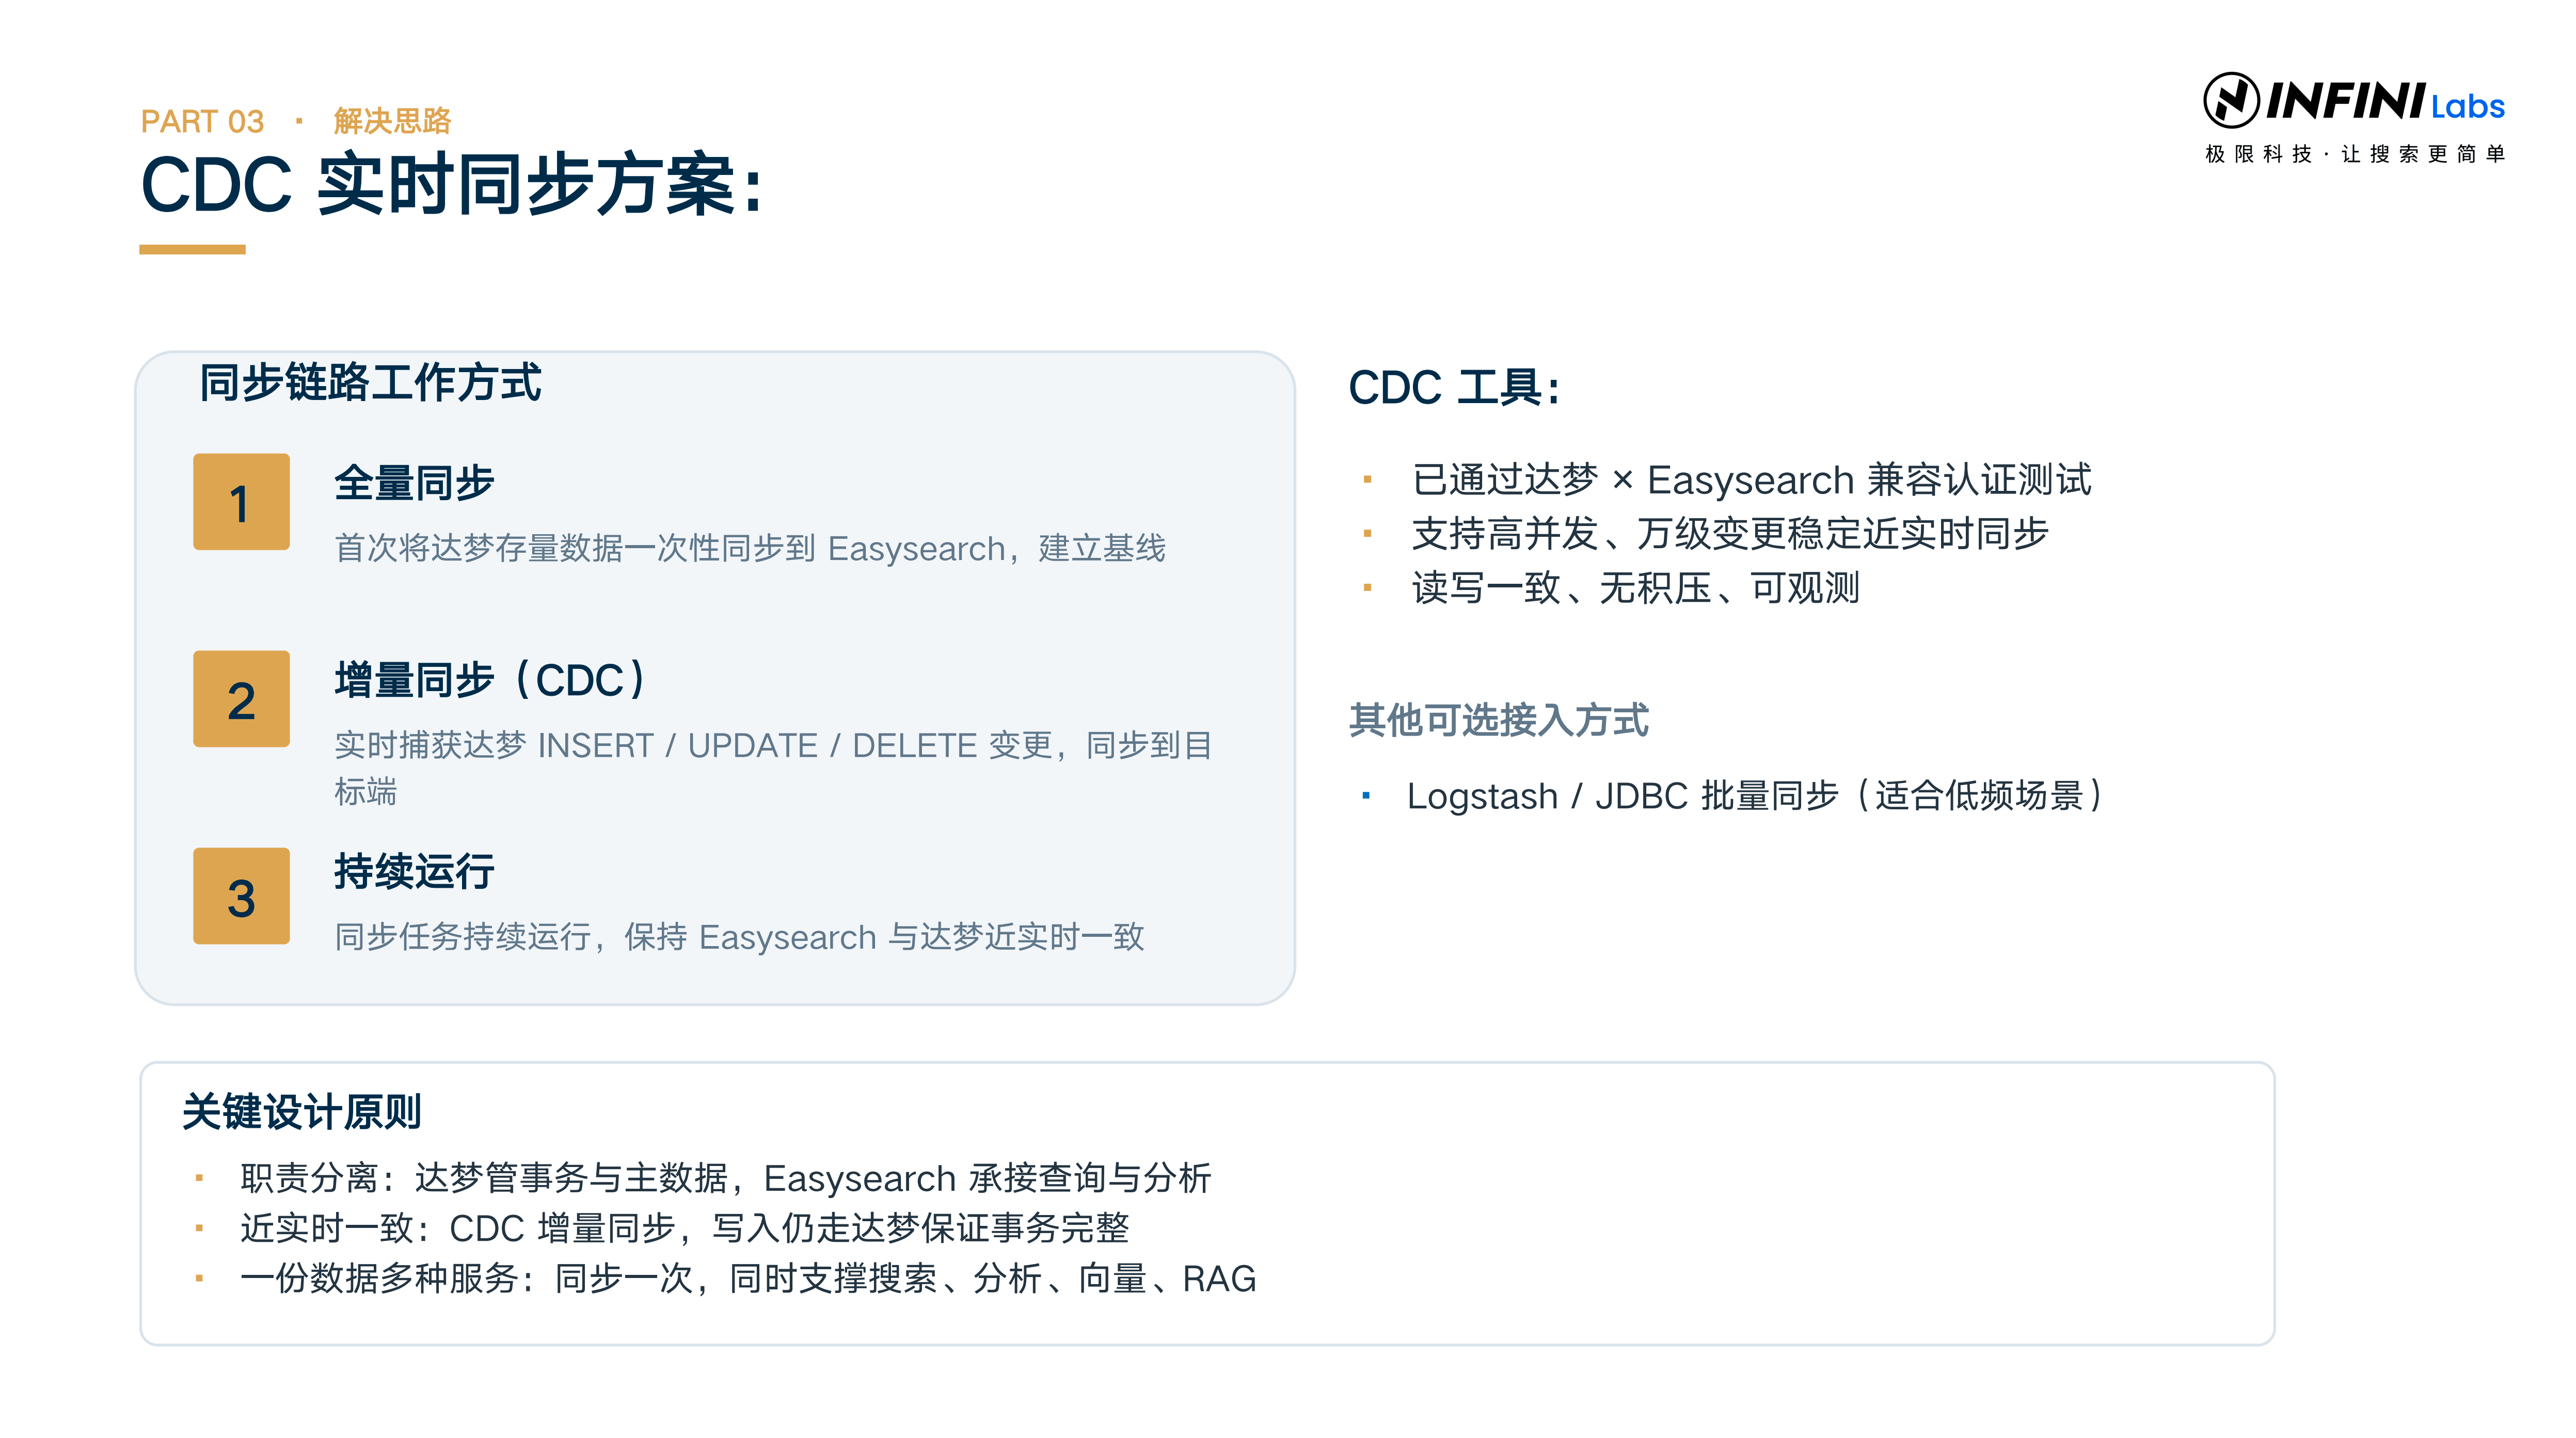
本次方案采用 CDC 实时同步 的方式,整体链路包括三个阶段:
全量同步 → 增量同步 → 持续运行
首先将达梦存量数据同步至 Easysearch,建立数据基线;随后通过 CDC 持续捕获 INSERT、UPDATE、DELETE 等数据变化,并实时同步到 Easysearch,最终形成持续运行的数据同步链路。
在分享介绍的测试验证中,达梦 DM8 × Easysearch 已完成兼容认证测试,全量同步和增量同步均验证通过;在 CDC 高压同步测试中,万级变更可在 30 秒内完成同步,并实现读写一致、无积压。
三、现场技术交流:从“方案介绍”走向“实际问题”
相比单向的技术分享,本次活动更加精彩的部分,是分享结束后的互动交流。
围绕方案在真实生产环境中的落地,参会伙伴提出了多个非常有针对性的问题,分享老师也结合方案设计和实际经验进行了逐一解答。
1. CDC 延迟一般是多少?
CDC 是整个架构实现近实时数据同步的关键,因此大家首先关注了:
从达梦发生数据变更,到 Easysearch 可以查询到数据,中间通常存在多大的延迟?
这个问题实际上不仅涉及 CDC 本身,还与源端产生变更的速度、网络、同步任务处理能力以及目标端写入性能等多个因素相关。
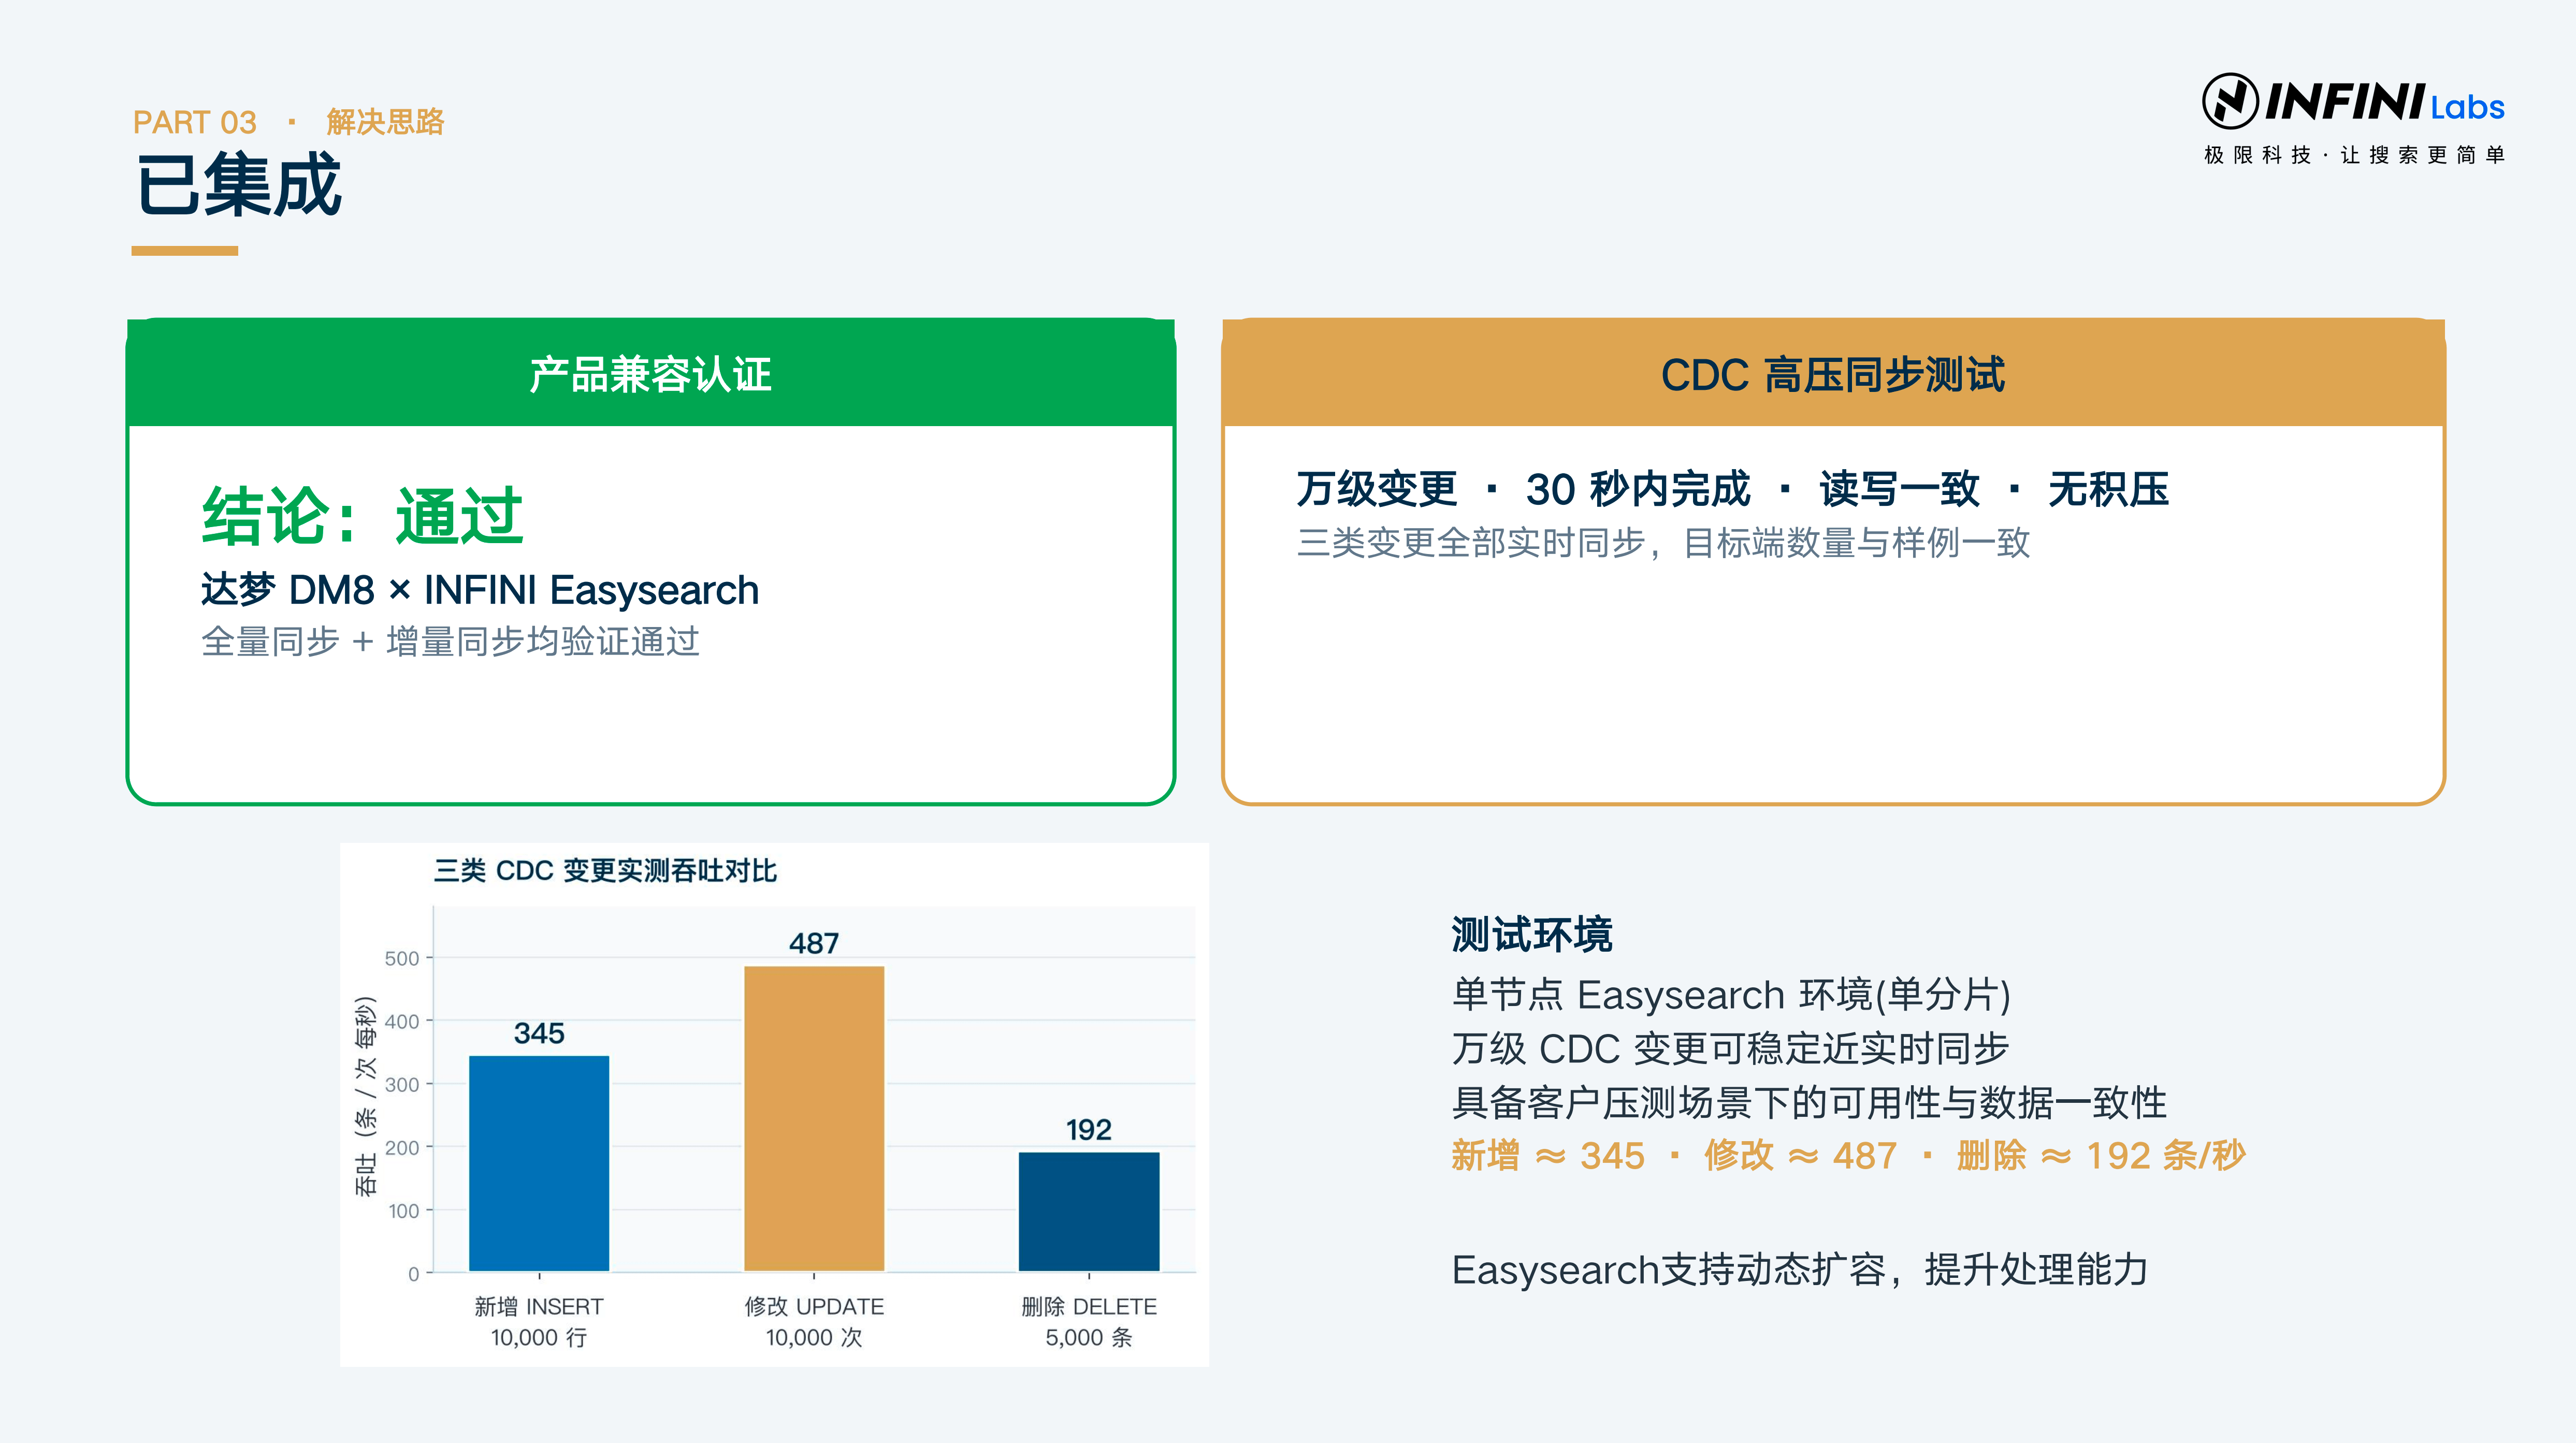
在常规业务负载下,CDC 增量同步延迟可控制在秒级;如果业务变更量更高,可通过 Easysearch 动态扩容分片、增加 CDC 同步并发等方式进一步降低延迟,满足金融级近实时数据一致性要求。
2. 哪些查询适合留在达梦?哪些查询适合放到 Easysearch?
这是现场非常有代表性的一个问题。
实际上,“哪些数据进入 Easysearch”并不是简单按照表来划分,而更应该按照 业务访问模式和查询类型 来判断。
例如:
- 强事务、强一致性的核心业务操作,继续留在达梦;
- 精确查询、事务处理以及主数据维护,继续由达梦负责;
- 全文搜索、模糊查询、相关性排序等场景,可以交给 Easysearch;
- 海量数据检索、多维聚合分析、历史数据查询等,可以通过 Easysearch 进行查询卸载;
- 面向 AI 的向量检索、混合检索和 RAG 等场景,则可以进一步利用 Easysearch 的搜索能力。
这种“按负载类型进行职责分工”的方式,也是整个方案设计的核心。
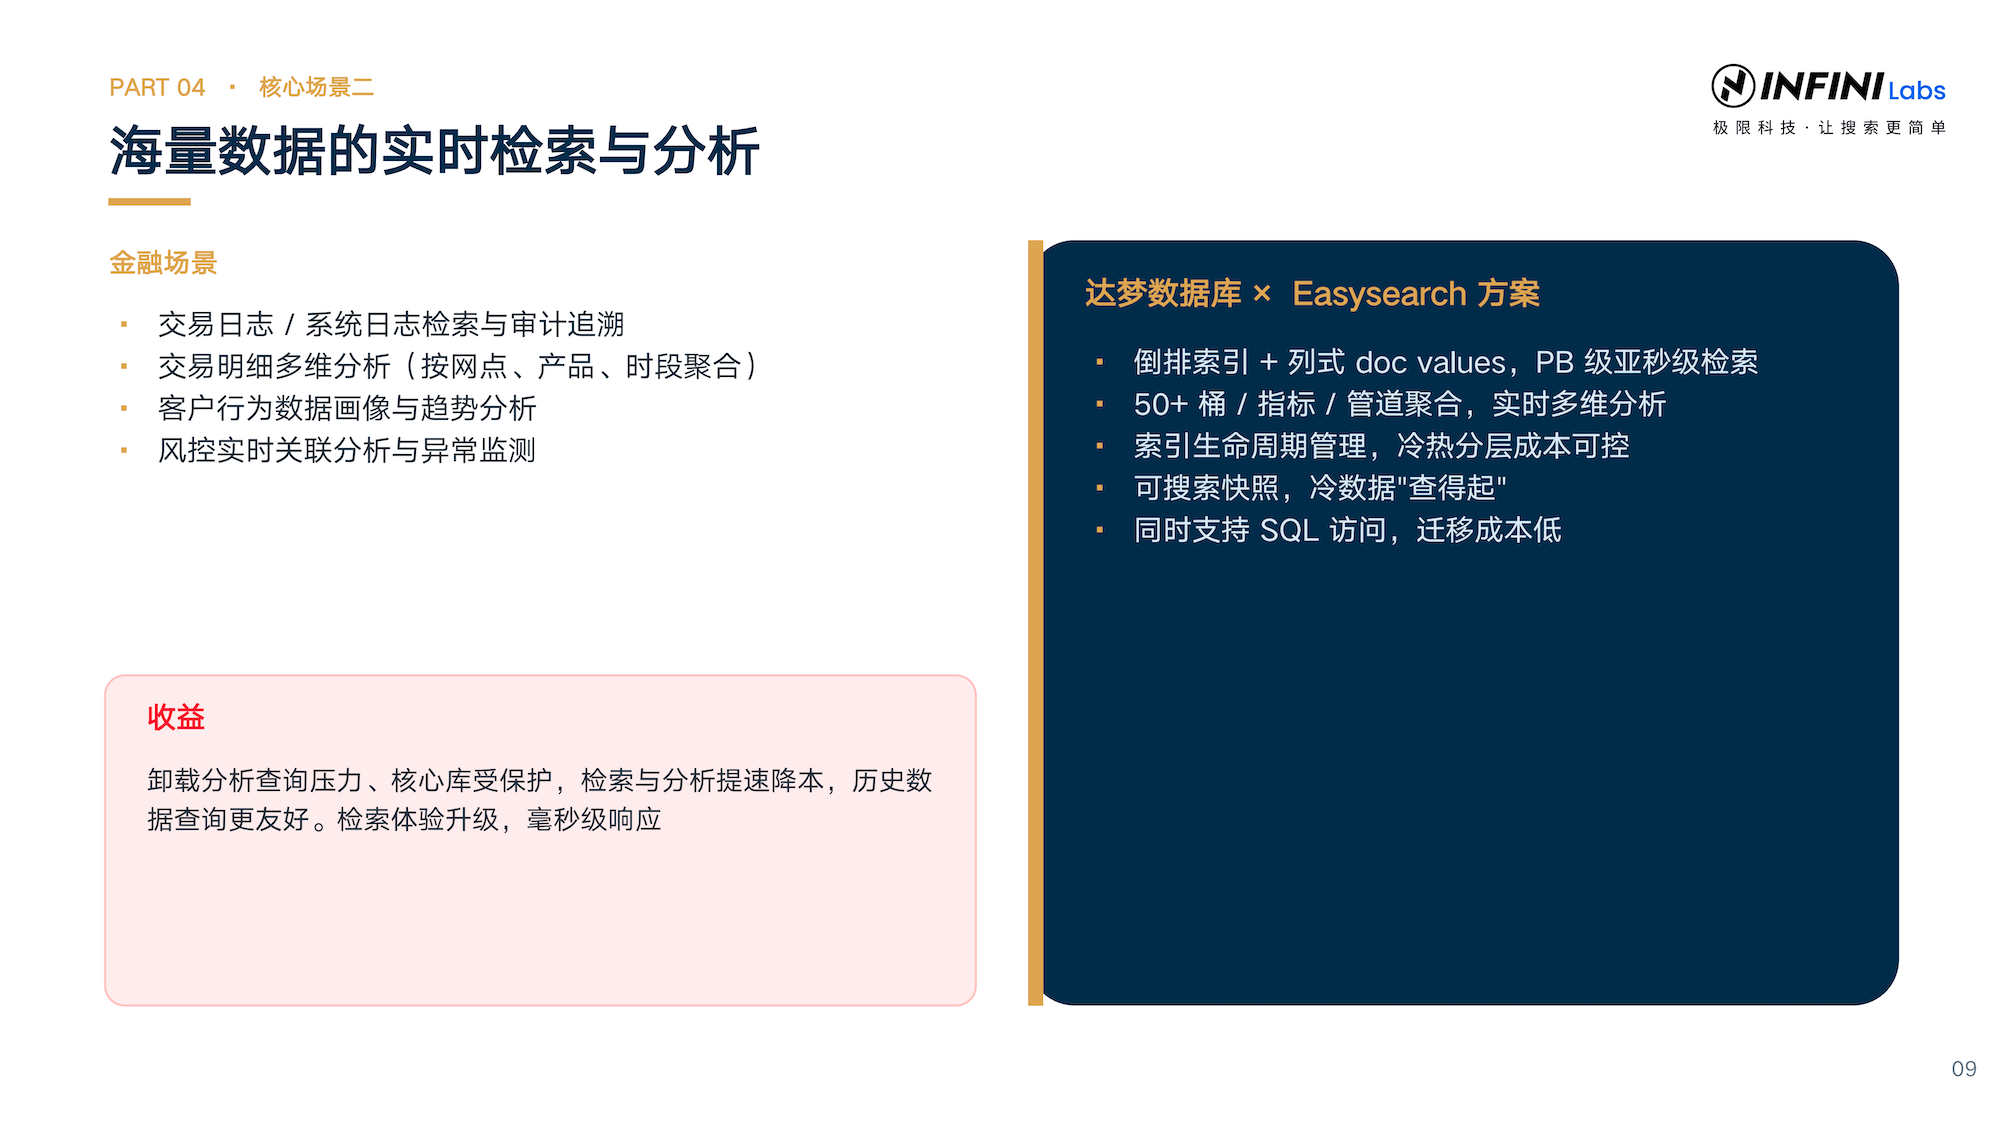
3. 从搜索到分析:Easysearch 还能解决什么?
除了传统的全文检索,本次分享还介绍了 Easysearch 在海量数据分析、向量检索以及 AI 场景中的应用。
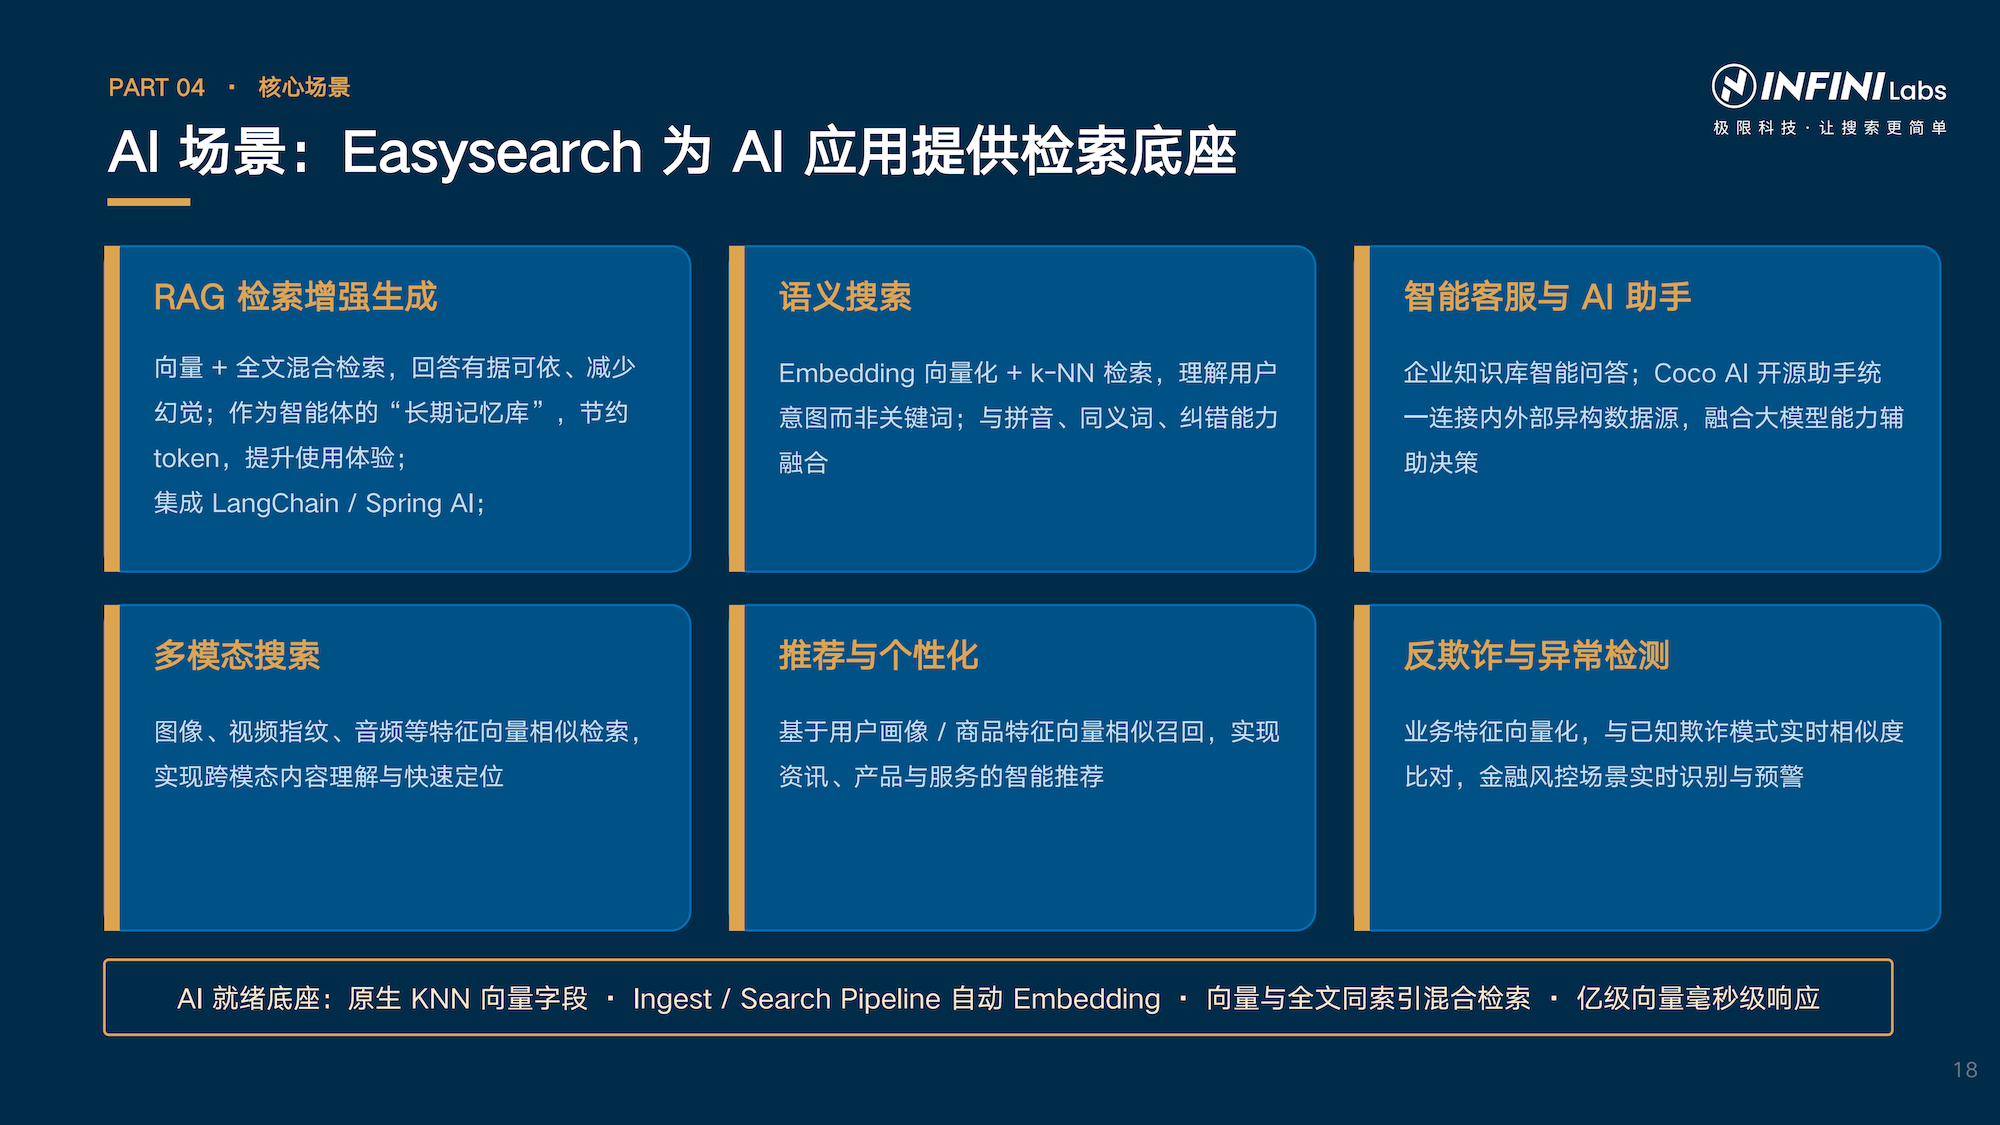
在全文搜索方面,Easysearch 支持 IK、拼音、HanLP 等中文分词能力,并提供 BM25 相关性评分、Function Score、高亮、同义词、搜索建议等能力。
在海量数据分析方面,则可以通过倒排索引、列式 Doc Values 以及聚合能力,承接交易明细分析、日志检索、客户行为分析以及风控等场景。
而在 AI 场景中,Easysearch 还可以进一步提供向量检索和全文检索融合能力,为 RAG、语义搜索、智能客服、推荐以及反欺诈等应用提供检索底座。
这意味着,数据库中的结构化数据经过同步之后,并不只是多了一个“搜索入口”,而是可以进一步形成 搜索、分析与 AI 多种数据服务能力。
4. 在国产数据库信创领域,达梦与 Easysearch 有哪些合作空间?
二者都是信创全栈适配的国产自主产品,合作空间非常广阔:
首先是联合解决方案落地:面向金融、运营商、政企等行业,提供“事务库 + 检索分析库”的信创标准架构,满足等保、密评要求,规避开源组件协议风险;
其次是国产化替代场景:Easysearch 可作为 Elasticsearch 的平滑替代产品,与达梦组合形成“去 IOE + 去开源 Elastic ”的全栈信创方案,目前已在中国移动、中国一汽等标杆项目中验证;
此外还有AI场景拓展:二者结合可支撑金融 RAG 知识库、智能风控、语义合规审查等 AI 应用,为信创环境下的智能化转型提供底座。
四、一次分享,也是一次技术碰撞
从达梦数据库到 Easysearch,从 CDC 到查询卸载,再到全文搜索、海量分析和 AI 检索,本次交流虽然围绕的是一个具体的技术方案,但大家讨论的其实是一个更加普遍的问题:
在信创和数字化转型背景下,如何让不同类型的数据基础设施发挥各自的优势,并最终服务于业务?
达梦与 Easysearch 的组合,并不是简单的“1+1”,而是通过职责分离,让事务处理、数据管理、搜索、分析和 AI 各自发挥所长。
技术分享有终点,技术交流没有终点。
感谢分享嘉宾的精彩内容,也感谢每一位参会伙伴的积极参与和深度交流。
期待下一次,我们继续围绕 搜索、数据库、数据分析、AI 与信创技术,碰撞出更多新的思路与实践。
达梦 × Easysearch,探索国产数据基础设施协同的新可能。
参考资源:
- PPT 下载:https://searchkit.cn/slides/347
- 达梦官网:https://dameng.com
- Easysearch 官网:https://easysearch.cn
INFINI Easysearch 向量搜索实战(二)
向量搜索 • INFINI Labs 小助手 发表了文章 • 0 个评论 • 10190 次浏览 • 2026-08-09 12:39

上回 我们通过 Ingest Pipeline 把数据在写入 Easysearch 的过程中自动转换成了向量,这次我们通过 Search Pipeline 实现查询时将查询内容转换成向量并进行查询。
Embedding 服务
这里要保持与写入时使用的模型一致。
实战
我们实战演示分为以下几个步骤:
- 建立 Search Pipeline
- 设置索引默认 Pipeline
- 数据查询
建立 Search Pipeline
PUT /_search/pipeline/default_model_pipeline
{
  "rewrite_processors": [
    {
      "semantic_query_enricher" : {
        "description": "Sets the default embedding model",
        "url": "https://dashscope.aliyuncs.com/compatible-mode/v1/embeddings",
        "vendor": "openai",
        "api_key": "<api_key>",
        "default_model_id": "text-embedding-v4",
        "vector_field_model_id": {
           "text_vector": "text-embedding-v4"
        }
      }
    }
  ]
}
设置索引默认 Pipeline
为了方便查询,不用每次查询都指定 Pipeline,我们设置默认值。
PUT /my-index/_settings
{
  "index.search.default_pipeline" : "default_model_pipeline"
}
数据查询
使用上次写入的数据进行查询测试,但不直接查询原来的文本内容。
GET /my-index/_search
{
  "_source": "input_text",
  "query": {
    "semantic": {
      "text_vector": {
        "query_text": "非常先进高级的生产车间",
        "candidates": 100,
        "query_strategy": "LSH_COSINE"
      }
    }
  }
}参数解释请查看文档。

OK,从上面可以看到,我们没有直接搜索原文本中的内容或关键字,但还是通过文本的语义检索到了相关内容。
关于 Easysearch
INFINI Easysearch 是一款分布式搜索引擎,支持结构化和非结构化的数据检索、全文检索、向量检索、空间地理位置信息检索、组合查询、多语种支持、语义分析和聚合分析等多种功能。
Easysearch 基于 Lucene 构建,紧跟 Lucene 最新版本持续迭代更新,采用商用友好协议,企业可自由部署、二次开发和商业化,无协议合规风险。
Easysearch 致力于为企业提供轻量、安全、自主可控的搜索平台,不断完善产品能力,满足更多企业级需求。
相关文章:

【 INFINI Workshop 北京站】1月18日一起动手实验玩转 Easysearch
活动 • liaosy 发表了文章 • 0 个评论 • 6777 次浏览 • 2023-12-15 16:22
与 INFINI Labs 的技术专家面对面,第一时间了解极限实验室的发布最新产品和功能特性,通过动手实战,快速掌握最前沿的搜索技术,并用于实际项目中。欢迎大家扫描海报二维码免费报名参加。
活动时间:2024-01-18 13:30~17:30
活动地点:北京市海淀区 Wework 辉煌时代大厦 3 楼 3E 会议室
分享议题
- Easysearch 总体介绍及搭建实战
- 基于 INFINI Console 实现跨版本、跨引擎统一管控
- Elasticsearch -> Easysearch 在线迁移实操
参会提示
- 请务必自备电脑(Windows 系统环境请提前安装好 Linux 虚拟机)
- 请提前在 INFINI Labs 官网下载对应平台最新安装包(INFINI Easysearch、INFINI Gateway、INFINI Console)
- 下载地址:https://www.infinilabs.com/download
- 如有任何疑问可添加 INFINI Labs 小助手(微信号: INFINI-Labs)进行联系

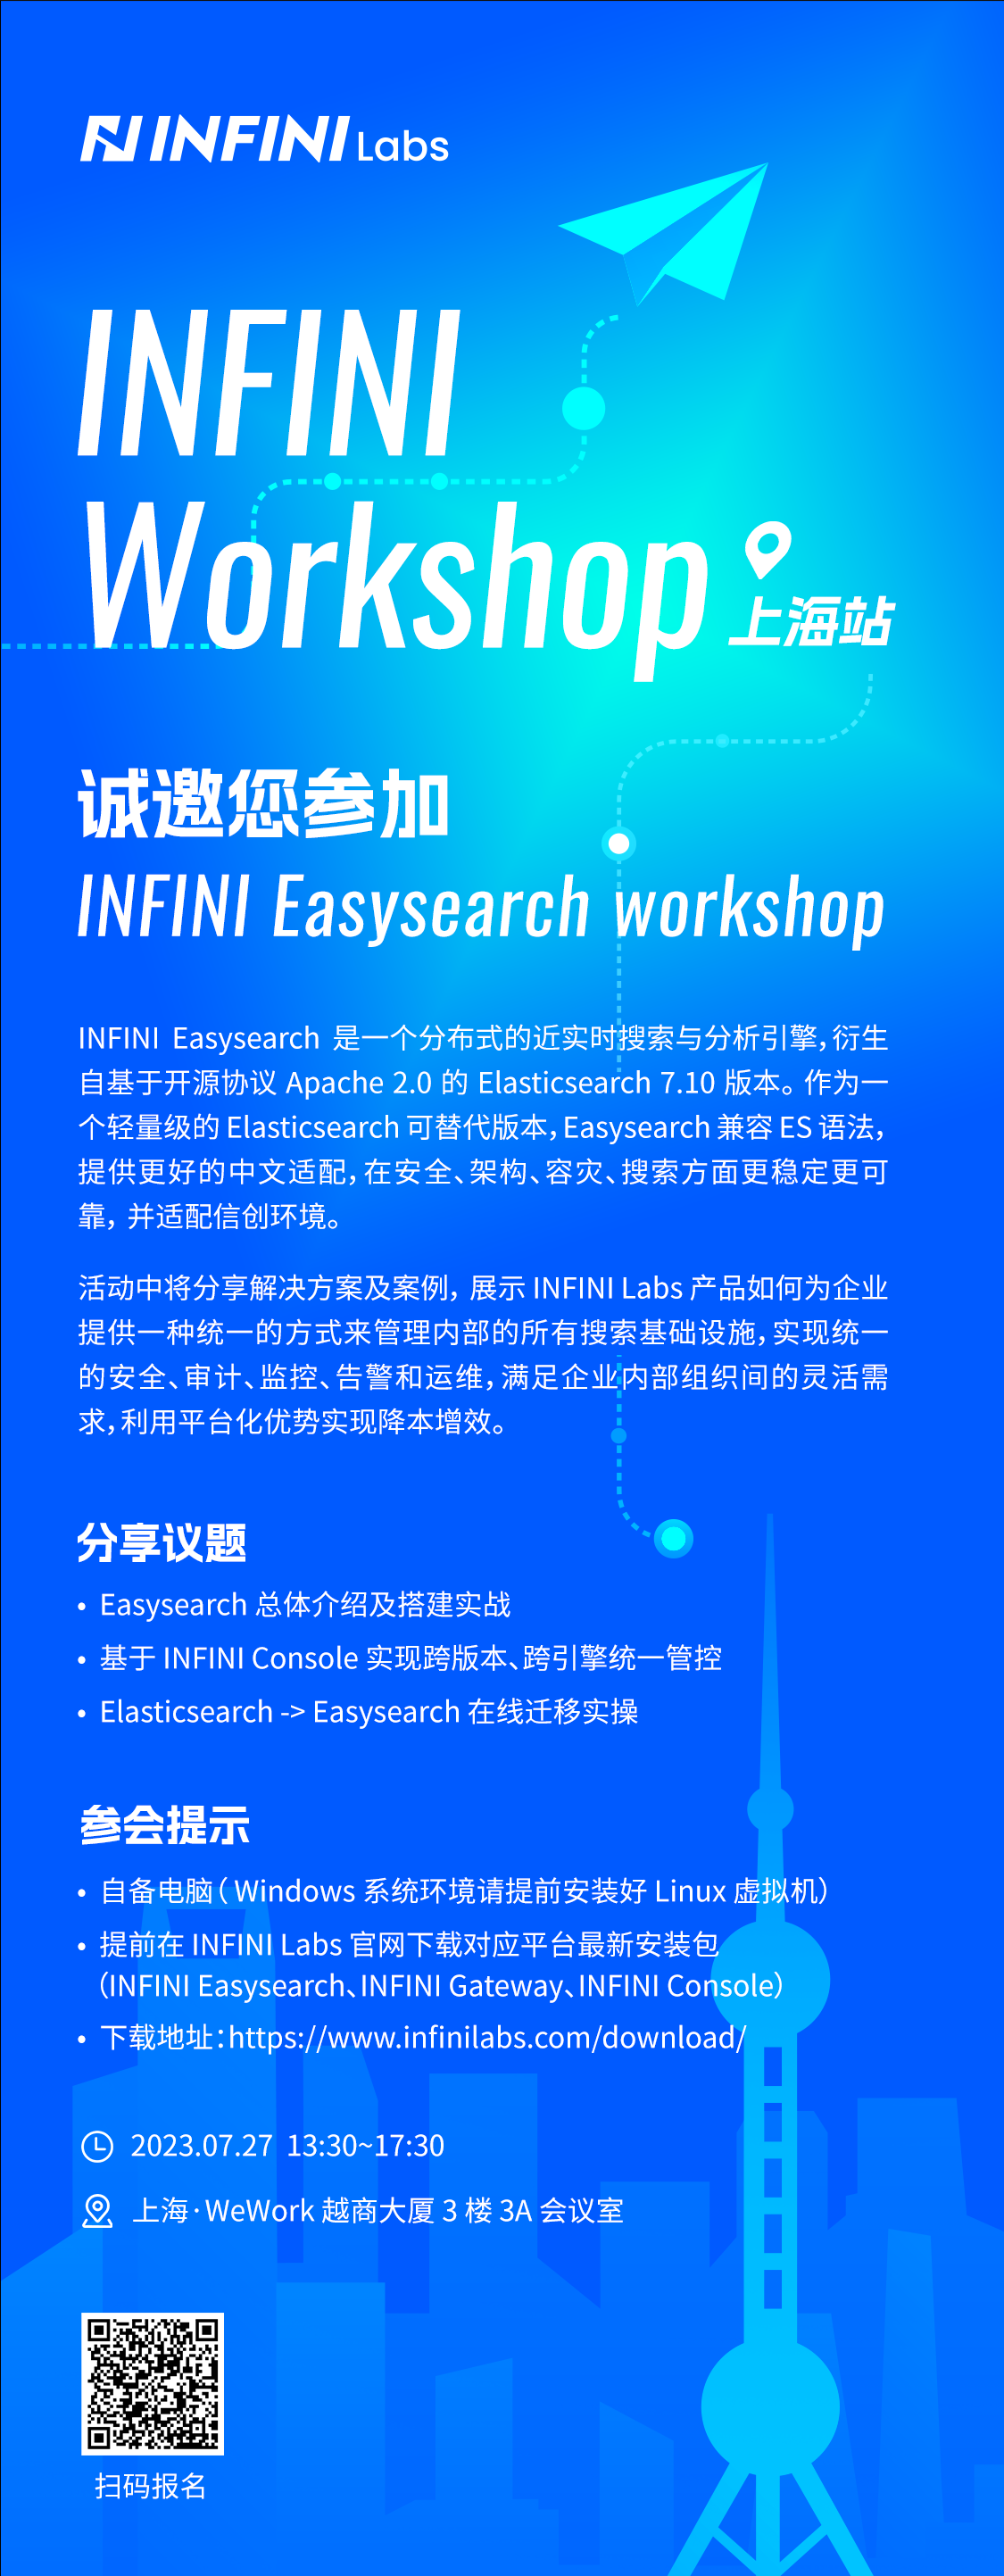
【INFINI Workshop 上海站】7 月 27 日一起动手实验玩转 Easysearch
资讯动态 • liaosy 发表了文章 • 1 个评论 • 5017 次浏览 • 2023-07-07 16:30
Easysearch 布尔查询子句重排序(四)|Block-Max、实战与验证
Easysearch • INFINI Labs 小助手 发表了文章 • 0 个评论 • 5600 次浏览 • 2026-09-29 19:06
Block-Max WAND 块级剪枝、混合查询端到端追踪、Profile API 亲手验证
INFINI Easysearch 是一款专注于企业级场景的分布式近实时搜索与分析引擎。它以 Apache Lucene 为内核进行了增强,在保持与行业主流搜索协议及开发生态完全兼容的同时,重点强化了安全性、稳定性、压缩率及信创兼容性。
引言:从标准 WAND 到块级剪枝
前三篇我们走完了 Easysearch 布尔查询优化的前半程:第一篇讲 rewrite 11 条规则,第二篇讲合取的 cost 排序,第三篇讲析取的 WAND 算法——用 maxScore 上界 + 三堆调度,把"上界够不到及格线的文档"在打分前就剪掉。
但标准 WAND 留了个明显短板:每个子句的上界是全局的——"这个词在全索引最多能打多少分"。游标走到低分文档区,上界仍按全局最高估,剪枝不够激进。本文就围绕这块补全,并把前面所有内容串起来做实战和验证:
- 一 Block-Max WAND——把全局上界换成"按块分段"的上界,整块低分文档一次跳过
- 二 实战——MUST + SHOULD 混合查询的端到端追踪,看前几篇内容怎么协作
- 三 Profile API——用对比实验亲手验证 WAND 生效,避开常见误读
- 四 开发者启示
- 五 全系列总结
一、Block-Max WAND 的增强
1.1 一个类比:为什么全局上界会"过乐观"
想象一场考试,每个学生最多能考 100 分。现在老师想知道"有没有人超过 90 分"。
- 标准 WAND 的做法:每个学生头顶都贴着"100"(全局上限)。老师得把所有人都叫过来核对,因为光看标签谁都"可能"过 90。
- 聪明的做法:把学生按班级分组,每个班只记一个"本班最高分"。如果某班最高才 60,整班直接跳过,不用一个个核对。
Block-Max WAND 就是这个"按班级分组"的做法。倒排链在物理存储上本来就是分块的——Lucene 把每 128 篇文档压缩成一个 block(ForUtil.BLOCK_SIZE = 128),写入时顺手记下"这个 block 内最高能打多少分"。这个分段级上界比全局 maxScore 紧得多——因为它只看本 block 的数据,不会被远处的高分文档带偏。
一句话区分:标准 WAND 的上界是"这个词在全索引最多能打多少分";Block-Max 的上界是"这个词在当前这个 block最多能打多少分"。后者永远 ≤ 前者,所以更容易触发剪枝。
1.2 分段上界 vs 全局上界:一张图看懂
                  标准 WAND                 Block-Max WAND

            ┌──────────────┐        ┌────────────────────────────────┐
   docID    │全局上界=9     │        │块0 doc 0-127   max=9  高分段    │
     ↑      │不管游标到哪    │        ├────────────────────────────────┤
            │上界都是=9     │        │块1 doc 128-255 max=5  中分段    │
            │              │        ├────────────────────────────────┤
            │              │        │块2 doc 256-383 max=2  低分段★   │
            └──────────────┘        └────────────────────────────────┘

   及格线 = 8,游标已进入 Block 2(低分段):

   标准 WAND:上界估 9(全局),9 ≥ 8 → 不剪,逐文档查
Block-Max:上界估 2(本块), 2 < 8 → 跳过整个 block两种策略的对比一目了然——同一个及格线 8、同一个 Block 2:标准 WAND 还用全局 max=9 估计,以为"可能过线"就逐文档查(保守);Block-Max 用本块 max=2 估计,一眼看出整块无望直接跳过(激进),一次比较换掉 128 次 advance。
1.3 源码层面:三个动作怎么串起来
Block-Max 在标准 WAND 之外多调了两个底层方法,理解它们的名字就抓住了主线。这两个方法由每个子句的 Scorer 实现(如 TermWeight 内部的 ImpactsScorer),WANDScorer 通过自己的私有协调方法 WANDScorer.updateMaxScores() 把它们串进三堆调度:
advanceShallow(target)—— "浅推进"。只跳到 target 所在的 block 边界,不逐文档解码。开销远低于真正的advance(target),相当于"瞄一眼那个班的最高分标签"。getMaxScore(upTo)—— 返回"当前 block 内"的最高分上界。这是上面图里max=2那个数的来源,比全局 maxScore 紧得多。updateMaxScores()—— 协调者:游标进入新 block 时,用上述两个方法重算每个子句的分段 maxScore,替换掉之前用的全局值,重新累加上界。发现 tail 上界已经够线,就把高分 essential 子句推进到 head 去实际查。
三者配合后,第三篇 §3.7 那张状态图右侧的 tailMax 数值会逐 block 变小——因为用的是分段上界而不是全局上界,更容易跌破及格线。
1.4 最底层:ImpactsDISI 的块级跳过
分段信息从哪来?写入索引时就备好了。Lucene 的 Impacts 数据结构在 flush 阶段为每个 block 预计算"本块内各 (freq, norm) 组合对应的最高分",查询时由 MaxScoreCache(MaxScoreCache.java:72-78)读出来。
真正执行跳过的是 ImpactsDISI。它内嵌一个 minCompetitiveScore,每次游标要 advance(target) 时先做一道判断(ImpactsDISI.java:68-100):
upTo      = maxScoreCache.advanceShallow(target);   // 找到 target 所在 block 的末尾 docID
maxScore  = maxScoreCache.getMaxScoreForLevelZero(); // 本块分段上界
while (maxScore < minCompetitiveScore) {             // 本块最高分都够不到及格线
    target = maxScoreCache.getSkipUpTo(...) + 1;     // 直接跳到下一个可能有戏的 block
    upTo     = maxScoreCache.advanceShallow(target);
    maxScore = maxScoreCache.getMaxScoreForLevelZero();
}
in.advance(target); // 只在"有戏"的 block 内才真正推进效果:跳过的单位从"单个文档"升级到"整个 block(128 篇)"。一次 advanceShallow 比较,省掉最多 128 次 advance。
名词对照:
advanceShallow/getMaxScore/Impacts/ImpactsDISI/MaxScoreCache是源码里的正式名字;"分段上界""块级跳过""block"是本文用的通俗说法,指的是同一回事。
1.5 剪枝的反馈闭环:从"猜"到"越来越准"
把第一章的几层串起来看,剪枝是一个自适应加速的闭环:
   Collector 收满 K 个结果
        │
        │  setMinCompetitiveScore(kthBestScore)
        ▼
   WANDScorer 收到及格线(抬高)
        │
        │  ① matches():用 lead+tail 的 maxScore 上界跳过低分候选
        │  ② updateMaxScores():用分段上界替换全局上界,上界变紧
        ▼
   ImpactsDISI 收到分段级 minCompetitiveScore
        │
        │  整个 block 最高分都 < 及格线 → 跳过 128 篇
        ▼
   迭代更快 → 更快碰到高分文档 → Collector 收到更高分
        │
        │  setMinCompetitiveScore(...) 再次抬高
        ▼
(循环)及格线越抬越高,剪枝越来越激进这个闭环的关键在于双向反馈:Collector 把及格线往下传给 WANDScorer(决定哪些文档跳过),WANDScorer 再往下传给 ImpactsDISI(决定哪些 block 跳过)。一开始及格线低、剪枝保守(还没见过高分文档,不敢贸然跳);随着高分结果不断收集,线越抬越高,剪枝越来越激进——这就是 §三里 set_min_competitive_score_count 持续增长的来源。
二、实战:MUST + SHOULD 混合查询的端到端追踪
结合前面几篇内容,用一个混合查询走完整路径:
GET /products/_search
{
  "query": {
    "bool": {
      "must": [
        { "term": { "status": "published" } },
        { "term": { "category": "ai" } }
      ],
      "should": [
        { "term": { "author": "sam" } },
        { "term": { "tag": "featured" } }
      ],
      "minimum_should_match": 1
    }
  }
}
2.1 一张图看清 Scorer 嵌套结构
这个查询最终会被组装成一棵 Scorer 树。先看树的样子,再逐层解释:
                      BooleanScorer(顶层,协调 MUST 与 SHOULD 的关系)
                              │
              ┌───────────────┴────────────────┐
              │                                │
     MUST 侧(合取)                      SHOULD 侧(析取,size=10 → TOP_SCORES)
              │                                │
    ConjunctionScorer                     WANDScorer
   (按 cost 排序,最稀疏领头)          (按 maxScore 调度,剪枝省打分)
              │                                │
      ┌───────┴────────┐               ┌───────┴────────┐
      │                │               │                │
  category:ai    status:published   author:sam     tag:featured
  (cost≈1万)     (cost≈100万)        (maxScore 高)   (maxScore 低)
   ↑ lead1       ↑ lead2             └── tail 堆按 maxScore 排
   (最稀疏,领头跳)                  (高分优先推进查实)
这张树图把前面几篇内容串到了一起——每个 Scorer 的选型都有明确理由:
- MUST 侧(合取):两个条件都要满足,用
ConjunctionScorer(第二篇)。按 cost 升序排列,让category:ai(只命中 1 万篇,最稀疏)当 lead1 领头跳,status:published(命中 100 万篇)当 lead2 跟进。lead1 跳得快,整个 MUST 侧就快。 - SHOULD 侧(析取):两个条件满足一个就行,且查询是 Top-10(
size=10),走WANDScorer(第三篇)。两个 SHOULD 子句按 maxScore 进 tail 堆,高分优先推进。 - 顶层 BooleanScorer:把 MUST 的命中文档交给 SHOULD 侧打分。MUST 过滤掉绝大部分文档后,WAND 只需对剩下的少数文档做上界判断,二者职责互补。
2.2 执行追踪:一篇文档怎么走过这棵树
假设 MUST 侧的 lead1(category:ai)跳到 doc=X,整个追踪如下:
① MUST 侧 ConjunctionScorer:
   lead1 (category:ai) advance 到 doc=X
   → lead2 (status:published) 确认 doc=X 也在 → MUST 命中 ✓

② 顶层 BooleanScorer 把 doc=X 交给 SHOULD 侧打分

③ SHOULD 侧 WANDScorer:
   把 author:sam、tag:featured 的游标推进到 doc=X
   → 上界判断(leadMax + tailMax vs 及格线)
   → 通过 → score() 算实际分

④ Collector 收集 doc=X 的分数,必要时抬高 minCompetitiveScore
   → 反馈回 WANDScorer 和 ImpactsDISI(第一章所说的反馈闭环)
2.3 几篇内容怎么协作
回看整个过程,几篇内容各管一段,缺一不可:
- [第一篇] rewrite 保证了查询结构简洁(去重、提升、展平)——这一步决定 Scorer 树的形态。
- [第二篇] cost 排序 让 MUST 侧高效迭代(最稀疏的
category:ai领头)——决定合取侧的跳过效率。 - [第三篇] WAND 调度 让 SHOULD 侧高效剪枝(高分优先 + 动态上界)——决定析取侧的打分开销。
- 本文 Block-Max 让 SHOULD 侧的上界更紧、剪枝更激进——决定析取侧的块级跳过力度。
- 顶层合取 把两者组合:MUST 先把文档数砍到很小,WAND 再在这个小集合里挑 Top-K,各自发挥所长。
三、动手验证:Profile API 观察 WAND 生效
用对比实验验证 WAND 的反馈闭环:track_total_hits: false 切入 TOP_SCORES 模式(WAND 生效),track_total_hits: true 强制 COMPLETE 模式(WAND 剪枝关闭),对比 profile 的 breakdown。
breakdown 字段含义
profile 中每个查询节点的 breakdown 是一个 Map。每个操作有两条记录:不带 _count 后缀的是纳秒耗时,带 _count 后缀的是调用次数。与 WAND/Block-Max 最相关的几个:
| 字段 | 含义 | 与 WAND/Block-Max 的关系 |
|---|---|---|
match / match_count |
TwoPhaseIterator matches() 验证 |
WAND 的上界判断在此发生 |
score / score_count |
score() 实际打分 |
仅对通过 matches() 的命中调用 |
shallow_advance / shallow_advance_count |
advanceShallow() 块级定位 |
Block-Max 独有:块级跳过 |
compute_max_score / compute_max_score_count |
getMaxScore() 计算分段上界 |
Block-Max 独有 |
set_min_competitive_score / set_min_competitive_score_count |
Collector 回传最低分阈值 | WAND 反馈闭环的直接证据 |
构造一个能体现剪枝的数据集
WAND 的文档级剪枝要体现为 score_count 下降,需要"少量高分文档 + 海量低分文档"的分布:高分文档先把 Top-K 的及格线抬到高位,低分文档的上界够不到线,于是被整批跳过。为此建一个专门的索引 wand_msm:
- 100 篇
body = "rare common"—— 同时命中rare(高 idf)和common,分数 ≈ 5.30 - 20000 篇
body = "common extra"—— 命中common+extra,两个都是高频低 idf 词,分数 ≈ 0.01
为什么加
minimum_should_match: 2?这是触发WANDScorer的关键。Lucene 的Boolean2ScorerSupplier.opt()在minShouldMatch > 1时返回WANDScorer;而纯析取(无minimum_should_match或 ≤1)走的是另一条MaxScoreBulkScorer路径(BooleanWeight.java:224)。两者同属 Block-Max 动态剪枝家族,但要直接观察WANDScorer+ Block-Max 的剪枝,用minimum_should_match: 2最干净。
GET /wand_msm/_search
{
  "profile": true,
  "track_total_hits": false,
  "size": 10,
  "query": {
    "bool": {
      "should": [
        { "term": { "body": "rare" }},
        { "term": { "body": "common" }},
        { "term": { "body": "extra" }}
      ],
      "minimum_should_match": 2
    }
  }
}
真实 profile 输出(Easysearch 2.2.0 / Lucene 9.12.2 实测)
############ track_total_hits = false(WAND 生效)############
BooleanQuery (body:rare body:common body:extra)~2  breakdown:
  next_doc_count                       101
  match_count                          100
  score_count                          100        ← 只给 100 篇高分候选打了分
  set_min_competitive_score_count        1        ← 反馈闭环生效!

  body:common (TermQuery)
  advance_count                        100        ← common 链只推进到高分文档区
  shallow_advance_count                  3        ← Block-Max 块级定位
  compute_max_score_count                3        ← Block-Max 分段上界计算
  body:extra (TermQuery)
  advance_count                          1        ← extra 子句几乎整链跳过!

############ track_total_hits = true(WAND 剪枝关闭)############
BooleanQuery breakdown:
  next_doc_count                     20101
  match_count                        20100
  score_count                        20100       ← 给全部 20100 篇命中文档都打了分
  set_min_competitive_score_count        0       ← COMPLETE 模式,从不回传阈值

  body:common  advance_count         20100
  body:extra   advance_count         20001
  (shallow_advance_count / compute_max_score_count 均为 0)
两组的 score_count 相差悬殊——false 模式 100、true 模式 20100,差了 200 倍。WAND 把 20000 篇低分的 common extra 文档在打分前就跳过了,只对真正可能进 Top-10 的 100 篇高分候选调用了 score()。两组返回的 Top-10 完全相同(全是 h0–h9,score=5.2984)——剪枝只省功,不改结果。
怎么读这份输出
把两组数据并排看:
| 字段 | track_total_hits: false(WAND 生效) |
track_total_hits: true(WAND 关闭) |
解读 |
|---|---|---|---|
score_count |
100 | 20100 | 文档级剪枝的直接证据:WAND 跳过 99.5% 的低分文档,只对高分候选打分 |
set_min_competitive_score_count |
1 | 0 | 反馈闭环:只有 false 模式下 Collector 才回传阈值 |
shallow_advance_count(common 子句) |
3 | 0 | Block-Max 铁证:只在 false 模式做块级 advanceShallow |
compute_max_score_count(common 子句) |
3 | 0 | Block-Max 铁证:只在 false 模式算分段上界 |
advance_count(extra 子句) |
1 | 20001 | 低分上界子句被 WAND 几乎整链跳过 |
next_doc_count |
101 | 20101 | false 模式连外层迭代都提前结束了 |
hits.total |
省略 | {"value":20100,"relation":"eq"} |
false 模式不精确计数、允许早退 |
三条证据互相印证:
set_min_competitive_score_count从 0 变 1:Collector 在收集到第 K 个高分结果后,把当前最低分回传给 WANDScorer(Scorer.setMinCompetitiveScore),这是 §一"剪枝反馈闭环"在 profile 里的落地。track_total_hits: true时TopScoreDocCollector的hitsThresholdChecker是 no-op(isThresholdReached()恒为 false),永不回传,所以为 0。score_count从 20100 暴跌到 100:20000 篇common extra文档的上界(≈0.01)够不到及格线(≈5.30),在score()之前就被跳过——这正是 WAND"用廉价的上界比较换掉昂贵的打分"的直接体现。shallow_advance_count/compute_max_score_count只在 false 模式非零:这正是 §一所讲 Block-Max 的advanceShallow()/getMaxScore()在底层被调用的痕迹。注意它们挂在 TermQuery 叶子节点上、而不是 BooleanQuery 顶层节点——后者这两个字段恒为 0。
⚠️ 另需注意:
score_count反映的是进入collect()的打分次数,只有在"高分文档先出现、低分文档上界够不到及格线"的分布下才会明显下降——若所有命中文档分数接近(例如每篇内容雷同),及格线抬不上去,score_count就不会降。
对比实验:观察耗时差异
将 track_total_hits 改为 true,同样查询再次执行,对比 score 耗时(纳秒,单次运行波动较大,下为多次中位数):
track_total_hits=false:   score ≈   37,000 ns   score_count =   100
track_total_hits=true:    score ≈ 2,640,000 ns   score_count = 20100     (约 70 倍)
本例剪枝比例高达 99.5%,false 模式的 score 耗时约只有 true 模式的 1/70——因为它只对 1% 的文档真正打分。数据集越大、剪枝比例越高,WAND 的收益越显著。(profile 本身有额外开销、绝对数字仅供参考,关键看两种模式的相对差距。)
小结
判断 Block-Max WAND 是否生效,看 set_min_competitive_score_count 是否从 0 变非零(机制是否触发);评估收益大小,看 score_count 的下降幅度与 score 耗时的相对差距。
四、开发者启示:写查询时该注意什么?
既然子句顺序在 Easysearch 2.x 上无需操心,那开发者应该关注什么?
✅ 用 filter 代替 must 当不需要评分时
filter 不参与评分,走 ConstantScoreQuery 路径更高效。同时,filter 子句不会增加 WANDScorer 的调度开销——它们被提升到 MUST 后走合取路径,与评分子句的 WAND 调度互不干扰。
✅ 让 Lucene 做 minShouldMatch 优化
当 should 数量恰好等于 minimumShouldMatch 时,所有 SHOULD 子句自动提升为 MUST(第一篇规则 10),走 ConjunctionScorer 而非 WANDScorer。这意味着:你不需要手动把 should 改成 must 来"帮助"优化器——只要语义上等价,Lucene 会自动做正确的选择。
✅ 避免嵌套过深的布尔查询
展平 SHOULD 嵌套能让 WAND 看到更多子句(第一篇规则 9)。嵌套结构下,内层 BooleanQuery 的子句对外层 WANDScorer 不可见,maxScore 上界估计不够紧,剪枝效果打折。手动展平或让 rewrite 自动展平,都能提升 WAND 效率。
✅ 理解 cost 的含义
cost ≈ 匹配文档数的估算,不是执行时间。一个高 cost 的 TermQuery 可能有极佳的缓存局部性(因为倒排列表是连续存储的),而一个低 cost 的 PointRangeQuery 可能需要更昂贵的验证逻辑。Profile API 的 advance 次数分布才是实际性能的真实反映。
❌ 不必刻意调整子句顺序(Easysearch 2.x)
底层会自动按 cost(合取)或 maxScore(析取)排序。无论是先写高频词还是低频词,执行时的迭代顺序完全相同。唯一例外见第二篇 §八的边界说明:Easysearch 1.x(Lucene 8.11)上 must/filter 混有多词查询时,仍应把稀疏 term 写在前面;Easysearch 2.x(Lucene 9.12)已随 Lucene 9.5 的修复免疫此问题。
🔧 Easysearch 的额外能力
在 Lucene 标准优化栈之外,EasySearch 还提供一个面向特定场景的增强能力:
fast_terms 插件:在高基数字段(如 user_id、tag_id 数万量级)上,用 RoaringBitmap 位图集合替代 N 个独立 TermQuery,将 N 次倒排索引查找压缩为 1 次 bitmap 交集。查询 DSL 名为 fast_terms,但其在 Profile 中对应的 type 是底层 Query 类的简单名 FilterQuery(type 取自 query.getClass().getSimpleName(),而插件实现类是 org.infinilabs.query.FilterQuery)。底层 FilterQuery 走 ConstantScoreWeight + 位图迭代器,advance 调用次数从 O(N·命中数) 降到 O(命中数)。
它走自己的 Scorer 体系、不参与 BooleanQuery 的 rewrite / cost 排序 / WAND 剪枝路径,可按需叠加。
五、全系列总结
四篇文章,从构建层到执行层,从合取到析取,我们完整走过了 EasySearch 布尔查询的优化全景:
- 构建层(第一篇):11 条 rewrite 规则
Easysearch + Lucene 的构建层不做代价排序,但通过 11 条代数规则自动简化查询结构。其中对执行性能影响最大的两条——规则 7(SHOULD+FILTER→MUST 提升)和规则 9(SHOULD 嵌套展平)——改变了子句的执行路径,为后续优化铺路。Profile API 可以直接观察 rewrite 后的查询形态(+ 前缀 = MUST 提升成功)。
- 执行层·合取(第二篇):cost 排序 + leadCost 传播
ConjunctionDISI 按 cost 排序,让最稀疏的迭代器领头——它是跳过无效文档速度最快的那个。两阶段验证按 matchCost 排序,leadCost 实现从外向内的策略传播(如 IndexOrDocValuesQuery 的自适应切换)。Profile 的 advance 次数分布是最直接的佐证:lead1 的 advance 次数远大于 followers。
- 执行层·析取 I(第三篇):WAND 动态调度
WANDScorer 按 maxScore 动态调度子句,高分优先推进——这是 Top-K 查询能早退的根本保障。三堆(head/lead/tail)分工合作,用大量廉价的上界比较换掉少量昂贵的精确打分。
- 执行层·析取 II(本文):Block-Max 块级剪枝
Block-Max WAND 在块级别进一步剪枝:用分段级 maxScore 替换全局 maxScore,整块低分文档一次跳过。shallow_advance 字段可验证其效果。剪枝的反馈闭环——Collector → WANDScorer → ImpactsDISI——实现自适应加速:越到后面,剪枝越激进。
给开发者的核心建议
- 无需关心子句书写顺序——底层自动优化。Easysearch 2.x(Lucene 9.12)确实如此;1.x 基于 Lucene 8.11,must/filter 混有 prefix/wildcard 等多词查询时,仍建议把稀疏的 term 子句写在前面(见第二篇 §八的边界说明)
- 关注查询结构设计——用 filter 替代不需要评分的 must,展平嵌套 SHOULD
- 善用 Profile API——
set_min_competitive_score_count(反馈闭环是否生效)、advance/shallow_advance次数(跳过力度)、score耗时(打分成本)是核心观测指标;注意不带_count后缀的是纳秒耗时,带_count的才是次数 - 理解 WAND 的触发条件——
track_total_hits: false切入TOP_SCORES开启剪枝(纯析取走MaxScoreBulkScorer,minimum_should_match > 1才走WANDScorer),track_total_hits: true走COMPLETE关闭剪枝;对比set_min_competitive_score_count是否从 0 变非零是判断剪枝是否生效最直接的方式,score_count的下降幅度则量化了实际收益
作者:冯田立,极限科技(INFINI Labs)Easysearch 搜索引擎研发专家,曾在亚马逊 AWS 有多年的 Elasticsearch 开源插件和 OpenSearch 的开发经验和客户集群的运维经验,并有幸参与 OpenSearch 的创立。
Easysearch 布尔查询子句重排序(三)|WAND 动态剪枝
Easysearch • INFINI Labs 小助手 发表了文章 • 0 个评论 • 5594 次浏览 • 2026-09-29 19:05
Lucene 如何用 WAND 算法实现 Top-K 的动态剪枝
INFINI Easysearch 是一款专注于企业级场景的分布式近实时搜索与分析引擎。它以 Apache Lucene 为内核进行了增强,在保持与行业主流搜索协议及开发生态完全兼容的同时,重点强化了安全性、稳定性、压缩率及信创兼容性。
一、回顾与引入
在第二篇中,我们深入解析了合取查询的核心优化:ConjunctionDISI 按 cost 排序,让最稀疏的迭代器领跑。这套机制的前提是 AND 语义——所有子句都必须匹配,所以"谁最少"就决定了跳转的速度。
本文聚焦析取(SHOULD)场景。关键转变在于:不需要全部匹配,而是找 Top-K 高分文档。 优化目标从"最少匹配"变为"最高分数贡献"——cost 最低的子句不一定分数最高,而分数最高的子句才最可能帮你快速找到 Top-K。
这就是 WAND 算法的用武之地。
二、为什么析取不能简单按 cost 排序?
合取和析取的本质差异决定了它们的优化策略必须不同:
| 维度 | 合取(MUST) | 析取(SHOULD) |
|---|---|---|
| 语义 | 所有子句都匹配 | 至少部分子句匹配 |
| 优化目标 | 快速排除不匹配文档 | 快速找到 Top-K 高分文档 |
| 排序依据 | cost(谁最少谁领头) | maxScore(谁分最高谁优先推进) |
| 关键操作 | 跳过不匹配的文档 | 跳过不可能进 Top-K 的文档 |
为什么 cost 排序在析取中不适用?看一个析取查询 should: [quantum, the, machine_learning],找 Top-10:
| 子句 | 匹配文档数(cost) | 单次命中得分 |
|---|---|---|
quantum |
100 | 8.0 |
the |
1000 万 | 0.1 |
machine_learning |
5 万 | 15.0 |
设想文档 D:不含 "quantum",但同时命中 "the" 和 "machine_learning",总分 = 0.1 + 15.0 = 15.1,远超只命中 "quantum" 的文档(8.0),理应排进 Top-10。
若按 cost 让 quantum 领头驱动,候选集就由 quantum 的倒排表决定——D 不在其中,根本不会被推进打分,Top-K 就漏掉了 15.1 分。根源在于:cost 衡量的是"匹配多少",分数衡量的是"匹配多高",两者是不同的维度。
析取需要的是感知分数的调度策略:优先推进高分子句,快速积累 Top-K,再用已有最低分剪枝。这就是 WAND(Weak AND)算法的核心思想。
WANDScorer 的触发条件
WANDScorer 不是总生效。Lucene 在 Boolean2ScorerSupplier.opt() 中按以下条件决定是否为 SHOULD 子句构造 WANDScorer(否则走 DisjunctionSumScorer):
if ((scoreMode == ScoreMode.TOP_SCORES && topLevelScoringClause) || minShouldMatch > 1) {
    return new WANDScorer(weight, optionalScorers, minShouldMatch, scoreMode);
} else {
    return new DisjunctionSumScorer(weight, optionalScorers, scoreMode);
}
即满足其一即可:
ScoreMode.TOP_SCORES且该析取是顶层评分子句:正常的_search请求默认track_total_hits=10000,对应TOP_SCORES(由TopScoreDocCollector设置)minShouldMatch > 1:此时即便非 TOP_SCORES 也用 WANDScorer 做合取推进
注意第 1 个条件里的 TOP_SCORES 是 Lucene 的内部评分模式,由请求参数 track_total_hits 间接决定用哪个 Collector,Collector 再把自己的 ScoreMode 报给 Scorer:
track_total_hits: false(默认10000亦同)→TOP_SCORES:收集满 Top-K 后允许提前结束,并把当前最低分回传给 WANDScorer,剪枝开启track_total_hits: true→COMPLETE:必须遍历全部匹配文档以给出精确总数,从不回传阈值,剪枝关闭
所以同一条 SHOULD 查询(默认 minShouldMatch=1),只改 track_total_hits 就能让 WANDScorer 在"真正剪枝"与"改走 DisjunctionSumScorer 不剪枝"之间切换——这正是下一篇 §三对比实验的切入点。
三、WAND 的核心逻辑:用上界剪枝
3.1 WAND 要解决什么:Top-K 与一条不断抬高的及格线
析取查询的本质:SHOULD 子句"至少匹配一个",但用户要的不是全部匹配文档,而是分数最高的 K 个(Top-K)。
既然只要 Top-K,就有一条隐形的及格线——当前已收集结果中第 K 名的分数,记作 minCompetitiveScore(最小竞争分)。超过它才可能挤进 Top-K,超不过一定落选。随着高分文档不断被收进来,这条线只会越抬越高。
于是每个候选文档只须回答一个问题:分数能不能超过及格线? 能才值得精确打分,不能就该跳过,不进行精确打分。WAND 的全部巧思都围绕上述这点,而办法就是下节介绍的"分数上界"。
3.2 从查询语句到游标:每个 SHOULD 子句是一条独立的倒排链
先看一条布尔查询长什么样:
{
  "bool": {
    "should": [
      { "term": { "body": "rare" } },
      { "term": { "body": "common" } },
      { "term": { "tag": "hot" } }
    ]
  }
}里的每个 SHOULD 子句,底层都是一次独立的倒排索引查找,对应一条倒排链(posting list)——按 docID 升序排列的、所有命中该词的文档号序列。每条倒排链配一个游标 docID,指向"这条链上下一个待处理的匹配文档"。
3 个 SHOULD 子句 = 3 条倒排链 = 3 个游标。WANDScorer 就是同时管着这几个游标、协调它们推进的调度器。
下面给这三条倒排链画个框图(沿用下一篇 §三对比实验里 body:rare / body:common / tag:hot 的语义:一个稀有词、一个常见词、一个中等标签),方便后续讲游标怎么移动。竖线是已经按 docID 升序排好的匹配文档号,▼ 就是游标当前指向的那个文档:
        SHOULD 子句         倒排链(命中的 docID,升序排列)        游标 ▼

   ┌──────────────┐
   │  rare (稀有) │  ··· 42 ──── 87 ──── 156 ──── 203 ──── 318 ──── ···
   └──────────────┘        ▲
                           │  当前指向 doc=42

   ┌──────────────┐
   │ common (常见)│  ··· 5 ── 42 ── 87 ── 88 ── 156 ── 203 ── 318 ── 410 ── ···  (很长,省略)
   └──────────────┘       ▲
                          │  当前指向 doc=5

   ┌──────────────┐
   │  hot (标签)  │  ··· 17 ──── 87 ──── 203 ──── 318 ──── ···
   └──────────────┘        ▲
                           │  当前指向 doc=17

   ───────────────────────────────────────────────────────────────────→ docID 轴
5 17 42 87 88 156 203 318 410看这张图,三条游标彼此独立、各自往前走。WANDScorer 的全部工作,就是在它们之间做调度:选一个"候选文档号"(比如最小的 5),把三条游标推进到那个号去查命中,命中就打分、不命中就跳过。三堆(§3.4)就是为这个调度做的分工。
关键认知:一个文档的最终得分 = 它实际命中的那些子句的实际得分之和。子句"命中没命中",看那条倒排链里有没有这个文档号——这正是游标要查的事。
3.3 核心招式:用分数上界代替实际分数
最直白的判断法:把命中的子句逐个 score() 加起来跟及格线比。但 score() 很贵(要算 BM25 的 tf/idf),WAND 不想这么干。
WAND 的招式:别算实际分数,估一个上界就够了。 每个子句在构建时就算好 maxScore——"命中任何文档最多贡献多少分"(由 idf 和该词可能的最高 tf 决定,计算成本低)。于是:
文档分数上界 = 所有"可能命中"的子句的 maxScore 之和
这个上界必然 ≥ 实际分数:maxScore ≥ 实际得分(往大了估),"可能命中" ⊇ 真正命中(多算不漏算)。
判断就简单了:上界 < 及格线 → 直接跳过,一次 score() 都不调用。 只有上界 ≥ 及格线的文档才值得精确打分。WAND 的全部收益就来自这里——用大量廉价的上界比较换掉少量昂贵的精确打分("Weak"也在这里:不强求每个子句都查实,上界够用就敢下结论)。
那么"可能命中"怎么界定?答案在游标位置里。
3.4 游标的三种位置 → 三堆
§3.3 留了一个问题:哪些子句算"可能命中"?答案全在游标上。
WANDScorer 手里攥着好几条倒排链的游标,各自独立推进。每一轮它选定一个候选文档号(从哪来的 §3.5 会说,眼下先当成参照点),然后看每条链的游标相对这个文档号,只可能有三种位置:
- 游标 == 候选号:确认命中 → 上界按
maxScore计 - 游标 > 候选号:游标走过头了,确认不命中 → 贡献 0
- 游标 < 候选号:还没走到,未知 → 上界按
maxScore计(往乐观了估)
WANDScorer 把这三类子句分别放进三个结构,叫三堆:确认命中的进 lead,确认不命中的进 head,未知的进 tail。
         ┌────────────────────────────────────────────────────────────────┐
         │                      WANDScorer 内部结构                        │
         │                                                                │
         │   tail (maxScore 最大堆) lead        head (按 docID 升序)        │
         │   ┌──────────────┐       ┌─────┐     ┌──────────────┐          │
         │   │ S4 maxScore=9│       │ S1  │     │ S3 doc=156   │          │
         │   │ S2 maxScore=5│       │ S5  │     │ S6 doc=203   │          │
         │   │ S7 maxScore=2│       │     │     │              │          │
         │   └──────────────┘       └─────┘     └──────────────┘          │
         │                                                                │
         │   游标还没到当前文档     游标已停在      游标已越过当前文档           │
         │   按 maxScore 排,       当前文档      按 docID 排,              │
         │   按需推进                            决定下个候选                │
         └────────────────────────────────────────────────────────────────┘
三个结构各有分工:
- tail 按
maxScore排最大堆,堆顶是分数最高的子句。上界不够时优先借它——最可能一把把上限抬过线。 - lead 是简单链表,串起确认命中的子句。精筛过关后逐个
score()算实际分。 - head 按
docID排最小堆,堆顶是文档号最小的——它就是下一个候选文档。
子句在三堆间流转:tail → lead → head。未知的推进去查,命中进 lead,不命中进 head。下一轮候选变了,部分子句又可能从 head 回到 tail。
3.5 搜索流程:粗筛、精筛与阈值回传
把三堆放回完整流程。WANDScorer 对外是个 Scorer,被 Collector 驱动,主循环四步:
Collector 主循环:
  while ((doc = scorer.nextDoc()) != NO_MORE_DOCS) {   // ① 粗筛
    if (twoPhase.matches()) {                          // ② 精筛
      float s = scorer.score();                        // ③ 精确打分
      collector.collect(doc, s);                       // ④ 收入结果 + 抬及格线
    }
}- ① 粗筛:候选从 head 堆顶来(docID 最小者)。
nextDoc()调用doNextCompetitiveCandidate(WANDScorer.java:492-504)做一道文档级跳过:若leadMaxScore + tailMaxScore < 及格线,说明当前 doc 凑不够分,直接推进到下一个候选文档(可能跨 block)。这里只用每子句一个的 maxScore 求和判断,不逐子句查实命中、不算精确分。 - ② 精筛:留在候选 doc 上,逐个借 tail 堆顶推进查实命中,看实际能否过线。这是 WAND 的核心动作,§3.6 专门展开。
- ③ 精确打分:通过精筛的,把 lead 里确认命中的子句逐个
score()加总。 - ④ 阈值回传:收满 K 个后,Collector 把第 K 名分数回传给 WANDScorer 抬高及格线——下一篇 §一展开。
3.6 核心剪枝:上界估计与"借 tail"
对当前候选文档,WAND 只回答一个问题:它的分数上界够不够得着及格线?
上界 = lead 各子句 maxScore 之和(确认命中,贡献确定)+ tail 各子句 maxScore 之和(未知,按 maxScore 乐观估算)。这个上界必然 ≥ 实际分数。判断逻辑(WANDScorer.java:309-332):
while (leadMaxScore < minCompetitiveScore) {        // lead 自己不够线
    if (leadMaxScore + tailMaxScore < minCompetitiveScore)
        return false;        // 加上 tail 的乐观估计仍不够 → 必败,跳过
    advanceTail();            // 还有希望:从 tail 堆顶借一个子句去"查实"
}
return true;                  // lead 已够线 → 留下精确打分
关键在 advanceTail()——把 tail 堆顶(maxScore 最高的未知子句)推进到当前文档查实,结果只有两种:
- 命中 → 进 lead,
leadMaxScore实打实涨上去; - 不命中 → 进 head,从 tail 挪走,
tailMaxScore掉下来。
每借一次,要么抬高下限(leadMaxScore),要么压低上限(tailMaxScore)。文档能不能活下来,取决于借出的子句里有多少真的命中;借遍 tail 仍够不到线就判负,全程没调用过 score()。
为什么永远先借堆顶? tail 按 maxScore 排最大堆,堆顶最可能一下把 leadMaxScore 抬过线;如果连 leadMaxScore + tailMaxScore 都够不到线,低分子句就无需查实,候选文档可以直接跳过。这就是 WAND 的 "Weak":不强求每个子句都查实,只查可能扭转局面的那几个。
3.7 数字示例:一次完整的剪枝流程
先给出示例的场景。3 个 SHOULD 子句,各自的 maxScore 和倒排链(命中的 docID,已升序排列)如下,及格线 minCompetitiveScore = 10:
| 子句 | maxScore | 倒排链(命中的 docID) |
|---|---|---|
| S1 | 8 | 42, 55 |
| S2 | 5 | 20, 55 |
| S3 | 3 | 30, 60 |
每个子句配一个游标,指向"这条链下一个待处理的 docID"。假设已经收集满 Top-K、及格线抬到了 10,本轮候选文档 = 42(S1 的游标停在 42,刚从 head 堆顶取出作为领头);S2、S3 因 maxScore 较低此前没被推进,游标还分别停在 20、30。把三个子句按"游标 vs 候选 42"的位置归堆:
- S1 游标 42 == 42:确认命中 doc=42 → lead
- S2 游标 20 < 42:还没走到,未知 → tail
- S3 游标 30 < 42:还没走到,未知 → tail
- 没有游标 > 42 的子句 → head 此刻是空的(S1 已进 lead,S2、S3 还在 tail)
于是初始状态:lead 装着 S1(确认能拿 8 分),tail 装着 S2、S3(最多还能补 5+3=8 分),head 空。
下面这张状态图把 doc=42 接下来怎么被剪掉完整画了出来。关键看右侧三个数:leadMax = lead 里已确认能拿的分数,tailMax = tail 里最多还能补多少(乐观估计),二者之和就是分数上界。每借一次 tail 堆顶,三堆成员就流动一次,这三个数也跟着变:
        候选 doc=42,  及格线 = 10                          分数上界 = leadMax + tailMax

              head          lead         tail            leadMax  tailMax  上界     动作
        ┌────────────┐  ┌─────────┐  ┌──────────┐
  初始   │   (空)     │  │  S1: 8  │  │  S2: 5   │          8        8     16   ≥10
        │            │  │         │  │  S3: 3   │                              ─→ 借堆顶 S2
        ├────────────┤  ├─────────┤  ├──────────┤
  借 S2 │  S2→55     │  │  S1: 8  │  │  S3: 3   │           8        3     11   ≥10
        │            │  │         │  │          │                              ─→ 借堆顶 S3
        ├────────────┤  ├─────────┤  ├──────────┤
  借 S3 │  S2→55     │  │  S1: 8  │  │  (空)    │           8        0      8   <10
        │  S3→60     │  │         │  │          │                              ─→ ✂️ 必败
        └────────────┘  └─────────┘  └──────────┘

        表头解读:head/lead/tail 三栏列出各自的子句成员(含 maxScore);
                  右侧三个数描述【整堆】在这一轮的整体状态,不与某一格对应。
每一行发生了什么(看左栏 → 右栏):
- 初始:lead 只有 S1 →
leadMax=8不够线(8 < 10),但加 tail 的乐观估计tailMax=8后上界 16 ≥ 10,还有希望 → 借 tail 堆顶 S2 查实。 - 借 S2:把 S2 游标从 20 推进到 ≥42,结果落在 55(> 42,没命中)→ S2 进 head,tailMax 从 8 掉到 3。
leadMax还是 8(没涨,因为 S2 没命中),上界 11 ≥ 10 仍有希望 → 再借 S3。 - 借 S3:把 S3 游标从 30 推进到 ≥42,落在 60(也没命中)→ S3 进 head,tailMax 从 3 掉到 0。上界 8 < 10 → 必败,剪掉 ✂️
读懂这张图就懂了 WAND:借出的子句都没真命中 42,所以 leadMax 三轮卡在 8 不动;而每借走一个,tailMax 就往下掉一截(8→3→0)。上界随之从 16 一路缩到 8,最后跌穿及格线——doc=42 全程没调一次 score() 就被剪掉。
再看下一个候选 doc=55——lead 自身就够线,根本不用借。doc=42 被剪掉后,S1 推进到它的下一个文档 55;S2、S3 在前面借出时已推进到 55、60。按游标位置归堆:S1、S2 游标 == 55 → lead;S3 游标 60 > 55 → head(贡献 0)。状态图只有一行:
        候选 doc=55,  及格线 = 10

              head          lead         tail            leadMax  tailMax  上界     动作
        ┌────────────┐  ┌─────────┐  ┌──────────┐
  初始   │  S3→60     │  │  S1: 8  │  │  (空)    │         13        0     13   ≥10   ─→ score()
        │            │  │  S2: 5  │  │          │                              实际 7+4=11 ✅
        └────────────┘  └─────────┘  └──────────┘
leadMax=13 一上来就够线,直接调 score() 算实际分 7+4=11 > 10 → ✅ 收入 Top-K。两图对比,分水岭就在第一行:doc=42 的 lead 只值 8,被迫借 tail 撞运气;doc=55 的 lead 自值 13,一步过关。同一个及格线下,命运全由"借出来的子句有没有真命中"决定——这正是 §3.6 那句"借堆顶"的实战含义。
3.8 cost 作为平局打破者(tiebreaker)
当两个子句 maxScore 相同时,推进 cost 更低(更稀疏)的子句更高效——它每次 advance 跳过的文档更多。
代码解读:tail 堆的比较器 greaterMaxScore()(WANDScorer.java:643-651)以 scaledMaxScore 为主键排序,maxScore 相同时用 cost 做次键:
private static boolean greaterMaxScore(DisiWrapper w1, DisiWrapper w2) {
  if (w1.scaledMaxScore > w2.scaledMaxScore) return true;
  else if (w1.scaledMaxScore < w2.scaledMaxScore) return false;
  else return w1.cost < w2.cost;   // 分数并列时,cost 更低(更稀疏)的排前面
}
小结
本文把 WAND 讲透了:一条不断抬高的及格线 + 用 maxScore 估上界 + 三堆分工调度游标 + 完整数字例子。核心就一句——用大量廉价的上界比较,换掉少量昂贵的精确打分。
但标准 WAND 还有一个明显短板:每个子句的上界是全局的,游标走到低分区域仍按全局最高分估,剪枝不够激进。Block-Max WAND 怎么补上这块、混合查询怎么端到端跑起来、Profile API 怎么亲手验证剪枝生效——都在下一篇(四)。
作者:冯田立,极限科技(INFINI Labs)Easysearch 搜索引擎研发专家,曾在亚马逊 AWS 有多年的 Elasticsearch 开源插件和 OpenSearch 的开发经验和客户集群的运维经验,并有幸参与 OpenSearch 的创立。
Easysearch 布尔查询子句重排序(二)|ConjunctionDISI 按 cost 排序源码解析
Easysearch • INFINI Labs 小助手 发表了文章 • 0 个评论 • 5605 次浏览 • 2026-09-29 19:01
Lucene 如何让最稀疏的迭代器领跑,最大化跳过无效文档
INFINI Easysearch 是一款专注于企业级场景的分布式近实时搜索与分析引擎。它以 Apache Lucene 为内核进行了增强,在保持与行业主流搜索协议及开发生态完全兼容的同时,重点强化了安全性、稳定性、压缩率及信创兼容性。
一、回顾与引入
在第一篇中,我们走完了布尔查询从用户 JSON 到 Lucene 执行的构建层旅程:Easysearch 的 BoolQueryBuilder 会保留同类子句的书写顺序,Lucene 的 BooleanQuery.rewrite() 则通过等价改写简化查询结构。
其中,和本文关系最直接的是 SHOULD + FILTER → MUST:一个原本只是“可选加分”的 SHOULD 子句,如果同时出现在 FILTER 中,就会被改写成 MUST。它的执行路径也随之改变——从可选评分路径,进入更直接的合取路径。
所谓合取路径,就是按 AND 语义执行查询:所有必选条件都要同时满足,任意一个不满足就可以跳过该文档。对于 MUST / FILTER 这类合取子句,真正影响性能的不是用户在 JSON 里先写谁、后写谁,而是 Lucene 在执行层如何安排它们的检查顺序。
这就是本文要讲的“布尔查询子句重排序”:进入 Scorer 构造阶段后,每个 MUST / FILTER 子句会变成对应的文档迭代器,Lucene 再按 cost() 对这些迭代器重新排序,让匹配文档最少的迭代器先领跑。
一个直觉可以帮助我们理解:在 AND 查询中,谁的结果最少,谁最有"话语权"。因为 AND 语义要求所有条件都满足,所以结果最少的那个条件能最快地排除不满足的文档,剩下的条件只需要确认即可。
本文就专注于这条合取路径的核心机制:ConjunctionDISI 如何按 cost 排序,让最稀疏的迭代器领跑整场迭代。
二、前置:什么情况下走 ConjunctionScorer?
上面已经说明,rewrite 可能会把子句带入合取路径;但并不是所有 bool 查询都会走这条路径。本节先界定范围:哪些查询会进入合取路径,哪些不会。Lucene 在 Boolean2ScorerSupplier.getInternal() 中会根据子句组合做这个判断。
| 查询形态 | 是否进入合取路径 | 简单理解 |
|---|---|---|
| 多个 MUST / FILTER | 是:ConjunctionScorer → ConjunctionDISI |
标准 AND 查询:所有条件都必须满足 |
| 只有一个 MUST / FILTER | 不需要 | 只有一个迭代器,没必要做求交和排序 |
MUST / FILTER + SHOULD,且 minShouldMatch = 0 |
必选部分进入 | 先用 MUST / FILTER 圈定候选集,SHOULD 只负责加分 |
MUST / FILTER + SHOULD,且 minShouldMatch > 0 |
整体进入 | 除了必选条件,还要求 SHOULD 至少命中 N 个 |
| 只有 SHOULD | 否 | 这是 OR 查询,走 WANDScorer 或 DisjunctionSumScorer,不是本文的合取路径 |
对本文来说,记住一个判断就够了:只要查询里出现多个“必须同时满足”的条件,Lucene 就需要做交集计算,ConjunctionDISI 的 cost 排序就有发挥空间。
那么 ConjunctionDISI 内部到底做了什么?让我们深入源码。
三、核心揭秘:ConjunctionDISI 按 cost 排序
这是合取查询最核心的优化。
3.1 生活类比
可以把合取查询理解成多条件筛选:先用结果最少的条件缩小候选集,再让其他条件确认,通常最省事。
比如在快递系统里找“已签收、发往北京、备注里有易碎品”的包裹。“已签收”和“发往北京”的包裹可能很多,但“备注里有易碎品”的包裹很少。先从“易碎品”开始查,再确认它是否发往北京、是否已签收,比先遍历所有已签收包裹更快。
3.2 源码解析
先解释一下“迭代器”,比如下文的 DocIdSetIterator。迭代器可以理解为某个查询条件对应的匹配文档列表游标。它负责在自己的列表里向前移动,告诉 Lucene:下一个匹配这个条件的 docID 是谁。
比如 author:sam 的迭代器里可能是 [42, 78, 203],category:ai 的迭代器里可能是 [12, 42, 100, 203]。执行 AND 查询时,Lucene 要做的就是不断推进这些游标,找到它们共同出现的 docID,比如这里的 42 和 203。
所以,本文说的“重排序”不是改写用户 JSON 里的子句顺序,而是在执行阶段对这些子句对应的迭代器排序:谁的 cost() 更小,谁就更靠前执行。
核心逻辑在 Lucene 的 ConjunctionDISI.java(ConjunctionDISI.java:154-163):
private ConjunctionDISI(List<? extends DocIdSetIterator> iterators) {
    assert iterators.size() >= 2;

    // Sort the array the first time to allow the least frequent DocsEnum to
    // lead the matching.
    CollectionUtil.timSort(iterators,
        (o1, o2) -> Long.compare(o1.cost(), o2.cost()));
    lead1 = iterators.get(0);  // 代价最小 → 领头
    lead2 = iterators.get(1);
    others = iterators.subList(2, iterators.size()).toArray(new DocIdSetIterator[0]);
}
三行代码,逻辑清晰:
- 按
cost()升序排序:cost()返回迭代器预估的匹配文档数,越少越"便宜"(注:cost 是预估值,实际匹配数可能有偏差,但排序逻辑依然成立) lead1:代价最小的迭代器,负责领头跳转——它最稀疏,每次跳转跳过的文档最多lead2:代价第二小的迭代器,负责二次确认others:其余迭代器,仅在 lead1 和 lead2 都停下时才被调用
3.3 执行过程
核心迭代方法 doNext()(ConjunctionDISI.java:165-199):
private int doNext(int doc) throws IOException {
    advanceHead:
    for (; ; ) {
        // doc 是当前 lead1 停住的位置;lead1 是最稀疏的迭代器,负责给出候选 docID
        assert doc == lead1.docID();

        // 先让 lead2 追上 lead1:advance(doc) 会跳到 >= doc 的第一个文档
        final int next2 = lead2.advance(doc);
        if (next2 != doc) {
            // lead2 跳过了当前 doc,说明当前候选不匹配;lead1 跳到 lead2 的位置作为新起点
            doc = lead1.advance(next2);
            if (next2 != doc) {
                // 仍没对齐,说明 lead1 又跳到了更后面,重新开始对齐
                continue;
            }
        }

        // lead1 和 lead2 对齐后,再检查其他迭代器
        for (DocIdSetIterator other : others) {
            // other 可能在上一轮已经被推进过;只有落后时才需要追赶
            if (other.docID() < doc) {
                final int next = other.advance(doc);
                if (next > doc) {
                    // other 跳过了当前 doc,当前候选失败;lead1 追到新的最大 docID
                    doc = lead1.advance(next);
                    continue advanceHead;
                }
            }
        }

        // 所有迭代器都停在同一个 doc 上 → 这个文档满足所有条件
        return doc;
    }
}
这段代码的核心就是“不断对齐”:谁跳到了更大的 docID,其他迭代器就追上去;直到所有迭代器停在同一个 docID,才算匹配成功。
例如 lead1 停在 78,而 lead2.advance(78) 返回 100,就说明 78 不可能匹配。Lucene 会直接把 lead1 推进到 100 附近,而不是继续检查 79、80、81……这些中间文档。
3.4 直观示例
为突出 cost 的量级差异,下面用夸张的数量级示意(§六会给出真实测试索引的实测数据,数量级更小,但结论一致):
查询:must: [status:published(100万), category:ai(1万), author:sam(500)]

迭代器按 cost 排序后:
  lead1: author:sam     cost=500     ← 最稀疏,领头跳转
  lead2: category:ai    cost=10,000
  other: status:published cost=1,000,000

执行过程:
  lead1 → doc=42 → lead2确认✓ → other确认✓ → 匹配!
  lead1 → doc=78 → lead2确认✗ → 跳过(不用查 other)
  lead1 → doc=203 → lead2确认✓ → other确认✓ → 匹配!

  如果没有 cost 排序,让高频词先给出候选,后续条件就要确认大量无效文档。
cost排序的效果:Lucene 实际执行时,lead1 一定是 cost 最小的迭代器(即最低频)。低频迭代器先领头,可以显著减少候选文档数量。
3.5 子合取展平
还有一个值得注意的细节:当嵌套的 ConjunctionDISI 作为子句出现时,会被"拆包"展平(ConjunctionDISI.java:54-77):
} else if (disi.getClass() == ConjunctionDISI.class) {
    // 发现子句本身也是一个 ConjunctionDISI,也就是嵌套的 AND 查询
    ConjunctionDISI conjunction = (ConjunctionDISI) disi;

    // 不把整个子 ConjunctionDISI 当成一个黑盒,
    // 而是把它内部已经拆好的 lead1、lead2、others 全部取出来
    allIterators.add(conjunction.lead1);
    allIterators.add(conjunction.lead2);
    Collections.addAll(allIterators, conjunction.others);
}
这些迭代器取出来后,会和外层迭代器一起进入统一排序流程。也就是说,Lucene 不会把内层 AND 当成一个整体参与外层排序,而是先展平,再让所有迭代器按 cost 统一排序。
这确保了基于 cost 估算的全局最优迭代顺序——如果内层有一个极稀疏的迭代器,它也有机会“越级”成为全局 lead1,而不是被锁在内层。
注意这里使用了精确类检查 disi.getClass() == ConjunctionDISI.class,而不是 instanceof。这是为了确保只拆包原始的 ConjunctionDISI,不误拆子类(如 BitSetConjunctionDISI,它有自己的优化路径)。
四、延伸:候选文档确定后,验证也要按成本排序
前面讲的是 cost() 排序:在多个迭代器之间,先让匹配文档最少的迭代器领头,尽量少产生候选文档。它背后的思想是:把执行成本低、过滤能力强的步骤放在前面,尽早排除不匹配的文档。
matchCost() 排序是这个思想在“验证阶段”的延伸:cost() 决定“谁先领头找候选”,matchCost() 决定“先做哪个精确验证”。
为什么候选文档还要验证?因为有些迭代器是"近似的"——先用低成本方式定位可能匹配的文档,再用精确方式二次确认。典型场景是短语查询:先对短语中的每个词做倒排合取,得到“包含全部词”的候选文档,再检查这些词是否出现在符合要求的相对位置上。前者用 posting list 快速缩小范围,后者才是真正的精确匹配。
Lucene 用 TwoPhaseIterator 表示这种两阶段验证,而 ConjunctionTwoPhaseIterator 会按 matchCost() 从低到高排序,让便宜的验证先执行;一旦失败,就不用再执行后面更贵的验证(ConjunctionDISI.java:317-357):
CollectionUtil.timSort(twoPhaseIterators,
    (o1, o2) -> Float.compare(o1.matchCost(), o2.matchCost()));
类比:先查身份证(快,matchCost 低),再查指纹(慢,matchCost 高),而不是反过来。如果身份证就不对,指纹根本不用查。
与 cost() 不同,matchCost() 没有统一公式:它是每个 TwoPhaseIterator 子类按自身验证逻辑估算的“简单操作数”(如 DocValues 查 bitset 约记为 3 次操作)。这个值比较粗略,实际排序时用到的只是相对大小——让便宜的验证先跑。
在实际代码中,ConjunctionDISI.createConjunction() 会把执行过程拆成两个阶段来看:
- 找候选 docID:用
allIterators完成。普通迭代器会直接放进来;如果某个查询是两阶段查询,就把它的“近似迭代器”放进来,先参与cost()排序和合取对齐。 - 验证候选是否真的匹配:用
twoPhaseIterators完成。这里保存的不是另一批文档列表,而是候选 docID 命中后要执行的matches()验证逻辑,并按matchCost()排序。
所以可以理解为:allIterators 负责“先找可能匹配的文档”,twoPhaseIterators 负责“再确认这些文档是否真的匹配”。前者按 cost() 排序,目标是少产生候选;后者按 matchCost() 排序,目标是少做昂贵验证。
五、进阶补充:cost 排序还会影响子查询策略
前面讲的是 cost 排序对“当前这一层”的影响:选出最稀疏的迭代器作为 lead1,减少候选文档。但 cost 排序选出的 lead1 还会带来一个连锁效应:它把代价信息继续传给子查询,让子查询也能根据外层的调用频率选择更合适的执行方式。
这个连锁效应的起点是:在合取查询里,外层最终会由最稀疏的迭代器领头,所以其他子查询被推进的次数通常不会超过这个领头迭代器的规模。这个规模就是向外传播给子查询的代价上限。Lucene 在 Boolean2ScorerSupplier.getInternal() 中用 Math.min(leadCost, cost()) 给这个估计加了一个上限(Boolean2ScorerSupplier.java:126):如果上层传来的 leadCost 过大,就用当前查询自己的 cost() 压住,避免子查询误判使用模式。对于纯合取查询来说,这个值通常接近 lead1.cost()。
这个向外传播的代价上限,就是 leadCost。它可以理解为上层给子查询的一个提示:“接下来你大概要被推进这么多次”。它不是 ConjunctionDISI 内部的概念,而是 ScorerSupplier.get(long leadCost) 的参数。
这里的“推进”指的是:上层会不断要求子查询的迭代器向后移动,要么调用 nextDoc() 走到下一个匹配文档,要么调用 advance(target) 直接跳到 >= target 的文档。
为什么这个提示有用?因为不同实现适合不同使用方式:如果会被频繁推进,就适合用支持高效跳转的结构;如果只会被少量推进,就可以选择初始化成本更低的结构。一个典型例子是 IndexOrDocValuesQuery。它内部同时持有索引结构(点数据 / term 查询)和 DocValues 两种策略,会根据 leadCost 动态选择(IndexOrDocValuesQuery.java:176-186):
public Scorer get(long leadCost) throws IOException {
    final long threshold = cost() >>> 3;  // cost / 8
    if (threshold <= leadCost) {
        return indexScorerSupplier.get(leadCost);   // 推进频繁:用索引结构
    } else {
        return dvScorerSupplier.get(leadCost);      // 推进较少:用 DocValues
    }
}
简单说:外层通过 cost 排序估算推进频率,再把这个信息传给子查询;子查询只需要判断“我会被频繁推进,还是只会偶尔确认”,就能做出局部最优选择。
六、一个 MUST 查询是如何被重新排序的
用一个简单的 MUST 查询,把第一篇的 rewrite 和本文的 cost 排序串起来。下面这个例子中,status:published 写在前面,category:ai 写在后面:
GET /bool_cost_profile_test/_search
{
  "profile": true,
  "query": {
    "bool": {
      "must": [
        { "term": { "status": "published" }},
        { "term": { "category": "ai" }}
      ]
    }
  }
}
完整过程可以拆成四步:
① Easysearch 层:按用户写法构建 BooleanQuery
   profile description 仍显示:+status:published +category:ai

② Lucene rewrite:2 个 MUST,无重复、无矛盾
   查询形态保持为两个 MUST 子句

③ Scorer 构造:
   Boolean2ScorerSupplier.req() → new ConjunctionScorer(...)
   ConjunctionScorer 内部创建 ConjunctionDISI
   ConjunctionDISI 再按 cost 对迭代器排序

④ 执行:
   低 cost 的 category:ai 负责产生候选 docID
   status:published 通过 advance(candidate) 追赶确认
在本地 Easysearch 2.2.0 / Lucene 9.12.2 的测试索引中,status:published 约 900 条,category:ai 约 100 条。实际 profile 结果是:
子句                 next_doc_count   advance_count   说明
──────────────────────────────────────────────────────────────
category:ai          91               1               低 cost,产生候选
status:published     0                91              跟随候选,用 advance 确认
把 JSON 里的两个 MUST 顺序反过来再查,profile 仍然显示 category:ai 通过 nextDoc() 产生候选,status:published 通过 advance() 确认。也就是说,description 会保留查询展示顺序,但真正执行时的迭代器顺序由 cost 排序决定。
这就是本文的关键点:用户在 JSON 中先写谁,不等于执行时谁先跑。对于合取查询,Lucene 会在 Scorer 构造阶段按 cost 重新安排迭代器顺序,让更稀疏的条件领头。唯一的例外是多词查询混入 must/filter 且版本较老的场景,见 §八末尾的边界说明。
双条件场景验证了"重排序确实发生",接下来看三条件场景如何用 Profile 观察。
七、如何用 Profile API 观察 cost 排序效果
现在扩展到三条件,重点看一个更极端的对比:author:sam 只有 5 条,status:published 有 900 条。Profile 不会直接告诉你 lead1 是谁,但可以通过 next_doc_count 和 advance_count 的分布间接推断。
在同一个测试索引上,查三个 MUST:
"must": [
  { "term": { "status": "published" }},
  { "term": { "category": "ai" }},
  { "term": { "author": "sam" }}
]
BooleanQuery 的子节点大致如下:
子句                 next_doc_count   advance_count   说明
──────────────────────────────────────────────────────────────
author:sam           5                1               最稀疏,负责产生候选 docID
category:ai          0                6               跟随候选,用 advance 对齐
status:published     0                5               跟随候选,用 advance 对齐
注意跟随迭代器的
advance_count未必完全相等,这和实际匹配过程中发生的追赶次数有关,不影响"谁是领头"的判断。
如何看这份 Profile
Profile 不会直接打印 lead1,但指标和源码是对应的:ConjunctionDISI.nextDoc() 会调用 lead1.nextDoc() 产生下一个候选;进入 doNext() 后,再通过 lead2.advance(doc) 和 other.advance(doc) 让其他迭代器追赶。next_doc_count 和 advance_count 统计的正是这些底层调用。
可以总结成一条简单观察规律:
- 领头迭代器:
next_doc_count通常更高,它要不断产生候选 - 跟随迭代器:
advance_count通常更高,它只在候选 docID 上确认
需要注意:Profile 只提供观察线索,不同 Lucene 版本、查询类型(DocValues、PointRange 等)和数据分布,都可能让 next_doc / advance 的表现有所不同。特别是当查询走了 BitSet 优化路径或 BlockMaxConjunctionScorer 时,指标分布会不一样。解读时要结合 description、type 和各子节点的 breakdown 一起判断。
八、小结与预告
回到本系列的主题:布尔查询子句重排序。本文讲的是其中最典型的一种——MUST / FILTER 这类合取子句进入执行层后,会从“用户书写顺序”转换为“按 cost 排序的迭代器执行顺序”。
本文着重介绍的核心机制包括:
- ConjunctionDISI 按 cost 排序:最稀疏的迭代器领头,其他迭代器仅做确认,最大化跳过无效文档
- 两阶段验证按 matchCost 排序:最便宜的验证先执行,失败即可短路
- leadCost 传播:代价信息从外向内传播,子查询据此做局部最优策略选择(如 IndexOrDocValuesQuery 的自适应切换)
- 子合取展平:嵌套的 ConjunctionDISI 被拆包到同一层级,确保全局最优的迭代顺序
这些机制的共同特点是:代价感知 + 动态决策——排序在 Scorer 构造时完成,与用户书写顺序无关。
一条边界:老版本里混入多词查询,顺序仍然敏感
"与书写顺序无关"有个前提:每个子句在调度阶段都能被轻量地试探。TermQuery 满足——预建的 TermStates 让它能 O(1) 判断某段有无匹配,没有就返回 null,短路掉还没轮到的子句。但 prefix / wildcard / regexp / range-on-keyword / fuzzy 这类多词查询在 Lucene 9.5 之前不满足:它们一旦被调度就同步干重活——枚举全部 term、读倒排、建 bitset——而调度又是按书写顺序进行的。
在一个 2900 万文档、23 个主分段的索引上实测,must 里放一个极稀疏的 term(命中 12 篇,只落在 6 个段)和一个极稠密的 prefix(展开约 11.7 万个 term):
| must 写法 | prefix.build_scorer_count | 稳态耗时 |
|---|---|---|
[prefix, term] |
36 | ≈ 92 ms |
[term, prefix] |
6 | ≈ 35 ms |
两条查询逻辑等价却差了近 3 倍:prefix 写前面时,其余 17 个段的 term 返回 null 触发整段短路,但 prefix 的 bitset 已经白白建好又扔掉;term 写前面时,这些段根本轮不到 prefix 出场。
💡 结论:稀疏廉价的子句写在前面,让它先行短路,昂贵的多词查询就不会被无效触发。
分界线是 Lucene 9.5(PR #12055):多词查询的 wrapper 自此实现了轻量的 ScorerSupplier,调度阶段只估成本不干活,重活推迟到真正取迭代器时才做,顺序自此真正无关。对应到版本:Easysearch 1.x 基于 Lucene 8.11,存在此问题;Easysearch 2.x 基于 Lucene 9.12,已包含修复——本文的全部结论在其上均成立。
但合取查询的优化目标很明确:所有子句都要匹配,找"最少"的那个领头即可。析取(SHOULD)场景完全不同:不需要全部匹配,而是找 Top-K 高分文档。优化目标从"最少匹配"变为"最高分数贡献",WAND 算法登场——第三篇详解。
作者:冯田立,极限科技(INFINI Labs)Easysearch 搜索引擎研发专家,曾在亚马逊 AWS 有多年的 Elasticsearch 开源插件和 OpenSearch 的开发经验和客户集群的运维经验,并有幸参与 OpenSearch 的创立。
Easysearch 布尔查询子句重排序(一)|你的 BoolQuery 写法,真的影响性能吗?
Easysearch • INFINI Labs 小助手 发表了文章 • 0 个评论 • 5648 次浏览 • 2026-09-29 18:58
从 Easysearch 到 Lucene,查询构建层的 11 条优化规则
INFINI Easysearch 是一款专注于企业级场景的分布式近实时搜索与分析引擎。它以 Apache Lucene 为内核进行了增强,在保持与行业主流搜索协议及开发生态完全兼容的同时,重点强化了安全性、稳定性、压缩率及信创兼容性。
一、开篇:一个常见的误解
"must 里面,是不是应该把匹配文档少的条件写在前面?这样能提前过滤掉大量文档,性能更好?"
这个直觉来得很自然,但它是错的。
┌─────────────────────────────────────┐
│  用户的直觉:                         │
│  must: [高频词, 低频词] → 慢          │
│  must: [低频词, 高频词] → 快          │
│                                     │
│  实际情况:                          │
│  两种写法性能完全相同!                │
│  Lucene 执行时自动按 cost 排序        │
└─────────────────────────────────────┘
Easysearch 执行时会按 cost 自动重排子句顺序,与你写查询时的顺序无关。不过"子句顺序不重要"并非处处成立,它有一条跟版本挂钩的边界——must/filter 里混入 prefix/wildcard 这类多词查询时,老版本引擎会重新对顺序敏感(详见第二篇 §八的边界说明)。而且"子句顺序不重要"也不代表"怎么写都一样"——理解引擎自动优化的边界在哪里,才能设计出更合理的查询结构。
本文是系列第一篇,聚焦构建层:从你发出 JSON 到查询进入执行引擎,中间经历了哪些变换?哪些优化在这个阶段完成?哪些要留到执行层?后续三篇将分别深入合取查询的 cost 排序、析取查询的 WAND 剪枝,以及 Block-Max 块级剪枝与实战验证。
二、全景:一次布尔查询的完整旅程
先建立一张全局地图,再深入每一层。
举个例子:一条布尔查询就像一个包裹进入工厂流水线,经过三道工序:
- 第一道(Easysearch 层):质检员检查包裹格式是否合规,缺不缺东西,但不重新排列里面的物品顺序
- 第二道(Lucene rewrite):工艺师合并重复部件、去掉矛盾组合、把"可选"升级为"必选"——改变的是包裹的内容结构,不是物品顺序
- 第三道(Scorer 层):调度员拿到最终包裹,按每个部件的"处理成本"自动安排加工顺序——这才是代价排序发生的地方
用技术语言描述,这三道工序对应的是(注意①和②③分属不同阶段):
用户 JSON
   │
   ▼
┌──────────────────────────────────────────┐
│  Easysearch 层(构建层)                   │
│  ① doRewrite() — 递归重写 + 早期终止       │
│  ② applyMinimumShouldMatch              │
│  ③ fixNegativeQueryIfNeeded             │
│  (①在 rewrite 阶段,②③在 doToQuery()内)│
│  职责:结构合法化,不改子句顺序              │
└────────────────┬─────────────────────────┘
                 │ toQuery() → BooleanQuery
                 ▼
┌────────────────────────────────────────────┐
│  Lucene rewrite 层(逻辑重写层)             │
│  ④ BooleanQuery.rewrite()                 │
│  (IndexSearcher 中 rewrite→createWeight) │
│  职责:11条逻辑等价改写,不改结果只改形态       │
└────────────────┬───────────────────────────┘
                 │ createWeight()
                 ▼
┌──────────────────────────────────────────┐
│  Scorer 构造层(执行层)                   │
│  ⑤ ConjunctionDISI:按 cost() 排序 ✅    │
│  ⑥ WANDScorer:按 maxScore 动态重排 ✅    │
│  职责:代价感知,真正的性能优化在这里         │
└────────────────┬─────────────────────────┘
                 │
                 ▼
执行查询,返回结果一个关键认知:代价排序发生在第⑤步(Scorer 层)。前两道工序只做逻辑等价改写——合并重复、升级类型、展平嵌套,但不改变查询结果。
本文讲前两层(①~④),后三篇讲第⑤⑥步。
三、Easysearch 层:结构合法化,不碰顺序
你发出的 JSON,首先被 Easysearch 的 BoolQueryBuilder 解析成内部的查询对象。这一层做的事情很克制:保证查询结构合法,但不改变子句顺序。
3.1 子句是如何被添加的
BoolQueryBuilder.doToQuery() 按照固定顺序把子句添加到 Lucene 的 BooleanQuery.Builder 中:
must → mustNot → should → filter不同类型之间的添加顺序是固定的(无论你的 JSON 里先写 should 还是先写 must),但同一类型内的子句顺序与 JSON 书写顺序一致——这通常不影响性能,因为代价排序发生在更下游的 Scorer 层;唯一的例外见第二篇 §八:老版本上混入多词查询时,书写顺序仍会起作用。
3.2 三种特殊处理
Easysearch 层会做三类结构合法化处理:
doRewrite() 的早期终止:
- 如果整个 BoolQuery 为空(没有任何子句),退化为
MatchAllQueryBuilder(等价于 Lucene 的MatchAllDocsQuery) - 如果任何
must或filter子句重写后变为MatchNoneQueryBuilder,整个 BoolQuery 直接返回该MatchNoneQueryBuilder——不需要继续执行 - 如果没有
must/filter子句,但所有should子句都重写为MatchNoneQueryBuilder,整个 BoolQuery 也退化为MatchNoneQueryBuilder——没有必须匹配的子句,所有可选子句又都匹配零文档,结果必然为空
fixNegativeQueryIfNeeded():
当查询只有 must_not 子句、没有任何正向匹配条件时,Lucene 的 BooleanQuery 不知道"从哪些文档里排除"。Easysearch 自动插入一个 MatchAllDocsQuery 作为基础集合。该修复受 adjust_pure_negative 开关控制(默认为 true,可设为 false 关闭):
输入:must_not: [term:spam]
处理:加入 MatchAllDocsQuery (作为 FILTER)
输出:filter: [MatchAll] + must_not: [term:spam]
= "所有文档 除了 spam"applyMinimumShouldMatch():
把用户设置的 minimum_should_match 规格字符串(支持整数 "2"、百分比 "75%"、条件式 "3<75%" 等)解析为 int,写入 Lucene 的 BooleanQuery.setMinimumNumberShouldMatch()。
总结:Easysearch 层不改变子句顺序,只做合法化修补。真正的优化交给下游。
四、Lucene rewrite 层:11 条逻辑等价改写规则
查询经过 toQuery() 变成 Lucene 的 BooleanQuery 对象后,会调用 BooleanQuery.rewrite()。这是本文的核心章节。
这一层不做代价排序,而是通过 11 条规则改写查询的形态——去重、提升、展平——但保证改写前后查询结果完全一致,为后续执行层的高效优化铺路。
📌 本文按理解难度递进排列规则编号。源码中
BooleanQuery.rewrite()实际包含 12 个步骤,本文将其中 SHOULD 去重和 MUST 去重合并为规则 8,并按逻辑将 MatchAll→ConstantScore 编为规则 11,因此源码实际执行顺序按本文编号为:1→2→3→4→5→6→7→8→11→9→10(ConstantScore 转换在展平和 minShouldMatch 对齐之前执行)。
规则 1-3:消除不可能、去重、矛盾检测
这三条是防御性规则,含义很容易理解,快速过一遍:
| # | 规则 | 触发条件 | 行为 |
|---|---|---|---|
| 1 | 空查询消除 | 没有任何子句 | → MatchNoDocsQuery |
| 2 | 单子句拆包 | 只有 1 个子句 | 拆掉 BooleanQuery 外壳,直接用内部查询。SHOULD/MUST 直接返回内部查询;FILTER 包裹为 BoostQuery(ConstantScoreQuery(query), 0)(确保得分为零);MUST_NOT → MatchNoDocsQuery |
| 3 | 递归重写 + MatchNoDocs 短路 | 子句重写后变化,或含 MatchNoDocs | 递归简化每个子句(FILTER/MUST_NOT 先包裹 ConstantScoreQuery 再重写再剥壳,SHOULD/MUST 直接重写);SHOULD/MUST_NOT 中的 MatchNoDocs 直接移除,MUST/FILTER 中的 MatchNoDocs 导致整体短路 |
规则 2 示例:
BooleanQuery { MUST: [TermQuery(status:published)] }
       ↓  rewrite
TermQuery(status:published)

BooleanQuery { FILTER: [TermQuery(status:published)] }
       ↓  rewrite
BoostQuery(ConstantScoreQuery(TermQuery(status:published)), 0)

规则 3 示例:
must: [MatchNoDocsQuery], should: [TermQuery(A)]
       ↓  rewrite(MUST 中含 MatchNoDocs → 整体短路)
MatchNoDocsQuery
规则 4-6:去重、矛盾检测、冗余移除
继续快速过:
| # | 规则 | 触发条件 | 行为 |
|---|---|---|---|
| 4 | FILTER/MUST_NOT 去重 | 相同子句重复出现 | HashSet 自动去重(基于 Query.equals())。SHOULD/MUST 用 Multiset 保留重复(以便后续规则 8 做 boost 求和) |
| 5 | 矛盾检测 | MUST 或 FILTER 与 MUST_NOT 含同一子句,或 MUST_NOT 含 MatchAll | → MatchNoDocsQuery |
| 6 | 冗余 FILTER 移除 | FILTER 与 MUST 重叠,或 FILTER 含 MatchAll | FILTER/MUST 重叠:无条件移除冗余 FILTER;FILTER 含 MatchAll:仅当移除后仍有正向子句时移除(filters.size() > 1 \|\| !mustClauses.isEmpty()) |
规则 4 示例:
filter: [term:active, term:active, range:age>18] → filter: [term:active, range:age>18]

规则 6 示例:
must: [term:active], filter: [term:active, range:age>18] → must: [term:active], filter: [range:age>18]
规则 7:SHOULD + FILTER → MUST 提升 ⭐
触发条件:同一个子查询同时出现在 SHOULD 和 FILTER 子句中。
行为:将该子查询的 SHOULD 子句改为 MUST(原 FILTER 子句直接丢弃,因为 MUST 已隐含了 FILTER 的过滤语义)。源码里会同时下调 minimumNumberShouldMatch(每提升一个子句 minShouldMatch--,循环结束后统一 Math.max(0, minShouldMatch) 确保不低于 0):
- 若提升后
minShouldMatch == 0,mix 路径走 req+opt(ReqOptSumScorer) - 若提升后
minShouldMatch > 0,仍走 conjunction-disjunction mix(ConjunctionScorer(req,opt))
也就是说,规则 7 一定会改变查询形态,但是否切到 ReqOptSumScorer 取决于 minShouldMatch 是否归零。
优化前:
┌───────────────────────┐
│ SHOULD: [term:A]      │
│ FILTER: [term:A]      │
│ SHOULD: [term:B]      │
└───────────────────────┘
         ↓  rewrite
优化后:
┌───────────────────────┐
│ MUST:   [term:A]      │  ← 提升为 MUST!
│ SHOULD: [term:B]      │
└───────────────────────┘
💡 类比:一个人同时是"候选人"(SHOULD)又是"已入职"(FILTER)。既然已经入职,直接列入正式编制(MUST)。
⚠️
minShouldMatch联动:每将一个 SHOULD 提升为 MUST,minimumNumberShouldMatch相应减 1(循环结束后Math.max(0, minShouldMatch)兜底),确保语义等价。例如原有minimum_should_match: 2且两个 SHOULD 中有一个被提升,重写后minShouldMatch变为 1。
规则 8:SHOULD / MUST 去重(boost 求和)
触发条件:SHOULD 或 MUST 中出现了相同的子句(解包 BoostQuery 后底层查询相同)。注意:SHOULD 去重仅在 minimumNumberShouldMatch ≤ 1 时触发;若 minShouldMatch > 1,Lucene 不会合并重复的 SHOULD 子句(多个重复出现在高 minShouldMatch 场景下语义不可简单合并)。MUST 去重则没有此限制,无论 minShouldMatch 为何值都会合并重复的 MUST 子句。
行为:合并重复子句,将它们的 boost 相加。FILTER 和 MUST_NOT 的去重由规则 4 处理(直接删除),而 SHOULD 和 MUST 的重复是有意义的——不同的 boost 意味着不同的评分权重,所以求和保留。不合并的话,同一个 term 会创建两套独立的迭代器,都遍历相同的文档列表,浪费翻倍。
should: [term:hello^1.5, term:hello^2.0, term:world]
       ↓  rewrite
should: [term:hello^3.5, term:world]
(两个 hello 的权重合并:1.5 + 2.0 = 3.5)
💡 类比:一个学生选了同一门课两次,一次记 1.5 学分,一次记 2 学分。不需要上两次课,合并为 3.5 学分即可。
规则 9:SHOULD 嵌套展平 ⭐
触发条件:一个 bool 查询的 SHOULD 子句里,嵌套了另一个纯 SHOULD 的 bool 查询(即内层没有 MUST、FILTER、MUST_NOT,只有 SHOULD,且 minimum_should_match ≤ 1)。
行为:把内层 SHOULD 子句全部"提升"到外层,展平为同一级别的 SHOULD 子句。展平后 WAND 能看到每个子句的独立 maxScore,估算更紧,剪枝更激进;如果不展平,WAND 只能看到内层查询的总体上界(黑盒),剪枝不够狠。
优化前:
       BoolQuery (外层)
      /                \
   SHOULD            SHOULD
  (term:A)        (内层 BoolQuery)
                     /      \
                 SHOULD    SHOULD
                (term:B)  (term:C)

         ↓  rewrite

优化后:
       BoolQuery
      /    |    \
  SHOULD SHOULD SHOULD
(term:A)(term:B)(term:C)实践建议:如果你在 should 里嵌套了多层 bool,且内层全是 SHOULD 子句,EasySearch 会自动展平。但如果内层有 minimum_should_match >= 2,则不会展平(语义不等价),这类情况应尽量手动展平或重构查询结构。
💡 为什么展平能更激进地剪枝?假设内层 bool 有两个子句,maxScore 分别是 8 和 3。展平前,WAND 只看到"这个内层查询最多得 8+3=11 分",不管当前文档匹配了哪些子句,上界永远是 11;展平后,WAND 逐子句检查——某个文档如果不匹配 maxScore=8 的子句,只剩 maxScore=3 的子句可能匹配,上界从 11 降到 3。如果录取线是 5,3 < 5,这个文档不可能入选——直接跳过,不用再算分了。
规则 10:SHOULD 数量与 minimumShouldMatch 的对齐
触发条件:SHOULD 子句数量与 minimum_should_match 的大小关系。
行为:分两种情况:
- SHOULD 数量 < minimumShouldMatch:不可能满足 → 直接返回
MatchNoDocsQuery,省去无用计算 - SHOULD 数量 == minimumShouldMatch:所有 SHOULD 提升为 MUST,从 WANDScorer(调度开销大)转入 ConjunctionDISI(cost 排序,更高效)
should: [A, B],minimum_should_match: 3
       ↓  rewrite(2 < 3,不可能满足)
MatchNoDocsQuery

should: [A, B, C],minimum_should_match: 3
       ↓  rewrite(3 == 3,等价于全部 MUST)
must: [A, B, C]
💡 类比:开会时,如果"3 个可选发言人必须全部到场"——那"可选"就没意义了,等价于"3 个必须到场"。如果要求"3 人到场但只有 2 人可选"——不可能,直接取消会议。
一个容易忽略的场景:在动态拼接查询时(例如从用户的多个筛选条件生成 should,然后设置 minimum_should_match 等于条件数量),这条规则会自动把它转化为更高效的 MUST 查询,无需手动改写。
规则 11:MatchAll + FILTER → ConstantScoreQuery
触发条件:BooleanQuery 恰好只有一个 MUST 子句且为 MatchAllDocsQuery,且至少有一个 FILTER 子句。
行为:将所有 FILTER + MUST_NOT 组成内部 BooleanQuery,整体包裹为 ConstantScoreQuery(绕过评分,返回固定分数),作为外层 MUST 加入;SHOULD 子句加回外层(不丢弃);原始 MatchAllDocsQuery 被消耗。MatchAllDocsQuery 在 BooleanQuery 框架里有额外调度开销,ConstantScoreQuery 执行路径更直接。
⚠️ 注意:纯
filter查询没有 MUST 子句,不满足musts.size() == 1的前提,不触发本规则。FILTER 子句直接进入合取路径,由ConjunctionDISI按 cost 排序处理。
在 11 条规则中,标 ⭐ 的规则 7(SHOULD+FILTER→MUST)和规则 9(SHOULD 嵌套展平)对执行性能影响最大——前者决定子句能否进入 ConjunctionDISI 的 cost 排序路径,后者决定 WANDScorer 能否做全局剪枝。
五、实战:一条 rewrite 规则如何改变执行路径
前面列了 11 条规则,这一节用具体例子展示:构建层的一条 rewrite 规则,如何直接影响执行层的路径选择。
假设你有一个查询:
{
  "bool": {
    "should": [
      { "term": { "status": "published" } },
      { "term": { "category": "ai" } }
    ],
    "filter": [{ "term": { "status": "published" } }]
  }
}
status:published 同时出现在 should 和 filter——规则 7 会把它提升为 MUST,并下调 minShouldMatch。下图假设提升后 minShouldMatch=0,执行路径因此发生根本变化:
┌─────────────────────────────────────────────────────────────────┐
│  没有 rewrite 优化(假设)                                        │
│  minShouldMatch=1,走 conjunction-disjunction mix 路径           │
│                                                                 │
│  ┌────────────────────────────┐                                 │
│  │ ConjunctionScorer          │                                 │
│  │ ├─ FilterScorer            │  published 出现两次:            │
│  │ │  published (score=0)     │  • FILTER 里遍历一遍(只过滤)     │
│  │ └─ DisjunctionSumScorer    │  • SHOULD 里再遍历一遍(评分)     │
│  │    ├─ published            │  = 同一个 term 被两个迭代器        │
│  │    └─ ai                   │    各跑一遍,浪费!               │
│  └────────────────────────────┘                                 │
└─────────────────────────────────────────────────────────────────┘

┌─────────────────────────────────────────────────────────────────┐
│  rewrite 优化后(实际)                                           │
│  minShouldMatch=0,走 req+opt 路径                               │
│                                                                 │
│  ┌────────────────────────────┐                                 │
│  │ ReqOptSumScorer            │  published 只出现一次:           │
│  │ ├─ req: published (有评分)  │  • 作为 MUST,一次迭代同时        │
│  │ └─ opt: ai (可选加分)       │    完成过滤和评分                 │
│  └────────────────────────────┘                                 │
└─────────────────────────────────────────────────────────────────┘优化前,status:published 被两个迭代器各遍历一遍;优化后,一次迭代同时完成过滤和评分——一条 rewrite 规则,改变了执行路径的选择。它不做代价排序,但决定了哪些子句有资格进入更高效的路径。
六、动手验证:用 Profile API 观察 rewrite 效果
理论再多,不如自己跑一遍。Easysearch 的 Profile API 可以直接暴露 rewrite 后的查询形态,不需要读源码,几秒钟就能验证。
6.1 验证规则 7:SHOULD + FILTER → MUST 提升
准备好一个含有 status 和 category 字段的索引,执行:
GET /products/_search
{
  "profile": true,
  "query": {
    "bool": {
      "should": [
        { "term": { "status": "published" }},
        { "term": { "category": "ai" }}
      ],
      "filter": [
        { "term": { "status": "published" }}
      ]
    }
  }
}
找到响应中 profile.shards[0].searches[0].query[0].description 字段(具体格式可能因版本略有不同):
- 你写的:SHOULD + FILTER 并存(两个地方都有
status:published) - 实际执行:
+status:published category:ai
注意 + 前缀——在 Lucene 的查询 description 语法中,+ 表示 MUST,没有符号表示 SHOULD。status:published 前面有 +,说明 rewrite 已经把它提升为 MUST,查询形态已经发生了变化。
6.2 验证规则 10:SHOULD 数量 == minimumShouldMatch → 全部提升为 MUST
GET /products/_search
{
  "profile": true,
  "query": {
    "bool": {
      "should": [
        { "term": { "status": "published" }},
        { "term": { "category": "ai" }}
      ],
      "minimum_should_match": 2
    }
  }
}
profile 的 description 应该显示 +status:published +category:ai——两个 term 都带 + 前缀,说明全部提升为 MUST,这个查询实际上会走第二篇要讲的 ConjunctionDISI 路径,而非 WANDScorer。
6.3 理解 Profile 响应的结构
一个完整的 Profile 响应包含大量信息,但读懂核心字段只需关注三个位置:
{
  "profile": {
    "shards": [{
      "searches": [{
        "query": [{
          "type": "BooleanQuery",
          "description": "+status:published +category:ai",
          "breakdown": {
            "next_doc": 12750,      "next_doc_count": 1,
            "advance":  0,          "advance_count":  0,
            "create_weight": 375375, "create_weight_count": 1,
            "build_scorer":  248958, "build_scorer_count":  2
          },
          "children": [
            { "type": "TermQuery", "description": "status:published", ... },
            { "type": "TermQuery", "description": "category:ai", ... }
          ]
        }],
        "rewrite_time": 146958
      }]
    }]
  }
}
快速解读三个关键位置:
| 字段 | 含义 | 怎么看 |
|---|---|---|
description |
rewrite 后的查询形态 | + 表示 MUST,无前缀表示 SHOULD,- 表示 MUST_NOT |
advance / advance_count |
迭代器跳转的耗时 / 次数 | 第二篇核心指标。count 越小 = 跳转越少 = cost 排序效果越好 |
rewrite_time |
rewrite 阶段的总耗时 | 本文 11 条规则的总执行时间,通常很小(微秒级) |
💡 小技巧:
breakdown里每个指标都有两个 key——xxx是耗时(纳秒),xxx_count是调用次数。想看"做了多少次"看_count,想看"花了多少时间"看不带_count的。
七、小结与预告
我们走完了布尔查询在执行前的两个构建层:
Easysearch 层做的是合法化处理——保持子句顺序,修补极端情况(纯否定、空查询、MatchNone 短路),设置 minShouldMatch。它不会改变你查询的"形状"。
Lucene rewrite 层通过 11 条逻辑等价改写规则改变查询的"形态":
- 规则 1-6 是防御性规则,消除空查询、冗余和矛盾
- 规则 7 和规则 10 是提升性规则,把更多子句导入 ConjunctionDISI 的合取路径,为 cost 排序创造更大的发挥空间
- 规则 9 是为析取优化准备的,展平 SHOULD 嵌套让 WANDScorer 能做全局剪枝
- 规则 8 是评分优化(合并重复 boost),规则 11 绕过不必要的评分计算
这两层都不做代价排序,但它们决定了哪些子句有资格进入更高效的执行路径。
下一篇预告
当 MUST 子句进入 Scorer 构造层,Lucene 会创建 ConjunctionDISI,对所有迭代器按 cost() 升序排序——最稀疏的放在第一位,承担"领头"角色,最大限度地用跳转(advance())跳过不满足条件的文档。
匹配文档最少的迭代器,为什么反而被选来驱动整个遍历?——它产生的候选集最小,所有迭代器的验证次数因此被压到最低。这个看似"以弱领强"的设计,正是合取查询性能优化的核心。我们在第二篇,通过源码、图解和 Profile API 实测,把这个机制讲透。
作者:冯田立,极限科技(INFINI Labs)Easysearch 搜索引擎研发专家,曾在亚马逊 AWS 有多年的 Elasticsearch 开源插件和 OpenSearch 的开发经验和客户集群的运维经验,并有幸参与 OpenSearch 的创立。
〖搜索客社区日报〗第2302期 (2026-09-21)
社区日报 • Muses 发表了文章 • 0 个评论 • 8820 次浏览 • 2026-09-22 21:05
Easysearch 原生集成国密算法:打造全链路自主可控搜索底座(二)
Easysearch • INFINI Labs 小助手 发表了文章 • 0 个评论 • 9798 次浏览 • 2026-09-20 18:32
从 2.1.0 版本开始,INFINI Easysearch 内置了对国密(SM2/3/4)算法的支持,实现了全链路国密合规,满足等保及商用密码应用安全性评估要求。本篇以 Kylin-Server V11 操作系统和 Easysearch 2.3.0 进行演示。
Linux 主机安装 Tongsuo
Easysearch 基于 铜锁(Tongsuo)提供国密 TLCP 双证书能力,支持 SM2/SM3/SM4 加密套件。下载完 Easysearch 软件包后解压进目录,执行脚本安装铜锁。
bin/install-tongsuo-local.sh --version 8.4.0
安装完后会有提示切换到铜锁。
能正常查看版本信息,说明安装、切换都正常。
一键初始化(单节点 TLCP)
如需在单节点场景快速完成证书生成、TLCP 配置写入和初始密码设置,可直接使用:
EASYSEARCH_INITIAL_ADMIN_PASSWORD='EasysearchP@ssw0rd!' bin/initialize.sh --tlcp -s执行上面的脚本会自动生成证书,修改 easysearch.yml 证书设置。
启动 Easysearch
从 Easysearch 的启动日志中可看到国密(Chinese SM algorithms)正常加载,并用来创建 SSLContext 。
客户端:用国密栈访问
curl 默认链接的 OpenSSL 密码库不支持国密协议(TLCP),因此 curl 访问 Easysearch 服务时加密协议最终回落到标准 TLS 1.3,套件为国际通用的 TLS_AES_128_GCM_SHA256。
用 Easysearch 发行包自带的 bin/tlcp-curl.sh 访问 Easysearch,可以看到加密套件是国密 TLS_SM4_GCM_SM3。
Java 应用默认使用的 OpenJDK 没有内置国密算法支持,所以不能直接走国密加密;要么换成支持国密的 JDK,要么在现有 JDK 中额外引入并注册国密算法实现。
相关阅读
Easysearch 2.4.0 发布:原生 HNSW 与混合检索,管理体验全面升级
资讯动态 • INFINI Labs 小助手 发表了文章 • 0 个评论 • 9776 次浏览 • 2026-09-20 18:23
INFINI Easysearch 2.4.0 正式发布。本版本将向量搜索纳入内核:基于 Lucene 的原生 HNSW,关键词与语义向量可混合检索。控制台新增可视化 Mapping 编辑器,集群设置可同时查看临时、持久、默认三层配置。生命周期策略、可搜索快照、密钥库与插件管理同步更新,高并发下的字段使用统计和磁盘用量分析也更稳定。
主要更新如下:
功能特性 (Features)
原生 HNSW 向量搜索与混合检索
- 内置基于 Lucene 的 HNSW 向量索引。新建索引可直接使用
dense_vector、query-levelknn和顶层knn,无需安装 k-NN 插件。 - 支持 1~4096 维
float向量,以及cosine、dot_product、l2_norm、max_inner_product四种相似度算法。 - 支持通过
m、ef_construction和num_candidates调整索引构建与查询效果;省略index_options时默认使用hnsw(m=16, ef_construction=100)。 - 支持一个顶层关键词
query与一个顶层knn并列执行,通过结果并集与加权评分实现关键词、语义向量的混合召回。 - 兼容 Elasticsearch 8.19.17 的 float HNSW mapping、Bulk、kNN 查询和 wire 行为,以及 Elasticsearch Java 8.19.17、Python 8.19.3 官方客户端,现有应用可直接对接。
更多用法及兼容边界请参阅原生 HNSW 搜索文档。
可视化 Mapping 编辑器
新增索引页提供可视化 Mapping 编辑器。字段按层级排列成树,可直接编辑类型和参数,无需手写 Mapping JSON。
- 可以从索引模板或已有索引导入配置。创建索引时,也可以关联集群里已有的别名。
- 覆盖全部字段类型。支持多字段,也可为
object/nested添加子字段,同类型字段可批量添加。 - 可视化编辑与 JSON 编辑可随时切换,内容保持同步。
dynamic_templates、_source、_meta等高级内容在切换后仍会保留。
操作步骤见新增索引。
集群设置页
在「设置」中打开集群设置页,查看和修改 _cluster/settings 中的动态配置。页面按节点、索引、分片、断路器、生命周期分组,支持按名称或 key 搜索,也可按临时、持久、默认来源过滤。
- 每个设置有三层值:临时、持久、默认。优先级是临时 > 持久 > 默认。徽标标出当前生效的那一层。
- 布尔和枚举使用下拉框,数字使用数字输入,时间、大小等带单位的值直接填写,例如
60s、40mb。临时层与持久层可一次保存。支持清除单层,也可一键清空全部临时设置。 - 日志级别、分片分配属性、断路器等名称不固定的设置,可先添加实例,再填写取值。
操作步骤见集群设置。
数据管理与分析体验
- 数据探索改用 PIT(Point in Time)分页导出,导出数量不再受
max_result_window限制。 - 生命周期策略编辑器可配置的 action 更多,未填写的字段保持原有语义。
- 快照恢复支持直接恢复为可搜索快照,索引列表增加可搜索快照标识。
- 节点页面新增密钥库管理,插件列表支持从文件夹或 ZIP 包手动上传插件。这两项需先在右上角连接 Agent 后使用。
- 创建 API Token 或角色时,索引权限支持下拉选择和搜索。
rate聚合新增sum、value_count计算模式,并支持在包含单一日期源的composite聚合中计算速率。- DevTools 现支持 SQL 关键词高亮、补全和多行语句解析,查询结果默认返回 CSV。
- 生命周期(ILM)策略管理: 对生命周期策略编辑 UI 进行了全面增强,新建与编辑策略现已支持完整的 action 配置,覆盖 Hot、Warm、Cold、Delete 四个阶段
改进优化 (Improvements)
- 重构
_disk_usage同步分析链路,引入有界请求调度和独立线程池,降低并发磁盘用量分析对普通分析请求的影响。 - 重构
_field_usage_stats的 shard 级字段访问采集链路,按每次查询会话对相同字段和访问类型去重,完善 stored fields、term vectors、can-match、refresh/reopen 及主副分片场景的统计覆盖。 - 优化字段使用统计在高并发查询和大字段 registry 场景下的会话提交与快照生成,减少处理开销和临时对象分配。
问题修复 (Bug Fixes)
- 统一重构 Model Provider、Rules 与 Audit Log 的受保护内部索引权限过滤机制,修复直连、通配符、混合索引及数据流后备索引等场景下过滤语义不一致的问题;无权限用户直接访问受保护资源时会被拒绝,在混合或通配符请求中则隐藏相关资源,同时保留远程索引表达式和 Audit Log 的角色授权语义。
- 修复 Remote Reindex 对远端 Elasticsearch REST 协议版本判断不准确的问题,恢复 Elasticsearch 6.8.x、7.x 和 8.x 场景下 scroll 与 clear-scroll 请求的正确格式。
- 修复删除关联多个索引的别名失败的问题。
- 修复授权弹窗打开后「授权提示」页签可能自动消失的问题。
- 修复未授权状态显示为不规范英文的问题,现按界面语言显示「未授权 / Unlicensed」。
- 修复创建用户、角色、管道、模板、远程集群、快照仓库、自动跟随模式、规则库时重名可能覆盖已有配置的问题,现在会提示名称已存在。
- 修复编辑管道时可修改名称导致旧管道残留的问题,编辑时名称改为不可修改。
- 修复删除管道确认弹窗文案误写为「模板」的问题。
- 修复列表页左侧聚合过滤侧边栏输入关键字后无法筛选的问题。
- 修复分片列表点击刷新不重新加载数据的问题。
- 修复热点线程页面选择不支持的 gpu/mem 类型后列表为空且无提示的问题,下拉现仅提供受支持的类型。
- 修复创建角色无法选择粗粒度 action group,以及集群权限与索引权限被强制必填的问题。
- 修复数据探索导出超过 10000 条文档失败的问题。
- 移除生命周期策略编辑器中错误的节点标签缺失实时提醒。
- 修复节点详情插件页显示集群级安装状态的问题:插件只装在部分节点时,未安装的节点也会显示「已安装」;现在按当前节点过滤。
- 修复删除生命周期策略时确认弹窗不显示策略名的问题。
- 修复删除快照确认弹窗误用「策略」且不显示快照名的问题。
- 修复创建生命周期策略时前端重名校验不生效的问题。
升级提示
- 原生 HNSW 的已索引
dense_vector字段只能添加到由 2.4.0 或更高版本创建的索引,且所有数据节点均需升级到 2.4.0 或更高版本;旧索引需新建目标索引后通过 Reindex 迁移。 - 旧 k-NN 插件的
knn_dense_float_vector、knn_sparse_bool_vector和knn_nearest_neighbors接口继续保留,但新旧字段与查询语法不能混用。 - Easysearch 2.4.0 使用未量化的 float HNSW,当前不支持
int8_hnsw等量化向量类型。通过 Elasticsearch 8.19 官方客户端访问时,需在所有节点设置elasticsearch.api_compatibility: true和elasticsearch.api_compatibility_version: "8.19.17",并重启节点。
以上为本版本重点更新摘要,完整变更与技术细节请查看 Easysearch 产品 Release Notes 或联系我们的技术支持团队
获取新版本
INFINI Easysearch v2.4.0 已正式发布,欢迎升级体验:
- 下载地址:https://infinilabs.cn/download/
- 快速开始:https://docs.infinilabs.com/easysearch/main/docs/quick-start/
关于 Easysearch
INFINI Easysearch 是一款分布式搜索引擎,支持结构化和非结构化的数据检索、全文检索、向量检索、空间地理位置信息检索、组合查询、多语种支持、语义分析和聚合分析等多种功能。
Easysearch 基于 Lucene 构建,紧跟 Lucene 最新版本持续迭代更新,采用商用友好协议,企业可自由部署、二次开发和商业化,无协议合规风险。
Easysearch 致力于为企业提供轻量、安全、自主可控的搜索平台,不断完善产品能力,满足更多企业级需求。
【搜索客社区日报】第2274期 (2026-07-27)
社区日报 • Muses 发表了文章 • 0 个评论 • 10178 次浏览 • 2026-09-17 18:59
【搜索客社区日报】第2298期 (2026-09-14)
社区日报 • Muses 发表了文章 • 0 个评论 • 7704 次浏览 • 2026-09-14 07:37
【搜索客社区日报】第2296期 (2026-09-07)
社区日报 • Muses 发表了文章 • 0 个评论 • 10751 次浏览 • 2026-09-07 14:40
Easysearch 原生集成国密算法:打造全链路自主可控搜索底座(一)
Easysearch • INFINI Labs 小助手 发表了文章 • 0 个评论 • 11832 次浏览 • 2026-08-28 19:51
国密算法:藏在手机里的"中国锁"
你有没有想过,每次扫码付款、刷身份证进站、在政务 App 上查社保时,是谁在背后保护你的信息安全?
答案可能比你想象得更"国产"——它叫国密算法。你可以把它理解成一套完全国产自研的"数字锁"。
什么是国密?
"国密"是国家商用密码的简称,由国家密码管理局制定管理。
打个比方:以前咱家装锁,大多是国外品牌,钥匙齿形设计也是人家的专利。万一厂家留了后门,你家大门就等于敞开了。国密算法干的活儿,就是给整个数字社会换上一把完全国产、自主可控的"中国锁"。
这个"锁具家族"成员不少:
SM2:负责数字签名,相当于给数据盖防伪章;
SM3:负责生成"数字指纹",谁改了一个字都能被发现;
SM4:负责把数据搅成乱码,只有对的人才能还原;
SM9:更神奇,直接用手机号或邮箱就能加密。
注:SM = "商密"拼音首字母,不是什么神秘代号 😄
国密到底保护了什么?
手机支付时,SM4 把金额、账号搅成乱码传输,黑客截到也只能干瞪眼。
刷身份证时,SM2 给身份信息盖了个电子防伪章,系统一验便知真假,冒牌货秒露馅。
电子病历流转时,SM3 算出唯一指纹,谁偷偷改了一个诊断结论,系统立刻报警。
连Wi-Fi时,新国标 WAPI 协议用 SM4 建了一条加密隧道,邻居蹭到信号也看不懂你在干嘛。
为什么非要自己的密码体系?
2013 年斯诺登曝光的"棱镜计划"给了全世界一记警钟:美国 NSA 曾在多个国际加密标准中埋后门。这就像你家装了进口智能锁,厂家手里却攥着一把万能钥匙。 一个 14 亿人的国家,金融、电力、通信、政务如果全靠别人的加密技术,风险可想而知。
国密的意义,就是把信息安全的主导权,实实在在地握在自己手里。
国密到底牛在哪?
更安全:SM2 基于椭圆曲线密码学,256 位的安全性相当于 3072 位的RSA,而密钥更短意味着手机运算更快、更省电。
更高效:SM3 的哈希速度比国际主流的 SHA-256 快约 30% ,处理海量数据时优势明显。
自主可控:从数学原理到代码实现全是自己人搞的,每一行逻辑都经得起审查,没有后门。
走向世界:2018 年,SM2/SM3/SM9 正式成为 ISO 国际标准,中国密码技术获得了全球认可。
Easysearch:给搜索引擎也装上"中国锁"
说到这儿你可能要问:国密算法除了在支付、身份证里用,企业后台系统能用吗?
当然能。现在很多国产基础软件已经把国密原生集成进去了,比如国产分布式搜索引擎 Easysearch。
Easysearch 是国产自研的搜索型数据库,主要干数据分析、全文检索、数据洞察的活儿,在不少政企系统里担任"数据管家"。它最大的亮点之一,就是天生带着国密基因。
Easysearch 基于铜锁(Tongsuo)实现了完整的国密 TLS 能力:SM2 为集群节点签发"国密身份证",防止冒名顶替;SM3 负责哈希摘要与签名校验,防篡改、防抵赖;SM4 将节点间通信与 HTTPS 传输全部加密,链路全程国密护航。
更重要的是,Easysearch 兼容 Elasticsearch 的 API,企业原来跑在国外搜索引擎上的业务,可以较低成本切过来,换个国产发动机,锁换成中国锁,车还能照开。这对政务、金融、能源等强监管行业来说,意味着能同时满足信创验收和等保合规的双重要求。
国密离你有多近?
比你以为的要近得多:新发的银行卡芯片、二代/三代身份证、各地的"一网通办"、"粤省事、""浙里办"、国产手机的支付模块、智能网联汽车的通信模块……甚至你查社保时后台跑着的搜索引擎,很可能都已经用上了国密算法。
下次刷身份证、扫码付款、登录政务 App 的时候,不妨想一想:在你看不见的地方,一串中国自主研发的算法正在默默守护着你的隐私。
写在最后
密码技术听起来硬核,但它守护的东西其实很柔软——是你的钱、你的隐私、你的身份,是一个国家数字社会的安全底座。从手机支付里的 SM4,到政务系统里的 SM2 签名,再到 Easysearch 这类国产基础软件的国密原生集成,国密算法的普及不是一句口号,而是像空气一样,无声地渗透进我们生活的每个角落。
下次有人问你"国密是什么",你可以这样回答:
"就是咱们中国自己造的'锁',专门给数字时代的宝贝上锁。现在,连搜索引擎都用上了这把'中国锁'。"
相关阅读
信创生态再扩容|极限科技 Easysearch、Coco AI 等产品与超聚变 FusionOS 26 完成双架构兼容性认证
资讯动态 • INFINI Labs 小助手 发表了文章 • 0 个评论 • 11456 次浏览 • 2026-08-26 19:17
近日,极限数据(北京)科技有限公司(简称:极限科技)与超聚变数字技术股份有限公司(简称:超聚变)完成产品兼容性互认证。极限科技旗下 INFINI Easysearch 搜索引擎软件、INFINI Gateway 极限网关软件、INFINI Console 极限控制台管理系统、Coco AI 智能搜索软件,与超聚变服务器操作系统 FusionOS 26,基于 X86、ARM 双架构完成严格的兼容性测试验证,并形成双方盖章确认的技术认证。
本次认证经过双方联合严格测试,验证结果显示,极限科技四款产品在 FusionOS 26 操作系统环境下功能运行正常、性能表现稳定,可完美适配 X86、ARM 主流国产化硬件架构,能够满足政企、金融、能源、政务等多行业场景下,海量数据检索、数据网关调度、集群运维管理、AI 智能检索等业务落地需求。
作为国产分布式搜索与智能检索领域核心厂商,极限科技打造的 INFINI 系列产品与 Coco AI,是面向海量数据场景的国产化基础软件,可作为 Elasticsearch 的国产化替代方案,广泛应用于日志检索、业务搜索、数据中台、智能问答等场景。超聚变 FusionOS 26 是面向服务器场景的国产企业级操作系统,支持多架构算力,具备高可靠、高性能、安全可信的特性,是信创基础设施中的核心底座之一。
此次全系列产品与超聚变 FusionOS 26 完成双架构适配认证,标志着极限科技产品在国产算力底座上的适配能力进一步完善,丰富了信创软硬件生态组合方案。后续双方将持续深化技术协同与生态合作,联合打造稳定成熟的国产化数据检索与智能应用解决方案,助力各行业数字化、信创化转型落地。
从国产替代到自主创新:极限科技亮相 DTCC 2026,分享 Easysearch 信创实践
Easysearch • INFINI Labs 小助手 发表了文章 • 0 个评论 • 11338 次浏览 • 2026-08-26 16:27
8月20–22日,第17届中国数据库技术大会(DTCC 2026)在北京朗丽兹西山花园酒店举行。本届大会由 IT168 联合 ITPUB 主办,以“融数聚智 创领未来”为主题,汇聚众多数据库领域专家、技术从业者与企业代表,围绕数据库内核、云原生、AI、向量数据库、实时数仓、分布式数据库及行业实践等热点展开深入交流。
在8月21日下午的【向量数据库技术实践】专场,极限科技 CEO 曾勇带来主题分享《从国产替代到自主创新:Easysearch 在搜索引擎领域的信创实践》,从 AI 时代搜索引擎的新定位出发,系统分享搜索引擎国产化面临的关键挑战,以及 Easysearch 在兼容迁移、企业级能力、信创适配、安全容灾和 AI 搜索等方面的实践探索。
一、AI 时代,搜索引擎正在从“工具”走向“基础设施”
过去,搜索引擎主要承担“找到信息”的任务,以关键词匹配、倒排索引、全文检索和 BM25 等技术为核心,服务于企业文档搜索、网站搜索、日志检索和数据查询等场景。
而随着大模型、RAG 和 Agent 快速发展,搜索正在发生新的变化。
从“匹配字面”走向“理解语义”,从“返回结果”走向“辅助决策”,搜索引擎正在成为连接企业数据与 AI 能力的重要基础设施。
在曾勇的分享中,他将这一变化概括为:
从“找信息”走向“用知识”。
如今,企业知识库、智能客服、运维诊断助手、合规审查,以及多模态搜索、Agent 自主搜索等应用,都离不开高质量的检索能力。搜索引擎也因此成为 RAG 和 Agent 获取知识、理解上下文的重要底座。
这也意味着,搜索引擎一旦从普通工具升级为企业 AI 基础设施,其稳定性、安全性以及自主可控能力的重要性将进一步提升。
二、国产替代,不能只是“换一个引擎”
随着信创建设持续深入,国产化正在从基础设施和外围系统逐步进入核心业务与数据基础设施领域。
在曾勇看来,搜索引擎国产化并不是简单完成一次产品替换,而是一项涉及业务连续性、数据迁移、技术自主、安全合规和长期演进能力的系统工程。
因此,在进行搜索引擎国产化选型时,至少需要重点关注五个方面:
- 自主可控:核心引擎和关键技术是否真正掌握在自己手中;
- 企业级稳定性:能否支撑 TB/PB 级数据、高并发和 7×24 小时稳定运行;
- 信创真实适配:能否真正适配国产 CPU、操作系统等基础环境;
- 安全治理能力:权限、审计、加密、脱敏等能力是否能够内建;
- 长期演进能力:能否持续支撑向量检索、AI 搜索、多模态搜索等未来需求。
归根结底,企业选择的并不仅仅是一套搜索软件,而是未来数年持续承载企业数据和 AI 应用的技术底座。
三、从“敢替”到“好用”,Easysearch 持续构建企业级搜索底座
围绕企业国产化过程中最关心的“怎么替、怎么迁、怎么回退、谁来服务、如何运维”等问题,极限科技持续围绕 Easysearch 完善从搜索引擎内核到企业级平台的完整能力体系。
作为企业级分布式搜索型数据库,Easysearch 支持非结构化数据检索、全文检索、向量检索、地理位置查询、组合索引查询、多语种搜索和聚合分析,并提供企业级安全与管理能力。
1. 兼容生态,让迁移更平滑
对于已经大规模使用 Elasticsearch 的企业而言,迁移成本往往是国产替代过程中最现实的问题之一。
针对这一挑战,Easysearch 持续强化兼容能力,覆盖 REST API、Java/Python/Go/Node.js SDK、Query DSL,以及 ES 6.x/7.x/8.x 数据读写,并兼容 Kibana、Logstash、Beats、Filebeat 等常见生态工具。同时针对龙芯、鲲鹏、飞腾以及麒麟、统信 UOS 等国产软硬件环境开展适配。
这意味着企业在推进国产化时,可以尽可能复用现有应用、技术栈和运维经验,降低迁移改造成本。
2. 企业级能力,让国产搜索真正“好用”
国产化的终点并不是“能够运行”,而是能够真正支撑企业核心生产业务。
Easysearch 从内核层面持续补齐企业级能力,包括 TLS 加密、RBAC/ABAC 权限控制、字段级脱敏、LDAP/AD 认证、IP 黑白名单、防暴力破解、磁盘及快照加密、限流限速、审计日志、文档级权限以及国密算法等能力。
在安全与容灾方面,Easysearch 支持 SM2、SM3、SM4 国密算法,并提供全量/增量 Snapshot 备份、备份文件加密、跨集群复制以及跨机房部署等能力,为金融、政务等高安全、高可靠场景提供基础支撑。
四、从全文检索到向量检索,为 AI 应用打好搜索底座
AI 时代,搜索引擎需要解决的不再只是“关键词能不能搜到”,还需要理解数据背后的语义。
Easysearch 已将全文检索、向量检索与混合搜索能力统一在同一引擎中,支持 kNN 向量检索、HNSW/LSH 等向量索引方式,并支持 BM25 全文检索与向量相似度的双路召回和融合排序。
通过统一搜索引擎承载全文、向量和混合检索,可以减少企业额外部署独立向量数据库带来的架构复杂度与运维成本,并进一步支撑语义搜索、RAG、Agent 长期记忆、企业知识库和多模态检索等场景。
这也是 Easysearch 从传统搜索基础设施向 AI Search Infra 演进的重要一步。
五、立足自主研发,持续深耕搜索基础设施创新
本次 DTCC 2026 的技术分享,是极限科技对国产搜索信创实践的一次集中输出。未来,极限科技将继续坚持自主创新路线,以 Easysearch 为基础,进一步完善企业级搜索、向量检索、AI 搜索和自主可控能力,推动搜索基础设施从“国产替代”走向“自主创新”,为企业数智化与 AI 应用发展构建更加安全、稳定、开放、可持续的搜索技术底座。
CDC、查询卸载与 AI 检索:达梦 × Easysearch 技术交流干货回顾
Easysearch • INFINI Labs 小助手 发表了文章 • 0 个评论 • 10014 次浏览 • 2026-08-14 11:14
在金融行业数字化转型与信创建设持续推进的背景下,如何让国产数据库更好地支撑海量数据检索、实时分析与智能应用,成为越来越多企业关注的话题。
8 月 7 日,围绕 “达梦数据库 × Easysearch 金融行业搜索与分析加速方案”,我们开展了一场技术主题分享与交流活动。 由 极限科技技术专家杨帆 从金融行业实际业务需求出发,深入介绍了达梦数据库与 Easysearch 的协同架构,并围绕数据同步、查询卸载、性能优化以及国产化生态合作等问题,与参会伙伴展开了深入交流。
本次分享的核心方案,是通过 “达梦数据库 + CDC 实时同步 + Easysearch” 构建事务与检索分析分离的架构:达梦继续承担核心事务处理和主数据管理,Easysearch 则承接全文搜索、海量数据检索、多维分析以及 AI 检索等场景,让两套系统各司其职,共同提升数据服务能力。
一、为什么需要“数据库 + 搜索引擎”?
传统关系型数据库在 OLTP 场景下具有强一致性、事务处理和数据管理等优势,但当业务逐渐面临海量数据全文检索、多维聚合分析以及复杂搜索体验等需求时,单纯依赖数据库往往会面临新的挑战。
例如在金融场景中,交易明细、合同与制度文件、客户信息、日志数据等都需要被快速检索;与此同时,大量报表、聚合分析和历史数据查询又可能与核心交易业务争抢 CPU、IO 等资源。
分享中提到,达梦擅长 OLTP 事务处理、强一致性、数据安全与审计等能力,而在全文检索、相关性排序以及海量检索分析等方面,则可以通过 Easysearch 进行能力补充。
因此,方案的核心思路并不是简单地“用 Easysearch 替换数据库”,而是:
让数据库专注事务,让搜索引擎专注搜索与分析。
达梦负责写入、更新、事务一致性以及主数据管理;Easysearch 则负责从海量数据中快速“找出来、关联起来”,承接搜索、聚合、向量检索及 AI 等查询型负载。
二、CDC:连接事务库与检索分析库的关键纽带
在这样的架构中,如何让达梦中的数据及时同步到 Easysearch,是大家非常关注的问题。
本次方案采用 CDC 实时同步 的方式,整体链路包括三个阶段:
全量同步 → 增量同步 → 持续运行
首先将达梦存量数据同步至 Easysearch,建立数据基线;随后通过 CDC 持续捕获 INSERT、UPDATE、DELETE 等数据变化,并实时同步到 Easysearch,最终形成持续运行的数据同步链路。
在分享介绍的测试验证中,达梦 DM8 × Easysearch 已完成兼容认证测试,全量同步和增量同步均验证通过;在 CDC 高压同步测试中,万级变更可在 30 秒内完成同步,并实现读写一致、无积压。
三、现场技术交流:从“方案介绍”走向“实际问题”
相比单向的技术分享,本次活动更加精彩的部分,是分享结束后的互动交流。
围绕方案在真实生产环境中的落地,参会伙伴提出了多个非常有针对性的问题,分享老师也结合方案设计和实际经验进行了逐一解答。
1. CDC 延迟一般是多少?
CDC 是整个架构实现近实时数据同步的关键,因此大家首先关注了:
从达梦发生数据变更,到 Easysearch 可以查询到数据,中间通常存在多大的延迟?
这个问题实际上不仅涉及 CDC 本身,还与源端产生变更的速度、网络、同步任务处理能力以及目标端写入性能等多个因素相关。
在常规业务负载下,CDC 增量同步延迟可控制在秒级;如果业务变更量更高,可通过 Easysearch 动态扩容分片、增加 CDC 同步并发等方式进一步降低延迟,满足金融级近实时数据一致性要求。
2. 哪些查询适合留在达梦?哪些查询适合放到 Easysearch?
这是现场非常有代表性的一个问题。
实际上,“哪些数据进入 Easysearch”并不是简单按照表来划分,而更应该按照 业务访问模式和查询类型 来判断。
例如:
- 强事务、强一致性的核心业务操作,继续留在达梦;
- 精确查询、事务处理以及主数据维护,继续由达梦负责;
- 全文搜索、模糊查询、相关性排序等场景,可以交给 Easysearch;
- 海量数据检索、多维聚合分析、历史数据查询等,可以通过 Easysearch 进行查询卸载;
- 面向 AI 的向量检索、混合检索和 RAG 等场景,则可以进一步利用 Easysearch 的搜索能力。
这种“按负载类型进行职责分工”的方式,也是整个方案设计的核心。
3. 从搜索到分析:Easysearch 还能解决什么?
除了传统的全文检索,本次分享还介绍了 Easysearch 在海量数据分析、向量检索以及 AI 场景中的应用。
在全文搜索方面,Easysearch 支持 IK、拼音、HanLP 等中文分词能力,并提供 BM25 相关性评分、Function Score、高亮、同义词、搜索建议等能力。
在海量数据分析方面,则可以通过倒排索引、列式 Doc Values 以及聚合能力,承接交易明细分析、日志检索、客户行为分析以及风控等场景。
而在 AI 场景中,Easysearch 还可以进一步提供向量检索和全文检索融合能力,为 RAG、语义搜索、智能客服、推荐以及反欺诈等应用提供检索底座。
这意味着,数据库中的结构化数据经过同步之后,并不只是多了一个“搜索入口”,而是可以进一步形成 搜索、分析与 AI 多种数据服务能力。
4. 在国产数据库信创领域,达梦与 Easysearch 有哪些合作空间?
二者都是信创全栈适配的国产自主产品,合作空间非常广阔:
首先是联合解决方案落地:面向金融、运营商、政企等行业,提供“事务库 + 检索分析库”的信创标准架构,满足等保、密评要求,规避开源组件协议风险;
其次是国产化替代场景:Easysearch 可作为 Elasticsearch 的平滑替代产品,与达梦组合形成“去 IOE + 去开源 Elastic ”的全栈信创方案,目前已在中国移动、中国一汽等标杆项目中验证;
此外还有AI场景拓展:二者结合可支撑金融 RAG 知识库、智能风控、语义合规审查等 AI 应用,为信创环境下的智能化转型提供底座。
四、一次分享,也是一次技术碰撞
从达梦数据库到 Easysearch,从 CDC 到查询卸载,再到全文搜索、海量分析和 AI 检索,本次交流虽然围绕的是一个具体的技术方案,但大家讨论的其实是一个更加普遍的问题:
在信创和数字化转型背景下,如何让不同类型的数据基础设施发挥各自的优势,并最终服务于业务?
达梦与 Easysearch 的组合,并不是简单的“1+1”,而是通过职责分离,让事务处理、数据管理、搜索、分析和 AI 各自发挥所长。
技术分享有终点,技术交流没有终点。
感谢分享嘉宾的精彩内容,也感谢每一位参会伙伴的积极参与和深度交流。
期待下一次,我们继续围绕 搜索、数据库、数据分析、AI 与信创技术,碰撞出更多新的思路与实践。
达梦 × Easysearch,探索国产数据基础设施协同的新可能。
参考资源:
- PPT 下载:https://searchkit.cn/slides/347
- 达梦官网:https://dameng.com
- Easysearch 官网:https://easysearch.cn
INFINI Easysearch 向量搜索实战(二)
向量搜索 • INFINI Labs 小助手 发表了文章 • 0 个评论 • 10190 次浏览 • 2026-08-09 12:39
上回 我们通过 Ingest Pipeline 把数据在写入 Easysearch 的过程中自动转换成了向量,这次我们通过 Search Pipeline 实现查询时将查询内容转换成向量并进行查询。
Embedding 服务
这里要保持与写入时使用的模型一致。
实战
我们实战演示分为以下几个步骤:
- 建立 Search Pipeline
- 设置索引默认 Pipeline
- 数据查询
建立 Search Pipeline
PUT /_search/pipeline/default_model_pipeline
{
  "rewrite_processors": [
    {
      "semantic_query_enricher" : {
        "description": "Sets the default embedding model",
        "url": "https://dashscope.aliyuncs.com/compatible-mode/v1/embeddings",
        "vendor": "openai",
        "api_key": "<api_key>",
        "default_model_id": "text-embedding-v4",
        "vector_field_model_id": {
           "text_vector": "text-embedding-v4"
        }
      }
    }
  ]
}
设置索引默认 Pipeline
为了方便查询,不用每次查询都指定 Pipeline,我们设置默认值。
PUT /my-index/_settings
{
  "index.search.default_pipeline" : "default_model_pipeline"
}
数据查询
使用上次写入的数据进行查询测试,但不直接查询原来的文本内容。
GET /my-index/_search
{
  "_source": "input_text",
  "query": {
    "semantic": {
      "text_vector": {
        "query_text": "非常先进高级的生产车间",
        "candidates": 100,
        "query_strategy": "LSH_COSINE"
      }
    }
  }
}参数解释请查看文档。
OK,从上面可以看到,我们没有直接搜索原文本中的内容或关键字,但还是通过文本的语义检索到了相关内容。
关于 Easysearch
INFINI Easysearch 是一款分布式搜索引擎,支持结构化和非结构化的数据检索、全文检索、向量检索、空间地理位置信息检索、组合查询、多语种支持、语义分析和聚合分析等多种功能。
Easysearch 基于 Lucene 构建,紧跟 Lucene 最新版本持续迭代更新,采用商用友好协议,企业可自由部署、二次开发和商业化,无协议合规风险。
Easysearch 致力于为企业提供轻量、安全、自主可控的搜索平台,不断完善产品能力,满足更多企业级需求。
相关文章:


