


向量搜索
Easysearch 2.4.0 发布:原生 HNSW 与混合检索,管理体验全面升级
资讯动态 • INFINI Labs 小助手 发表了文章 • 0 个评论 • 31 次浏览 • 3 小时前

INFINI Easysearch 2.4.0 正式发布。本版本将向量搜索纳入内核:基于 Lucene 的原生 HNSW,关键词与语义向量可混合检索。控制台新增可视化 Mapping 编辑器,集群设置可同时查看临时、持久、默认三层配置。生命周期策略、可搜索快照、密钥库与插件管理同步更新,高并发下的字段使用统计和磁盘用量分析也更稳定。
主要更新如下:
功能特性 (Features)
原生 HNSW 向量搜索与混合检索
- 内置基于 Lucene 的 HNSW 向量索引。新建索引可直接使用
dense_vector、query-levelknn和顶层knn,无需安装 k-NN 插件。 - 支持 1~4096 维
float向量,以及cosine、dot_product、l2_norm、max_inner_product四种相似度算法。 - 支持通过
m、ef_construction和num_candidates调整索引构建与查询效果;省略index_options时默认使用hnsw(m=16, ef_construction=100)。 - 支持一个顶层关键词
query与一个顶层knn并列执行,通过结果并集与加权评分实现关键词、语义向量的混合召回。 - 兼容 Elasticsearch 8.19.17 的 float HNSW mapping、Bulk、kNN 查询和 wire 行为,以及 Elasticsearch Java 8.19.17、Python 8.19.3 官方客户端,现有应用可直接对接。
更多用法及兼容边界请参阅原生 HNSW 搜索文档。
可视化 Mapping 编辑器
新增索引页提供可视化 Mapping 编辑器。字段按层级排列成树,可直接编辑类型和参数,无需手写 Mapping JSON。

- 可以从索引模板或已有索引导入配置。创建索引时,也可以关联集群里已有的别名。
- 覆盖全部字段类型。支持多字段,也可为
object/nested添加子字段,同类型字段可批量添加。 - 可视化编辑与 JSON 编辑可随时切换,内容保持同步。
dynamic_templates、_source、_meta等高级内容在切换后仍会保留。
操作步骤见新增索引。
集群设置页
在「设置」中打开集群设置页,查看和修改 _cluster/settings 中的动态配置。页面按节点、索引、分片、断路器、生命周期分组,支持按名称或 key 搜索,也可按临时、持久、默认来源过滤。

- 每个设置有三层值:临时、持久、默认。优先级是临时 > 持久 > 默认。徽标标出当前生效的那一层。
- 布尔和枚举使用下拉框,数字使用数字输入,时间、大小等带单位的值直接填写,例如
60s、40mb。临时层与持久层可一次保存。支持清除单层,也可一键清空全部临时设置。 - 日志级别、分片分配属性、断路器等名称不固定的设置,可先添加实例,再填写取值。

操作步骤见集群设置。
数据管理与分析体验
- 数据探索改用 PIT(Point in Time)分页导出,导出数量不再受
max_result_window限制。 - 生命周期策略编辑器可配置的 action 更多,未填写的字段保持原有语义。
- 快照恢复支持直接恢复为可搜索快照,索引列表增加可搜索快照标识。
- 节点页面新增密钥库管理,插件列表支持从文件夹或 ZIP 包手动上传插件。这两项需先在右上角连接 Agent 后使用。
- 创建 API Token 或角色时,索引权限支持下拉选择和搜索。
rate聚合新增sum、value_count计算模式,并支持在包含单一日期源的composite聚合中计算速率。- DevTools 现支持 SQL 关键词高亮、补全和多行语句解析,查询结果默认返回 CSV。
- 生命周期(ILM)策略管理: 对生命周期策略编辑 UI 进行了全面增强,新建与编辑策略现已支持完整的 action 配置,覆盖 Hot、Warm、Cold、Delete 四个阶段
改进优化 (Improvements)
- 重构
_disk_usage同步分析链路,引入有界请求调度和独立线程池,降低并发磁盘用量分析对普通分析请求的影响。 - 重构
_field_usage_stats的 shard 级字段访问采集链路,按每次查询会话对相同字段和访问类型去重,完善 stored fields、term vectors、can-match、refresh/reopen 及主副分片场景的统计覆盖。 - 优化字段使用统计在高并发查询和大字段 registry 场景下的会话提交与快照生成,减少处理开销和临时对象分配。
问题修复 (Bug Fixes)
- 统一重构 Model Provider、Rules 与 Audit Log 的受保护内部索引权限过滤机制,修复直连、通配符、混合索引及数据流后备索引等场景下过滤语义不一致的问题;无权限用户直接访问受保护资源时会被拒绝,在混合或通配符请求中则隐藏相关资源,同时保留远程索引表达式和 Audit Log 的角色授权语义。
- 修复 Remote Reindex 对远端 Elasticsearch REST 协议版本判断不准确的问题,恢复 Elasticsearch 6.8.x、7.x 和 8.x 场景下 scroll 与 clear-scroll 请求的正确格式。
- 修复删除关联多个索引的别名失败的问题。
- 修复授权弹窗打开后「授权提示」页签可能自动消失的问题。
- 修复未授权状态显示为不规范英文的问题,现按界面语言显示「未授权 / Unlicensed」。
- 修复创建用户、角色、管道、模板、远程集群、快照仓库、自动跟随模式、规则库时重名可能覆盖已有配置的问题,现在会提示名称已存在。
- 修复编辑管道时可修改名称导致旧管道残留的问题,编辑时名称改为不可修改。
- 修复删除管道确认弹窗文案误写为「模板」的问题。
- 修复列表页左侧聚合过滤侧边栏输入关键字后无法筛选的问题。
- 修复分片列表点击刷新不重新加载数据的问题。
- 修复热点线程页面选择不支持的 gpu/mem 类型后列表为空且无提示的问题,下拉现仅提供受支持的类型。
- 修复创建角色无法选择粗粒度 action group,以及集群权限与索引权限被强制必填的问题。
- 修复数据探索导出超过 10000 条文档失败的问题。
- 移除生命周期策略编辑器中错误的节点标签缺失实时提醒。
- 修复节点详情插件页显示集群级安装状态的问题:插件只装在部分节点时,未安装的节点也会显示「已安装」;现在按当前节点过滤。
- 修复删除生命周期策略时确认弹窗不显示策略名的问题。
- 修复删除快照确认弹窗误用「策略」且不显示快照名的问题。
- 修复创建生命周期策略时前端重名校验不生效的问题。
升级提示
- 原生 HNSW 的已索引
dense_vector字段只能添加到由 2.4.0 或更高版本创建的索引,且所有数据节点均需升级到 2.4.0 或更高版本;旧索引需新建目标索引后通过 Reindex 迁移。 - 旧 k-NN 插件的
knn_dense_float_vector、knn_sparse_bool_vector和knn_nearest_neighbors接口继续保留,但新旧字段与查询语法不能混用。 - Easysearch 2.4.0 使用未量化的 float HNSW,当前不支持
int8_hnsw等量化向量类型。通过 Elasticsearch 8.19 官方客户端访问时,需在所有节点设置elasticsearch.api_compatibility: true和elasticsearch.api_compatibility_version: "8.19.17",并重启节点。
以上为本版本重点更新摘要,完整变更与技术细节请查看 Easysearch 产品 Release Notes 或联系我们的技术支持团队
获取新版本
INFINI Easysearch v2.4.0 已正式发布,欢迎升级体验:
- 下载地址:https://infinilabs.cn/download/
- 快速开始:https://docs.infinilabs.com/easysearch/main/docs/quick-start/
关于 Easysearch

INFINI Easysearch 是一款分布式搜索引擎,支持结构化和非结构化的数据检索、全文检索、向量检索、空间地理位置信息检索、组合查询、多语种支持、语义分析和聚合分析等多种功能。
Easysearch 基于 Lucene 构建,紧跟 Lucene 最新版本持续迭代更新,采用商用友好协议,企业可自由部署、二次开发和商业化,无协议合规风险。
Easysearch 致力于为企业提供轻量、安全、自主可控的搜索平台,不断完善产品能力,满足更多企业级需求。


【搜索客社区日报】第2274期 (2026-07-27)
社区日报 • Muses 发表了文章 • 0 个评论 • 1543 次浏览 • 3 天前
【搜索客社区日报】第2296期 (2026-09-07)
社区日报 • Muses 发表了文章 • 0 个评论 • 6480 次浏览 • 2026-09-07 14:40
INFINI Easysearch 向量搜索实战(二)
向量搜索 • INFINI Labs 小助手 发表了文章 • 0 个评论 • 10043 次浏览 • 2026-08-09 12:39

上回 我们通过 Ingest Pipeline 把数据在写入 Easysearch 的过程中自动转换成了向量,这次我们通过 Search Pipeline 实现查询时将查询内容转换成向量并进行查询。
Embedding 服务
这里要保持与写入时使用的模型一致。
实战
我们实战演示分为以下几个步骤:
- 建立 Search Pipeline
- 设置索引默认 Pipeline
- 数据查询
建立 Search Pipeline
PUT /_search/pipeline/default_model_pipeline
{
  "rewrite_processors": [
    {
      "semantic_query_enricher" : {
        "description": "Sets the default embedding model",
        "url": "https://dashscope.aliyuncs.com/compatible-mode/v1/embeddings",
        "vendor": "openai",
        "api_key": "<api_key>",
        "default_model_id": "text-embedding-v4",
        "vector_field_model_id": {
           "text_vector": "text-embedding-v4"
        }
      }
    }
  ]
}
设置索引默认 Pipeline
为了方便查询,不用每次查询都指定 Pipeline,我们设置默认值。
PUT /my-index/_settings
{
  "index.search.default_pipeline" : "default_model_pipeline"
}
数据查询
使用上次写入的数据进行查询测试,但不直接查询原来的文本内容。
GET /my-index/_search
{
  "_source": "input_text",
  "query": {
    "semantic": {
      "text_vector": {
        "query_text": "非常先进高级的生产车间",
        "candidates": 100,
        "query_strategy": "LSH_COSINE"
      }
    }
  }
}参数解释请查看文档。

OK,从上面可以看到,我们没有直接搜索原文本中的内容或关键字,但还是通过文本的语义检索到了相关内容。
关于 Easysearch
INFINI Easysearch 是一款分布式搜索引擎,支持结构化和非结构化的数据检索、全文检索、向量检索、空间地理位置信息检索、组合查询、多语种支持、语义分析和聚合分析等多种功能。
Easysearch 基于 Lucene 构建,紧跟 Lucene 最新版本持续迭代更新,采用商用友好协议,企业可自由部署、二次开发和商业化,无协议合规风险。
Easysearch 致力于为企业提供轻量、安全、自主可控的搜索平台,不断完善产品能力,满足更多企业级需求。
相关文章:
INFINI Easysearch 向量搜索实战(一)
向量搜索 • INFINI Labs 小助手 发表了文章 • 0 个评论 • 9486 次浏览 • 2026-08-09 12:35
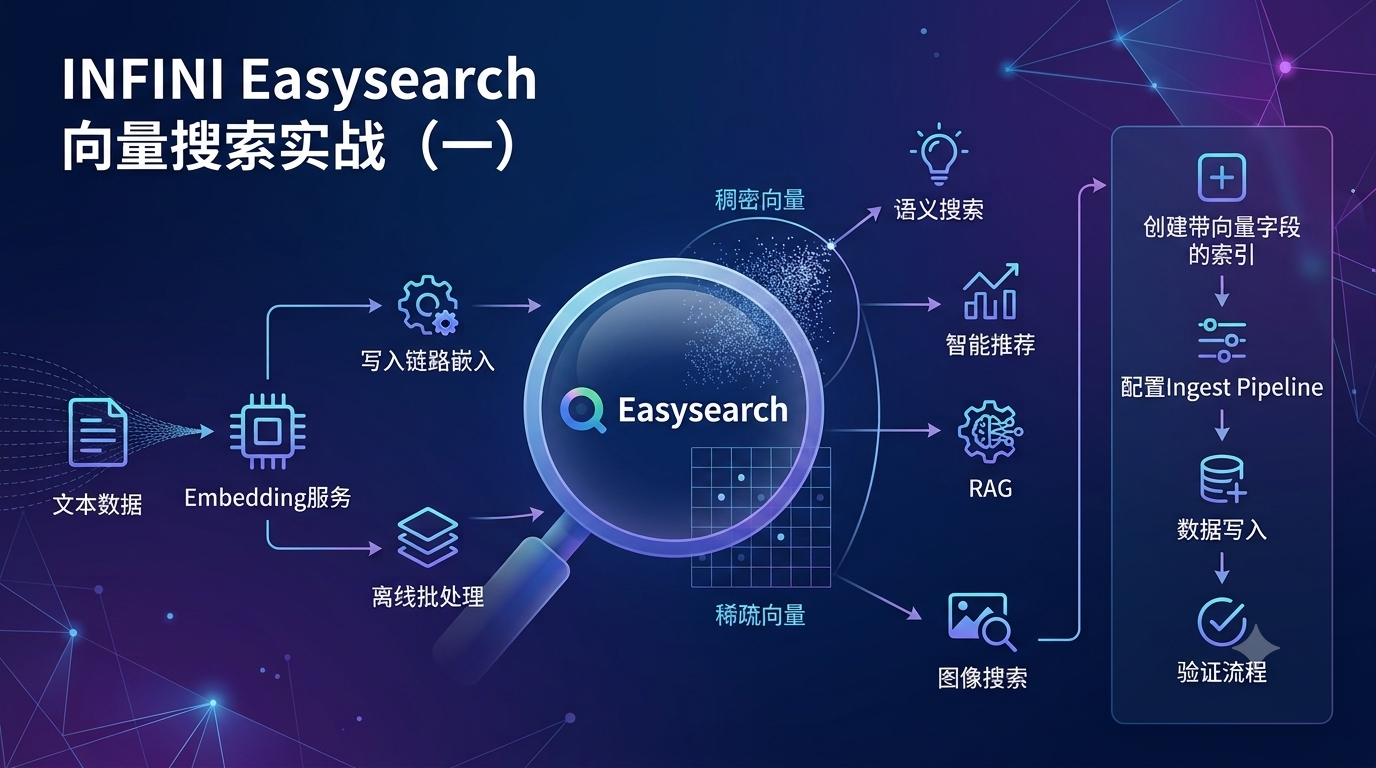
Easysearch 提供了强大的向量搜索能力,打破传统关键词匹配的局限,实现真正的“懂你”的语义搜索。助力企业快速构建智能推荐、图像识别和内容理解等 AI 应用,释放数据深层价值。
核心能力
| 能力 | 说明 |
|---|---|
| 两种向量类型 | 稠密浮点向量(knn_dense_float_vector)和稀疏布尔向量(knn_sparse_bool_vector) |
| 多种索引模型 | lsh(局部敏感哈希,近似搜索)、permutation_lsh(置换 LSH)、sparse_indexed(倒排索引)、exact(精确搜索) |
| 多种相似度 | cosine(余弦)、l1(曼哈顿距离)、l2(欧氏距离)、jaccard、hamming |
| 与全文搜索融合 | 向量字段与文本字段存储在同一索引,支持 Hybrid 混合检索 |
| function_score 集成 | 向量相似度可作为 function_score 的评分函数 |
典型应用场景
- 语义搜索:文本通过 Embedding 模型转为向量,按语义相似度检索
- RAG 检索增强生成:为大语言模型提供知识库检索能力
- 推荐系统:用户/商品特征向量的相似推荐
- 图像/多模态搜索:图像特征向量的相似检索
- 去重与异常检测:通过向量距离判断内容相似度
Embedding 服务
在使用向量搜索前,先要准备一个 Embedding 模型,支持与 OpenAI API 兼容的 embedding 接口和 Ollama embedding 接口。本文使用阿里云上的 Embedding 模型进行演示。
写入方法
方法一:写入链路嵌入(推荐)
在数据写入 Easysearch 时,通过 Ingest Pipeline 自动调用 Embedding 服务:
应用写数据 → Easysearch → Ingest Pipeline → 调用 Embedding API → 写入向量字段
优势是写入后即可搜索,无需维护外部向量化流程。需要确保集群应至少有一个节点拥有 ingest 角色。
方法二:离线批处理
在应用侧完成向量化,再将向量字段直接写入 Easysearch:
原始数据 → 应用 → 调用模型 Embedding API → 写入 Easysearch(含向量字段)
参考文档。
实战
我们实战演示模式一,分为以下几个步骤:
- 建立带有向量字段的索引
- 创建对应的 Ingest Pipeline
- 写入数据到索引
1. 建立带有向量字段的索引
先建立一个带向量字段的索引,注意 dims 要与向量模型的输出匹配。
PUT /my-index
{
  "mappings": {
    "properties": {
      "text_vector": {
        "type": "knn_dense_float_vector",
        "knn": {
          "dims": 1024,
          "model": "lsh",
          "similarity": "cosine",
          "L": 99,
          "k": 1
        }
      }
    }
  }
}
2. 创建对应的 Ingest Pipeline
写入数据前先建立 Ingest Pipeline,注意 vendor 必须根据使用的模型来指定,比如本文使用的是阿里云 text-embedding-v4 模型,该模型提供了 OpenAI 格式的 API 接口,这里 vendor 我们就写 openai。
PUT _ingest/pipeline/text-embedding-pipeline
{
  "description": "用于生成文本嵌入向量的管道",
  "processors": [
    {
      "text_embedding": {
        "url": "https://dashscope.aliyuncs.com/compatible-mode/v1/embeddings",
        "vendor": "openai",
        "api_key": "xxxxxx",
        "text_field": "input_text",
        "vector_field": "text_vector",
        "model_id": "text-embedding-v4",
        "dims": 1024,
        "ignore_missing": false,
        "ignore_failure": false
      }
    }
  ]
}
text_field:指定原始文本字段,Pipeline 会将该字段的内容转换成向量。
vector_field:指定向量存储的字段,保存上面转换的向量。
3. 写入数据
POST /_bulk?pipeline=text-embedding-pipeline&pretty
{"index": {"_index": "my-index", "_id": "1"}}
{"input_text": "苹果发布了新款iPhone 15 Pro手机,搭载A17芯片"}
{"index": {"_index": "my-index", "_id": "2"}}
{"input_text": "特斯拉宣布将在上海建第二座超级工厂"}
{"index": {"_index": "my-index", "_id": "3"}}
{"input_text": "今天天气真好,阳光明媚适合去公园散步"}
{"index": {"_index": "my-index", "_id": "4"}}
{"input_text": "程序员用Python写了一个自动化数据清洗脚本"}
{"index": {"_index": "my-index", "_id": "5"}}
{"input_text": "故宫博物院推出了夏季特展,展出珍贵文物"}
{"index": {"_index": "my-index", "_id": "6"}}
{"input_text": "小明每天坚持跑步五公里,身体越来越健康"}
{"index": {"_index": "my-index", "_id": "7"}}
{"input_text": "人工智能大模型在自然语言处理领域取得突破"}
{"index": {"_index": "my-index", "_id": "8"}}
{"input_text": "这家咖啡店的拿铁口感丝滑,推荐给咖啡爱好者"}
{"index": {"_index": "my-index", "_id": "9"}}
{"input_text": "量子计算机有望在药物研发中发挥重要作用"}
{"index": {"_index": "my-index", "_id": "10"}}
{"input_text": "周末和朋友一起去爬山,山顶的风景美极了"}
4. 检查数据
搜索索引数据,看看是否成功转换成了向量。可以看到原始数据保存在 input_text 字段中,其向量保存到了 text_vector。

OK,下一步我们看看怎么方便地实现向量搜索。
关于 Easysearch
INFINI Easysearch 是一款分布式搜索引擎,支持结构化和非结构化的数据检索、全文检索、向量检索、空间地理位置信息检索、组合查询、多语种支持、语义分析和聚合分析等多种功能。
Easysearch 基于 Lucene 构建,紧跟 Lucene 最新版本持续迭代更新,采用商用友好协议,企业可自由部署、二次开发和商业化,无协议合规风险。
Easysearch 致力于为企业提供轻量、安全、自主可控的搜索平台,不断完善产品能力,满足更多企业级需求。
相关文章:
INFINI Easysearch 向量搜索实战(一)
Easysearch • INFINI Labs 小助手 发表了文章 • 0 个评论 • 14003 次浏览 • 2026-07-18 19:38
Easysearch 提供了强大的向量搜索能力,打破传统关键词匹配的局限,实现真正的“懂你”的语义搜索。助力企业快速构建智能推荐、图像识别和内容理解等 AI 应用,释放数据深层价值。
核心能力
| 能力 | 说明 |
|---|---|
| 两种向量类型 | 稠密浮点向量(knn_dense_float_vector)和稀疏布尔向量(knn_sparse_bool_vector) |
| 多种索引模型 | lsh(局部敏感哈希,近似搜索)、permutation_lsh(置换 LSH)、sparse_indexed(倒排索引)、exact(精确搜索) |
| 多种相似度 | cosine(余弦)、l1(曼哈顿距离)、l2(欧氏距离)、jaccard、hamming |
| 与全文搜索融合 | 向量字段与文本字段存储在同一索引,支持 Hybrid 混合检索 |
| function_score 集成 | 向量相似度可作为 function_score 的评分函数 |
典型应用场景
- 语义搜索:文本通过 Embedding 模型转为向量,按语义相似度检索
- RAG 检索增强生成:为大语言模型提供知识库检索能力
- 推荐系统:用户/商品特征向量的相似推荐
- 图像/多模态搜索:图像特征向量的相似检索
- 去重与异常检测:通过向量距离判断内容相似度
Embedding 服务
在使用向量搜索前,先要准备一个 Embedding 模型,支持与 OpenAI API 兼容的 embedding 接口和 Ollama embedding 接口。本文使用阿里云上的 Embedding 模型进行演示。
写入方法
方法一:写入链路嵌入(推荐)
在数据写入 Easysearch 时,通过 Ingest Pipeline 自动调用 Embedding 服务:
应用写数据 → Easysearch → Ingest Pipeline → 调用 Embedding API → 写入向量字段
优势是写入后即可搜索,无需维护外部向量化流程。需要确保集群应至少有一个节点拥有 ingest 角色。
方法二:离线批处理
在应用侧完成向量化,再将向量字段直接写入 Easysearch:
原始数据 → 应用 → 调用模型 Embedding API → 写入 Easysearch(含向量字段)
参考文档。
实战
我们实战演示模式一,分为以下几个步骤:
- 建立带有向量字段的索引
- 创建对应的 Ingest Pipeline
- 写入数据到索引
1. 建立带有向量字段的索引
先建立一个带向量字段的索引,注意 dims 要与向量模型的输出匹配。
PUT /my-index
{
  "mappings": {
    "properties": {
      "text_vector": {
        "type": "knn_dense_float_vector",
        "knn": {
          "dims": 1024,
          "model": "lsh",
          "similarity": "cosine",
          "L": 99,
          "k": 1
        }
      }
    }
  }
}
2. 创建对应的 Ingest Pipeline
写入数据前先建立 Ingest Pipeline,注意 vendor 必须根据使用的模型来指定,比如本文使用的是阿里云 text-embedding-v4 模型,该模型提供了 OpenAI 格式的 API 接口,这里 vendor 我们就写 openai。
PUT _ingest/pipeline/text-embedding-pipeline
{
  "description": "用于生成文本嵌入向量的管道",
  "processors": [
    {
      "text_embedding": {
        "url": "https://dashscope.aliyuncs.com/compatible-mode/v1/embeddings",
        "vendor": "openai",
        "api_key": "xxxxxx",
        "text_field": "input_text",
        "vector_field": "text_vector",
        "model_id": "text-embedding-v4",
        "dims": 1024,
        "ignore_missing": false,
        "ignore_failure": false
      }
    }
  ]
}
text_field:指定原始文本字段,Pipeline 会将该字段的内容转换成向量。
vector_field:指定向量存储的字段,保存上面转换的向量。
3. 写入数据
POST /_bulk?pipeline=text-embedding-pipeline&pretty
{"index": {"_index": "my-index", "_id": "1"}}
{"input_text": "苹果发布了新款iPhone 15 Pro手机,搭载A17芯片"}
{"index": {"_index": "my-index", "_id": "2"}}
{"input_text": "特斯拉宣布将在上海建第二座超级工厂"}
{"index": {"_index": "my-index", "_id": "3"}}
{"input_text": "今天天气真好,阳光明媚适合去公园散步"}
{"index": {"_index": "my-index", "_id": "4"}}
{"input_text": "程序员用Python写了一个自动化数据清洗脚本"}
{"index": {"_index": "my-index", "_id": "5"}}
{"input_text": "故宫博物院推出了夏季特展,展出珍贵文物"}
{"index": {"_index": "my-index", "_id": "6"}}
{"input_text": "小明每天坚持跑步五公里,身体越来越健康"}
{"index": {"_index": "my-index", "_id": "7"}}
{"input_text": "人工智能大模型在自然语言处理领域取得突破"}
{"index": {"_index": "my-index", "_id": "8"}}
{"input_text": "这家咖啡店的拿铁口感丝滑,推荐给咖啡爱好者"}
{"index": {"_index": "my-index", "_id": "9"}}
{"input_text": "量子计算机有望在药物研发中发挥重要作用"}
{"index": {"_index": "my-index", "_id": "10"}}
{"input_text": "周末和朋友一起去爬山,山顶的风景美极了"}
4. 检查数据
搜索索引数据,看看是否成功转换成了向量。可以看到原始数据保存在 input_text 字段中,其向量保存到了 text_vector。
OK,下一步我们看看怎么方便地实现向量搜索。
关于 Easysearch
INFINI Easysearch 是一个分布式的搜索型数据库,实现非结构化数据检索、全文检索、向量检索、地理位置信息查询、组合索引查询、多语种支持、聚合分析等。Easysearch 可以完美替代 Elasticsearch,同时添加和完善多项企业级功能。Easysearch 助您拥有简洁、高效、易用的搜索体验。
官网文档:https://docs.infinilabs.com/easysearch
相关文章:

【搜索客社区日报】第1838期 (2024-06-14)
社区日报 • Fred2000 发表了文章 • 0 个评论 • 3327 次浏览 • 2024-06-14 09:18
Easysearch 2.4.0 发布:原生 HNSW 与混合检索,管理体验全面升级
资讯动态 • INFINI Labs 小助手 发表了文章 • 0 个评论 • 31 次浏览 • 3 小时前
INFINI Easysearch 2.4.0 正式发布。本版本将向量搜索纳入内核:基于 Lucene 的原生 HNSW,关键词与语义向量可混合检索。控制台新增可视化 Mapping 编辑器,集群设置可同时查看临时、持久、默认三层配置。生命周期策略、可搜索快照、密钥库与插件管理同步更新,高并发下的字段使用统计和磁盘用量分析也更稳定。
主要更新如下:
功能特性 (Features)
原生 HNSW 向量搜索与混合检索
- 内置基于 Lucene 的 HNSW 向量索引。新建索引可直接使用
dense_vector、query-levelknn和顶层knn,无需安装 k-NN 插件。 - 支持 1~4096 维
float向量,以及cosine、dot_product、l2_norm、max_inner_product四种相似度算法。 - 支持通过
m、ef_construction和num_candidates调整索引构建与查询效果;省略index_options时默认使用hnsw(m=16, ef_construction=100)。 - 支持一个顶层关键词
query与一个顶层knn并列执行,通过结果并集与加权评分实现关键词、语义向量的混合召回。 - 兼容 Elasticsearch 8.19.17 的 float HNSW mapping、Bulk、kNN 查询和 wire 行为,以及 Elasticsearch Java 8.19.17、Python 8.19.3 官方客户端,现有应用可直接对接。
更多用法及兼容边界请参阅原生 HNSW 搜索文档。
可视化 Mapping 编辑器
新增索引页提供可视化 Mapping 编辑器。字段按层级排列成树,可直接编辑类型和参数,无需手写 Mapping JSON。
- 可以从索引模板或已有索引导入配置。创建索引时,也可以关联集群里已有的别名。
- 覆盖全部字段类型。支持多字段,也可为
object/nested添加子字段,同类型字段可批量添加。 - 可视化编辑与 JSON 编辑可随时切换,内容保持同步。
dynamic_templates、_source、_meta等高级内容在切换后仍会保留。
操作步骤见新增索引。
集群设置页
在「设置」中打开集群设置页,查看和修改 _cluster/settings 中的动态配置。页面按节点、索引、分片、断路器、生命周期分组,支持按名称或 key 搜索,也可按临时、持久、默认来源过滤。
- 每个设置有三层值:临时、持久、默认。优先级是临时 > 持久 > 默认。徽标标出当前生效的那一层。
- 布尔和枚举使用下拉框,数字使用数字输入,时间、大小等带单位的值直接填写,例如
60s、40mb。临时层与持久层可一次保存。支持清除单层,也可一键清空全部临时设置。 - 日志级别、分片分配属性、断路器等名称不固定的设置,可先添加实例,再填写取值。
操作步骤见集群设置。
数据管理与分析体验
- 数据探索改用 PIT(Point in Time)分页导出,导出数量不再受
max_result_window限制。 - 生命周期策略编辑器可配置的 action 更多,未填写的字段保持原有语义。
- 快照恢复支持直接恢复为可搜索快照,索引列表增加可搜索快照标识。
- 节点页面新增密钥库管理,插件列表支持从文件夹或 ZIP 包手动上传插件。这两项需先在右上角连接 Agent 后使用。
- 创建 API Token 或角色时,索引权限支持下拉选择和搜索。
rate聚合新增sum、value_count计算模式,并支持在包含单一日期源的composite聚合中计算速率。- DevTools 现支持 SQL 关键词高亮、补全和多行语句解析,查询结果默认返回 CSV。
- 生命周期(ILM)策略管理: 对生命周期策略编辑 UI 进行了全面增强,新建与编辑策略现已支持完整的 action 配置,覆盖 Hot、Warm、Cold、Delete 四个阶段
改进优化 (Improvements)
- 重构
_disk_usage同步分析链路,引入有界请求调度和独立线程池,降低并发磁盘用量分析对普通分析请求的影响。 - 重构
_field_usage_stats的 shard 级字段访问采集链路,按每次查询会话对相同字段和访问类型去重,完善 stored fields、term vectors、can-match、refresh/reopen 及主副分片场景的统计覆盖。 - 优化字段使用统计在高并发查询和大字段 registry 场景下的会话提交与快照生成,减少处理开销和临时对象分配。
问题修复 (Bug Fixes)
- 统一重构 Model Provider、Rules 与 Audit Log 的受保护内部索引权限过滤机制,修复直连、通配符、混合索引及数据流后备索引等场景下过滤语义不一致的问题;无权限用户直接访问受保护资源时会被拒绝,在混合或通配符请求中则隐藏相关资源,同时保留远程索引表达式和 Audit Log 的角色授权语义。
- 修复 Remote Reindex 对远端 Elasticsearch REST 协议版本判断不准确的问题,恢复 Elasticsearch 6.8.x、7.x 和 8.x 场景下 scroll 与 clear-scroll 请求的正确格式。
- 修复删除关联多个索引的别名失败的问题。
- 修复授权弹窗打开后「授权提示」页签可能自动消失的问题。
- 修复未授权状态显示为不规范英文的问题,现按界面语言显示「未授权 / Unlicensed」。
- 修复创建用户、角色、管道、模板、远程集群、快照仓库、自动跟随模式、规则库时重名可能覆盖已有配置的问题,现在会提示名称已存在。
- 修复编辑管道时可修改名称导致旧管道残留的问题,编辑时名称改为不可修改。
- 修复删除管道确认弹窗文案误写为「模板」的问题。
- 修复列表页左侧聚合过滤侧边栏输入关键字后无法筛选的问题。
- 修复分片列表点击刷新不重新加载数据的问题。
- 修复热点线程页面选择不支持的 gpu/mem 类型后列表为空且无提示的问题,下拉现仅提供受支持的类型。
- 修复创建角色无法选择粗粒度 action group,以及集群权限与索引权限被强制必填的问题。
- 修复数据探索导出超过 10000 条文档失败的问题。
- 移除生命周期策略编辑器中错误的节点标签缺失实时提醒。
- 修复节点详情插件页显示集群级安装状态的问题:插件只装在部分节点时,未安装的节点也会显示「已安装」;现在按当前节点过滤。
- 修复删除生命周期策略时确认弹窗不显示策略名的问题。
- 修复删除快照确认弹窗误用「策略」且不显示快照名的问题。
- 修复创建生命周期策略时前端重名校验不生效的问题。
升级提示
- 原生 HNSW 的已索引
dense_vector字段只能添加到由 2.4.0 或更高版本创建的索引,且所有数据节点均需升级到 2.4.0 或更高版本;旧索引需新建目标索引后通过 Reindex 迁移。 - 旧 k-NN 插件的
knn_dense_float_vector、knn_sparse_bool_vector和knn_nearest_neighbors接口继续保留,但新旧字段与查询语法不能混用。 - Easysearch 2.4.0 使用未量化的 float HNSW,当前不支持
int8_hnsw等量化向量类型。通过 Elasticsearch 8.19 官方客户端访问时,需在所有节点设置elasticsearch.api_compatibility: true和elasticsearch.api_compatibility_version: "8.19.17",并重启节点。
以上为本版本重点更新摘要,完整变更与技术细节请查看 Easysearch 产品 Release Notes 或联系我们的技术支持团队
获取新版本
INFINI Easysearch v2.4.0 已正式发布,欢迎升级体验:
- 下载地址:https://infinilabs.cn/download/
- 快速开始:https://docs.infinilabs.com/easysearch/main/docs/quick-start/
关于 Easysearch
INFINI Easysearch 是一款分布式搜索引擎,支持结构化和非结构化的数据检索、全文检索、向量检索、空间地理位置信息检索、组合查询、多语种支持、语义分析和聚合分析等多种功能。
Easysearch 基于 Lucene 构建,紧跟 Lucene 最新版本持续迭代更新,采用商用友好协议,企业可自由部署、二次开发和商业化,无协议合规风险。
Easysearch 致力于为企业提供轻量、安全、自主可控的搜索平台,不断完善产品能力,满足更多企业级需求。
【搜索客社区日报】第2274期 (2026-07-27)
社区日报 • Muses 发表了文章 • 0 个评论 • 1543 次浏览 • 3 天前
【搜索客社区日报】第2296期 (2026-09-07)
社区日报 • Muses 发表了文章 • 0 个评论 • 6480 次浏览 • 2026-09-07 14:40
INFINI Easysearch 向量搜索实战(二)
向量搜索 • INFINI Labs 小助手 发表了文章 • 0 个评论 • 10043 次浏览 • 2026-08-09 12:39
上回 我们通过 Ingest Pipeline 把数据在写入 Easysearch 的过程中自动转换成了向量,这次我们通过 Search Pipeline 实现查询时将查询内容转换成向量并进行查询。
Embedding 服务
这里要保持与写入时使用的模型一致。
实战
我们实战演示分为以下几个步骤:
- 建立 Search Pipeline
- 设置索引默认 Pipeline
- 数据查询
建立 Search Pipeline
PUT /_search/pipeline/default_model_pipeline
{
  "rewrite_processors": [
    {
      "semantic_query_enricher" : {
        "description": "Sets the default embedding model",
        "url": "https://dashscope.aliyuncs.com/compatible-mode/v1/embeddings",
        "vendor": "openai",
        "api_key": "<api_key>",
        "default_model_id": "text-embedding-v4",
        "vector_field_model_id": {
           "text_vector": "text-embedding-v4"
        }
      }
    }
  ]
}
设置索引默认 Pipeline
为了方便查询,不用每次查询都指定 Pipeline,我们设置默认值。
PUT /my-index/_settings
{
  "index.search.default_pipeline" : "default_model_pipeline"
}
数据查询
使用上次写入的数据进行查询测试,但不直接查询原来的文本内容。
GET /my-index/_search
{
  "_source": "input_text",
  "query": {
    "semantic": {
      "text_vector": {
        "query_text": "非常先进高级的生产车间",
        "candidates": 100,
        "query_strategy": "LSH_COSINE"
      }
    }
  }
}参数解释请查看文档。
OK,从上面可以看到,我们没有直接搜索原文本中的内容或关键字,但还是通过文本的语义检索到了相关内容。
关于 Easysearch
INFINI Easysearch 是一款分布式搜索引擎,支持结构化和非结构化的数据检索、全文检索、向量检索、空间地理位置信息检索、组合查询、多语种支持、语义分析和聚合分析等多种功能。
Easysearch 基于 Lucene 构建,紧跟 Lucene 最新版本持续迭代更新,采用商用友好协议,企业可自由部署、二次开发和商业化,无协议合规风险。
Easysearch 致力于为企业提供轻量、安全、自主可控的搜索平台,不断完善产品能力,满足更多企业级需求。
相关文章:
INFINI Easysearch 向量搜索实战(一)
向量搜索 • INFINI Labs 小助手 发表了文章 • 0 个评论 • 9486 次浏览 • 2026-08-09 12:35
Easysearch 提供了强大的向量搜索能力,打破传统关键词匹配的局限,实现真正的“懂你”的语义搜索。助力企业快速构建智能推荐、图像识别和内容理解等 AI 应用,释放数据深层价值。
核心能力
| 能力 | 说明 |
|---|---|
| 两种向量类型 | 稠密浮点向量(knn_dense_float_vector)和稀疏布尔向量(knn_sparse_bool_vector) |
| 多种索引模型 | lsh(局部敏感哈希,近似搜索)、permutation_lsh(置换 LSH)、sparse_indexed(倒排索引)、exact(精确搜索) |
| 多种相似度 | cosine(余弦)、l1(曼哈顿距离)、l2(欧氏距离)、jaccard、hamming |
| 与全文搜索融合 | 向量字段与文本字段存储在同一索引,支持 Hybrid 混合检索 |
| function_score 集成 | 向量相似度可作为 function_score 的评分函数 |
典型应用场景
- 语义搜索:文本通过 Embedding 模型转为向量,按语义相似度检索
- RAG 检索增强生成:为大语言模型提供知识库检索能力
- 推荐系统:用户/商品特征向量的相似推荐
- 图像/多模态搜索:图像特征向量的相似检索
- 去重与异常检测:通过向量距离判断内容相似度
Embedding 服务
在使用向量搜索前,先要准备一个 Embedding 模型,支持与 OpenAI API 兼容的 embedding 接口和 Ollama embedding 接口。本文使用阿里云上的 Embedding 模型进行演示。
写入方法
方法一:写入链路嵌入(推荐)
在数据写入 Easysearch 时,通过 Ingest Pipeline 自动调用 Embedding 服务:
应用写数据 → Easysearch → Ingest Pipeline → 调用 Embedding API → 写入向量字段
优势是写入后即可搜索,无需维护外部向量化流程。需要确保集群应至少有一个节点拥有 ingest 角色。
方法二:离线批处理
在应用侧完成向量化,再将向量字段直接写入 Easysearch:
原始数据 → 应用 → 调用模型 Embedding API → 写入 Easysearch(含向量字段)
参考文档。
实战
我们实战演示模式一,分为以下几个步骤:
- 建立带有向量字段的索引
- 创建对应的 Ingest Pipeline
- 写入数据到索引
1. 建立带有向量字段的索引
先建立一个带向量字段的索引,注意 dims 要与向量模型的输出匹配。
PUT /my-index
{
  "mappings": {
    "properties": {
      "text_vector": {
        "type": "knn_dense_float_vector",
        "knn": {
          "dims": 1024,
          "model": "lsh",
          "similarity": "cosine",
          "L": 99,
          "k": 1
        }
      }
    }
  }
}
2. 创建对应的 Ingest Pipeline
写入数据前先建立 Ingest Pipeline,注意 vendor 必须根据使用的模型来指定,比如本文使用的是阿里云 text-embedding-v4 模型,该模型提供了 OpenAI 格式的 API 接口,这里 vendor 我们就写 openai。
PUT _ingest/pipeline/text-embedding-pipeline
{
  "description": "用于生成文本嵌入向量的管道",
  "processors": [
    {
      "text_embedding": {
        "url": "https://dashscope.aliyuncs.com/compatible-mode/v1/embeddings",
        "vendor": "openai",
        "api_key": "xxxxxx",
        "text_field": "input_text",
        "vector_field": "text_vector",
        "model_id": "text-embedding-v4",
        "dims": 1024,
        "ignore_missing": false,
        "ignore_failure": false
      }
    }
  ]
}
text_field:指定原始文本字段,Pipeline 会将该字段的内容转换成向量。
vector_field:指定向量存储的字段,保存上面转换的向量。
3. 写入数据
POST /_bulk?pipeline=text-embedding-pipeline&pretty
{"index": {"_index": "my-index", "_id": "1"}}
{"input_text": "苹果发布了新款iPhone 15 Pro手机,搭载A17芯片"}
{"index": {"_index": "my-index", "_id": "2"}}
{"input_text": "特斯拉宣布将在上海建第二座超级工厂"}
{"index": {"_index": "my-index", "_id": "3"}}
{"input_text": "今天天气真好,阳光明媚适合去公园散步"}
{"index": {"_index": "my-index", "_id": "4"}}
{"input_text": "程序员用Python写了一个自动化数据清洗脚本"}
{"index": {"_index": "my-index", "_id": "5"}}
{"input_text": "故宫博物院推出了夏季特展,展出珍贵文物"}
{"index": {"_index": "my-index", "_id": "6"}}
{"input_text": "小明每天坚持跑步五公里,身体越来越健康"}
{"index": {"_index": "my-index", "_id": "7"}}
{"input_text": "人工智能大模型在自然语言处理领域取得突破"}
{"index": {"_index": "my-index", "_id": "8"}}
{"input_text": "这家咖啡店的拿铁口感丝滑,推荐给咖啡爱好者"}
{"index": {"_index": "my-index", "_id": "9"}}
{"input_text": "量子计算机有望在药物研发中发挥重要作用"}
{"index": {"_index": "my-index", "_id": "10"}}
{"input_text": "周末和朋友一起去爬山,山顶的风景美极了"}
4. 检查数据
搜索索引数据,看看是否成功转换成了向量。可以看到原始数据保存在 input_text 字段中,其向量保存到了 text_vector。
OK,下一步我们看看怎么方便地实现向量搜索。
关于 Easysearch
INFINI Easysearch 是一款分布式搜索引擎,支持结构化和非结构化的数据检索、全文检索、向量检索、空间地理位置信息检索、组合查询、多语种支持、语义分析和聚合分析等多种功能。
Easysearch 基于 Lucene 构建,紧跟 Lucene 最新版本持续迭代更新,采用商用友好协议,企业可自由部署、二次开发和商业化,无协议合规风险。
Easysearch 致力于为企业提供轻量、安全、自主可控的搜索平台,不断完善产品能力,满足更多企业级需求。
相关文章:
INFINI Easysearch 向量搜索实战(一)
Easysearch • INFINI Labs 小助手 发表了文章 • 0 个评论 • 14003 次浏览 • 2026-07-18 19:38
Easysearch 提供了强大的向量搜索能力,打破传统关键词匹配的局限,实现真正的“懂你”的语义搜索。助力企业快速构建智能推荐、图像识别和内容理解等 AI 应用,释放数据深层价值。
核心能力
| 能力 | 说明 |
|---|---|
| 两种向量类型 | 稠密浮点向量(knn_dense_float_vector)和稀疏布尔向量(knn_sparse_bool_vector) |
| 多种索引模型 | lsh(局部敏感哈希,近似搜索)、permutation_lsh(置换 LSH)、sparse_indexed(倒排索引)、exact(精确搜索) |
| 多种相似度 | cosine(余弦)、l1(曼哈顿距离)、l2(欧氏距离)、jaccard、hamming |
| 与全文搜索融合 | 向量字段与文本字段存储在同一索引,支持 Hybrid 混合检索 |
| function_score 集成 | 向量相似度可作为 function_score 的评分函数 |
典型应用场景
- 语义搜索:文本通过 Embedding 模型转为向量,按语义相似度检索
- RAG 检索增强生成:为大语言模型提供知识库检索能力
- 推荐系统:用户/商品特征向量的相似推荐
- 图像/多模态搜索:图像特征向量的相似检索
- 去重与异常检测:通过向量距离判断内容相似度
Embedding 服务
在使用向量搜索前,先要准备一个 Embedding 模型,支持与 OpenAI API 兼容的 embedding 接口和 Ollama embedding 接口。本文使用阿里云上的 Embedding 模型进行演示。
写入方法
方法一:写入链路嵌入(推荐)
在数据写入 Easysearch 时,通过 Ingest Pipeline 自动调用 Embedding 服务:
应用写数据 → Easysearch → Ingest Pipeline → 调用 Embedding API → 写入向量字段
优势是写入后即可搜索,无需维护外部向量化流程。需要确保集群应至少有一个节点拥有 ingest 角色。
方法二:离线批处理
在应用侧完成向量化,再将向量字段直接写入 Easysearch:
原始数据 → 应用 → 调用模型 Embedding API → 写入 Easysearch(含向量字段)
参考文档。
实战
我们实战演示模式一,分为以下几个步骤:
- 建立带有向量字段的索引
- 创建对应的 Ingest Pipeline
- 写入数据到索引
1. 建立带有向量字段的索引
先建立一个带向量字段的索引,注意 dims 要与向量模型的输出匹配。
PUT /my-index
{
  "mappings": {
    "properties": {
      "text_vector": {
        "type": "knn_dense_float_vector",
        "knn": {
          "dims": 1024,
          "model": "lsh",
          "similarity": "cosine",
          "L": 99,
          "k": 1
        }
      }
    }
  }
}
2. 创建对应的 Ingest Pipeline
写入数据前先建立 Ingest Pipeline,注意 vendor 必须根据使用的模型来指定,比如本文使用的是阿里云 text-embedding-v4 模型,该模型提供了 OpenAI 格式的 API 接口,这里 vendor 我们就写 openai。
PUT _ingest/pipeline/text-embedding-pipeline
{
  "description": "用于生成文本嵌入向量的管道",
  "processors": [
    {
      "text_embedding": {
        "url": "https://dashscope.aliyuncs.com/compatible-mode/v1/embeddings",
        "vendor": "openai",
        "api_key": "xxxxxx",
        "text_field": "input_text",
        "vector_field": "text_vector",
        "model_id": "text-embedding-v4",
        "dims": 1024,
        "ignore_missing": false,
        "ignore_failure": false
      }
    }
  ]
}
text_field:指定原始文本字段,Pipeline 会将该字段的内容转换成向量。
vector_field:指定向量存储的字段,保存上面转换的向量。
3. 写入数据
POST /_bulk?pipeline=text-embedding-pipeline&pretty
{"index": {"_index": "my-index", "_id": "1"}}
{"input_text": "苹果发布了新款iPhone 15 Pro手机,搭载A17芯片"}
{"index": {"_index": "my-index", "_id": "2"}}
{"input_text": "特斯拉宣布将在上海建第二座超级工厂"}
{"index": {"_index": "my-index", "_id": "3"}}
{"input_text": "今天天气真好,阳光明媚适合去公园散步"}
{"index": {"_index": "my-index", "_id": "4"}}
{"input_text": "程序员用Python写了一个自动化数据清洗脚本"}
{"index": {"_index": "my-index", "_id": "5"}}
{"input_text": "故宫博物院推出了夏季特展,展出珍贵文物"}
{"index": {"_index": "my-index", "_id": "6"}}
{"input_text": "小明每天坚持跑步五公里,身体越来越健康"}
{"index": {"_index": "my-index", "_id": "7"}}
{"input_text": "人工智能大模型在自然语言处理领域取得突破"}
{"index": {"_index": "my-index", "_id": "8"}}
{"input_text": "这家咖啡店的拿铁口感丝滑,推荐给咖啡爱好者"}
{"index": {"_index": "my-index", "_id": "9"}}
{"input_text": "量子计算机有望在药物研发中发挥重要作用"}
{"index": {"_index": "my-index", "_id": "10"}}
{"input_text": "周末和朋友一起去爬山,山顶的风景美极了"}
4. 检查数据
搜索索引数据,看看是否成功转换成了向量。可以看到原始数据保存在 input_text 字段中,其向量保存到了 text_vector。
OK,下一步我们看看怎么方便地实现向量搜索。
关于 Easysearch
INFINI Easysearch 是一个分布式的搜索型数据库,实现非结构化数据检索、全文检索、向量检索、地理位置信息查询、组合索引查询、多语种支持、聚合分析等。Easysearch 可以完美替代 Elasticsearch,同时添加和完善多项企业级功能。Easysearch 助您拥有简洁、高效、易用的搜索体验。
官网文档:https://docs.infinilabs.com/easysearch
相关文章:
【搜索客社区日报】第1838期 (2024-06-14)
社区日报 • Fred2000 发表了文章 • 0 个评论 • 3327 次浏览 • 2024-06-14 09:18


